← 每日首页
2026-10-19 · 第2轮

二轮巩固 · 经济基础 第23—28章

55 天冲刺计划
6章54页教材289道本章题分段完成,不要求一小时学完全部章节
今日进度0 / 0 项已完
第二轮先回忆,再查漏。 必背、总结和错题优先,薄弱处回看原文。

1重点一览

先花 2 分钟看清这章有几个考点、哪几个是必考,心里有数再读书。

7页教材1个 ★★★1个 ★★2个 ★51道章节题约 56 分钟教材印刷页 207-213
考点一 统计学★
考点二 变量和数据★★
考点三 统计调查★★★
考点四 数据科学与大数据★

2教材标色 + 三色笔记

左边是教材原文,彩色句子就是《考点速记》收了的内容,颜色是星级。右边是速记的考点表,和左边的小节对齐。读一节,看一眼右边的表,再往下走。

一、统计学

教材 P207

在工作和生活中,人们经常面对各种各样的数据,并希望从数据中得出某些结论以帮助决策。统计学就是一门关于数据的学科,它提供了一系列用于收集、处理、分析和解释数据的方法。例如,根据人口普查数据和 1% 人口抽样调查数据推算我国总人口,根据公司的财务数据和商业资料判断公司信用等级,根据电脑寿命的实验数据确定产品免费保修期的长短,根据寿命记录数据确定人寿保险的定价等,这些都是统计学的范畴。概括来讲,统计学是关于收集、整理、分析数据和从数据中得出结论的科学。

统计学有两个分支:描述统计和推断统计。

描述统计是研究数据收集、整理和描述的统计学方法,其内容包括如何取得所需要的数据,如何用图表或数学方法对数据进行整理和展示,如何描述数据的一般性特征。例如,为了解与居民生活相关的商品及服务价格水平的变动情况,收集国家统计局发布的居民消费价格指数(CPI)数据,利用统计图形展示 CPI 的变化,利用增长率计算 CPI 的基本走势。

推断统计是研究如何利用样本数据来推断总体特征的统计学方法,其内容包括参数估计和假设检验两大类。参数估计是利用样本信息推断总体特征;假设检验是利用样本信息判断对总体的假设是否成立。例如,某公司要评测顾客满意度,由于时间、人力和财力等条件的限制不可能对公司所有的顾客进行满意度调查,于是从中随机抽取一部分顾客,调查他们对该公司的质量感知、满意状况和忠诚度等信息,再对公司顾客总体满意度情况进行估计,这就需要用到参数估计方法;然后验证满意度高的顾客更倾向于成为忠诚顾客,这就是假设检验要解决的问题。

统计学是帮助我们认识周围世界的工具。描述统计和推断统计可以一起发挥作用,具体使用哪种方法取决于要解决的问题。

二、变量和数据

变量是研究对象的属性或特征,它是相对于常数而言的。常数只有一个固定取值,而变量可以有两个或更多个可能的取值。研究对象从不同的角度考察,可以有许多不同的属性或特征,也就有许多变量。比如,研究某个企业,我们可以研究其销售额、注册员工数量、员工受教育水平、所属行业等。当变量的取值是数量时,该变量被称为定量变量或数量变量。例如,企业销售额、注册员工数量等。当变量的取值表现为类别时则被称为分类变量,比如企业所属行业。当变量的取值表现为类别且具有一定顺序时被称为顺序变量,比如员工受教育水平。分类变量和顺序变量统称为定性变量。

教材 P208

数据是对变量进行测量、观测的结果。例如,对企业销售额的测量可以得到其销售金额数据;对员工受教育水平的观测可以得到员工受教育水平的数据。数据根据需要可以是数值、文字或者图像等形式。分类变量的观测结果称为分类数据,表现为类别,一般用文字来表述,也可用数值代码表示。比如用 1 表示“男性”,用 2 表示“女性”。顺序数据是对顺序变量的观测结果,也表现为类别,一般用文字表述,也可用数值代码表示。比如用 1 表示“硕士及以上”,用 2 表示“本科”,用 3 表示“大专及以下”。数值型数据是对定量变量的观测结果,其取值表现为具体表示大小或多少的数值。对不同类型的数据,可采用不同的统计方法来处理和分析。例如,对分类数据可以计算出各类别的频率,但对其进行加、减、乘或除等数学运算是没有意义的。而数值型数据则可以进行数学运算,比如计算均值和方差等统计量。

三、数据的来源

(一)观测数据和实验数据

统计数据,按其收集方法,可以分为观测数据和实验数据。通过直接调查或测量而收集到的数据,称为观测数据。观测数据是在没有对事物施加任何人为控制因素的条件下得到的,几乎所有与社会经济现象有关的统计数据都是观测数据,如 GDP、CPI、房价等。通过在实验中控制实验对象以及其所处的实验环境收集到的数据,称为实验数据。比如,一种新产品使用寿命的数据,一种新药疗效的数据。自然科学领域的数据大多是实验数据。

(二)一手数据和二手数据

统计数据,就其本身的来源来看,最初都来源于调查或实验。但从使用者的角度看,数据的来源主要有两种:一是直接的调查和科学实验,对使用者来说,这是数据的直接来源,称为直接数据或一手数据;二是别人的调查或实验的数据,对使用者来说,这是数据的间接来源,称为间接数据或二手数据。一手数据的来源主要有两个:一是调查或观察,二是实验。在社会经济领域,统计调查是获得数据的主要方法,也是获得一手数据的重要方式。

四、统计调查

(一)统计调查的概念与分类

统计调查是按照预定的目的和任务,运用科学的统计调查方法,有计划、有组织地收集数据信息资料的过程。调查过程有两个重要特征:首先,调查是一种有计划、有方法、有程序的活动;其次,调查的结果表现为收集到的数据。

统计调查可以按不同标准分类:

1. 按调查对象的范围不同,分为全面调查和非全面调查。全面调查是对构成调查对象的所有单位进行逐一的、无一遗漏的调查,包括全面统计报表和普查。例如,人口普查就要对全国人口无一例外地进行登记调查。又如,经济普查的对象是中华人民共和国境内从事第二、第三产业活动的全部法人单位、产业活动单位和个体经营户。

全面调查由于调查的单位多、组织工作量大,往往需要耗费大量的人力和财力。因此,在不影响实现统计研究目的的条件下,常常采用非全面调查。

非全面调查是对调查对象中的一部分单位进行调查,包括非全面统计报表、抽样调查、重

教材 P209

点调查和典型调查等。例如,为了研究城市居民家庭的生活水平,可以只对一定数量的住户进行调查;为了掌握进出口商品的质量,抽取一部分商品做检验。又如,为了研究出生婴儿的性别比,可以抽选一定数量的医院、保健院,对其出生婴儿进行调查,而不必对全国每一个出生婴儿都进行调查。

2. 按调查登记的时间是否连续,分为连续调查和不连续调查。连续调查是为了观察总体现象在一定时期内(通常是一年内)的数量变化,它要求随着调查对象的发展变化,连续地进行调查登记。例如,工厂的产品生产、原材料的投入、能源的消耗、人口的出生、死亡等,必须在调查期内连续登记,然后再进行加总。可见,连续调查的资料可以说明现象的发展过程,目的是了解现象在一段时期内的总量。

不连续调查是间隔一个相当长的时间(通常是一年以上)所作的调查,一般是为了对总体现象在一定时点上的状态进行研究。例如,生产设备拥有量、耕地面积等,这些指标的数值在短期内变化不大,不需要连续登记,通常是隔一段时间登记其某时刻或某一天的数量。

(二)统计调查的方式

在我国,常用的统计调查的方式有统计报表、普查、抽样调查、重点调查和典型调查。

1. 统计报表。统计报表是目前我国收集统计数据的一种重要方式。统计报表是按照国家有关法规的规定,自上而下地统一布置、自下而上地逐级提供基本统计数据的一种调查方式。统计报表要以一定的原始数据为基础,按照统一的表式、统一的指标、统一的报送时间和报送程序进行填报。

统计报表的类型多样,按调查对象范围的不同可分为全面统计报表和非全面统计报表。全面统计报表要求调查对象中的每一个单位都填报,非全面统计报表只要求调查对象中的一部分单位填报。目前的大多数统计报表都是全面统计报表,按报送周期长短不同可分为日报、月报、季报、年报等;按报表内容和实施范围不同可分为国家的、部门的、地方的统计报表。

2. 普查。普查是为某一特定目的而专门组织的一次性全面调查,如人口普查、经济普查、农业普查等。世界各国一般都定期进行各种普查,以便掌握有关国情国力的基本统计数据。普查是适合特定目的、特定对象的一种调查方式,主要用于了解处于某一时点状态上的社会经济现象的基本全貌,为国家制定有关政策提供依据。普查作为一种特殊的数据收集方式,具有以下几个特点:①普查通常是一次性的或周期性的。由于普查涉及面广、调查单位多,需要耗费大量的人力、物力和财力,通常需要间隔较长的时间,一般每隔 10 年或 5 年进行一次。经济普查每 10 年进行两次,分别在每逢年份的末尾数字为“3”和“8”的年份实施。人口普查逢“0”的年份进行,农业普查逢“6”的年份进行,均为每 10 年一次。②普查一般需要规定统一的标准调查时间,以避免调查数据的重复或遗漏,保证普查结果的准确性。例如,我国前四次人口普查的标准时间定为普查年份的 7 月 1 日 0 时,第五次至第七次人口普查的标准时间定为普查年份的 11 月 1 日 0 时,农业普查的标准时间定为普查年份的 1 月 1 日 0 时,第四次全国经济普查的标准时间定为普查年份的 1 月 1 日 0 时。标准时间一般定为调查对象比较集中、相对变动较小的时间。③普查的数据一般比较准确,规范化程度也较高,因此,它可以为抽样调查或其他调查提供基本依据。④普查的适用范围比较窄,只能调查一些最基本及特定的现象。

3. 抽样调查。抽样调查是从调查对象的总体中抽取一部分单位作为样本进行调查,并根

教材 P210

据样本调查结果来推断总体数量特征的一种非全面调查。

抽样调查具有以下几个特点:①经济性。这是抽样调查的一个最显著优点。由于调查的样本单位通常是总体单位中的很小一部分,调查的工作量小,因而可以节省大量的人力、物力、财力和时间。②时效性强。抽样调查可以迅速、及时地获得所需要的信息。由于工作量小,调查的准备时间、调查时间、数据处理时间等都可以大大缩短,从而提高数据的时效性。与普查等全面调查相比,抽样调查可以频繁地进行,随着事物的发生和发展及时取得有关信息,以弥补普查等全面调查的不足。例如,在两次人口普查之间各年份的人口数据都是通过抽样调查取得的。③适应面广。抽样调查可以获得更广泛的信息,它适用于对各个领域、各种问题的调查。从适用的范围和问题来看,抽样调查可用于调查全面调查能够调查的现象,也能调查全面调查所不能调查的现象,特别适合对一些特殊现象的调查,如产品质量检验、农产品实验、医药的临床试验等。从调查的项目和指标来看,抽样调查的内容和指标可以更详细、更深入,能获得更全面、更广泛和更深入的数据。④准确性高。抽样调查的数据质量有时比全面调查更高,因为全面调查的工作量大,环节多,登记性(或调查)误差往往很大,而抽样调查由于工作量小,可使各环节的工作做得更细致,误差往往很小。

抽样调查是应用最广泛的一种调查方式和方法,后面将对其进行更为详细的介绍。

4. 重点调查。重点调查是一种非全面调查,它是在所要调查的总体中选择一部分重点单位进行的调查。所选择的重点单位虽然只是全部单位中的一部分,但就调查的标志值来说在总体中占绝大部分比重,调查这一部分单位的情况,能够大致反映被调查对象的基本情况。

重点调查的适用范围很广。当调查目的只要求了解基本状况和发展趋势,不要求掌握全面数据,而调查少数重点单位就能满足需要时,采用重点调查就比较适宜。

例如,为了及时了解全国城市零售物价的变动趋势,就可以对全国 35 个大中型城市的零售物价的变化进行调查,这种调查就是重点调查。

又如,要及时了解全国工业企业的增加值和资产总额情况,只需对全国大中型工业企业进行重点调查即可。因为虽然大中型工业企业数占全国工业企业数不到 5%,但是这些大中型企业的增加值和资产总额却均占全国工业的 60% 以上。

重点调查能以较少的投入、较快的速度取得某些现象主要标志的基本情况或变动趋势。我国有一些重点调查已列入定期报表制度,以便及时取得必要的资料。例如,国家统计局的全国 5000 家工业企业联网直报制度。

5. 典型调查。典型调查是一种非全面调查,它是根据调查的目的与要求,在对被调查对象进行全面分析的基础上,有意识地选择若干具有典型意义的或有代表性的单位进行的调查。

典型调查的主要作用有:①通过对典型单位深入细致的调查,可以及时发现新情况、新问题;②在一定条件下可以验证全面调查数据的真实性。例如,在一次重大普查之后,可以选择若干个典型单位,检查统计数据的准确程度。

典型调查与其他调查方法比较,具有灵活机动、通过少数典型单位即可取得深入翔实的统计资料的优点。典型调查虽然不是统计活动所特有的方法,但从统计活动的全过程来说,它是一种必不可少的方法。在统计活动中运用典型调查的方法,一般来说主要不在于反映现象的总体数量特征,而在于了解与统计数字有关的生动的具体情况,即与现象数量有关的社会条件及其相互联系,以便进行深入的统计分析,做到定性分析与定量分析相结合。

教材 P211

但是,这种调查由于受“有意识地选出若干有代表性单位”的限制,在很大程度上受到人们主观认识的影响。如果调查者对情况相当熟悉,研究问题的态度比较客观,深入调查研究的作风比较好,便可以使典型调查运用得当,取得好的效果;反之,可能会产生较大偏差。因此,必须同其他调查结合起来使用,才能避免出现片面性。

(三)统计质量评价标准

国家统计局制定的《国家统计质量保证框架(2021)》针对统计数据生产全过程,从真实性、准确性、完整性、及时性、适用性、经济性、可比性、协调性和可获得性九个方面,确定了统计数据的质量评价标准。

1. 真实性,要求统计源头数据必须符合统计调查对象的实际情况,确保统计数据有依据、可溯源。侧重于对基础数据质量的评价。

2. 准确性,要求统计数据的误差必须控制在允许范围内,能够为形势判断、政策制定、宏观调控等提供可靠依据。侧重于对统计数据生产科学性的评价。

3. 完整性,要求统计数据应当全面完整,统计范围不重不漏,统计口径完备无缺。侧重于对统计数据全面系统反映客观实际程度的评价。

4. 及时性,要求统计数据生产应当在符合统计科学规律的前提下,尽可能缩短从调查到公布的时间间隔。侧重于对统计数据生产效率的评价。

5. 适用性,要求统计数据能够最大限度为用户所用,统计指标要紧跟时代发展,切合统计需求。侧重于对统计用户满意度的评价。

6. 经济性,要求统计数据生产应当尽可能降低成本,统计调查、行政记录、大数据等数据资源得到充分利用。侧重于对统计数据成本效益的评价。

7. 可比性,要求统计数据应当连续、可比,不同时间、空间数据生产使用规范统一的统计标准和统计原则。侧重于对统计工作标准化、规范化程度的评价。

8. 协调性,要求统计数据结构严谨、逻辑合理,各总量数据、结构数据相互之间高度匹配。侧重于对统计数据间逻辑关系的评价。

9. 可获得性,要求多渠道、多方式公布统计数据,同时公布相应的统计制度方法,加强数据解读,满足社会需求。侧重于对统计服务质量的评价。

五、数据科学与大数据

在大数据爆发式增长的时代,数据科学这门学科受到越来越多的关注。“数据科学”这个词已有近 60 年历史,最早由丹麦的计算机科学领域先驱彼得·诺尔提出,但是这门学科是新兴的、亟待探索的学科。

(一)数据科学

数据科学(data science)是一门通过系统性研究获取与数据相关的知识体系的学科。数据科学一方面研究数据本身的特性和变化规律,另一方面通过对数据的研究为自然科学和社会科学提供一种新的方法,从而揭示自然界和人类行为的现象和规律。

数据科学研究的是从“数据”整合成“信息”进而组织成“知识”的整个过程,包含对数据进行采集、存储、处理、分析、表现等一系列活动。

数据科学的研究对象是数据,研究目标是获得洞察力和理解力,通过对数据的分析,来解释、预测、洞见和决策,为现实世界服务。数据科学涉及的范围非常广泛,例如统计学、计算机

教材 P212

科学、可视化、人工智能、领域知识等。

(二)大数据

大数据(big data)指无法在一定时间范围内用常规软件工具进行捕捉、管理和处理的数据集合,是需要运用新处理模式才能具有更强的决策力、洞察发现力和流程优化能力的海量、高增长率和多样化的信息资产。

大数据具有“5V”特性:

1. 数据量大(Volume):大数据的起始计量单位是 PB(1024 TB)、EB(1024 PB,约 100 万 TB)或 ZB(1024 EB,约 10 亿 TB),未来甚至会达到 YB(1024 ZB)或 BB(1024 YB)。

2. 数据多样性(Variety):大数据类型繁多,包括网络日志、音频、视频、图片、地理位置等各种结构化、半结构化和非结构化的数据。结构化数据是指存储在数据库里,可以用二维表结构实现表达的数据;非结构化数据是指数据结构不规则或不完整,没有预定义的数据,包括所有格式的办公文档、文本、图片、报表、图像、音频、视频等;半结构化数据是介于完全结构化数据和完全非结构化数据之间的数据,具有一定的结构性,例如员工简历,有的简历只有教育情况,有的简历包括教育、婚姻、户籍、出入境情况等很多信息。

3. 价值密度低(Value):大数据价值密度的高低与数据总量的大小成反比。以视频为例,在连续不间断的监控中,有用数据可能仅有一两秒。原始零散、复杂多样,甚至可能有数据噪声和污染的数据需要经历价值“提纯”才能得出信息、获取知识。

4. 数据的产生和处理速度快(Velocity):大数据的智能化和实时性要求越来越高,对处理速度也有极严格的要求,一般要在秒级时间范围内给出分析结果,超出这个时间数据就可能失去价值,即大数据的处理要符合“1 秒定律”。

5. 真实性(Veracity):大数据来源广泛,采集方式多样,数据中往往存在噪声、偏差、内容不一致、数据缺失或人为错误等各类问题。真实性是数据质量、可信度与准确性的核心要求,需通过数据清洗、数据治理、质量控制等一系列规范手段确保数据可靠,从而为科学决策与深度洞察提供有效支撑。

(三)数据挖掘

数据挖掘(data mining)就是从大量的不完全的、有噪声的、模糊的、随机的实际应用数据中,提取隐藏在其中但又有潜在价值的信息和知识的过程。该定义包含以下几层含义:①数据源必须是真实的、大量的、有噪声的;②发现的是用户感兴趣的知识;③发现的知识是可接受、可理解、可运用的;④并不要求发现放之四海而皆准的知识,仅支持特定的发现问题。

在大数据时代,要从海量、多样、价值密度低的大数据中快速发现隐含在其中的有价值的信息和知识,数据挖掘的方法研究至关重要。数据挖掘以解决实际问题为出发点,融合了多学科领域的知识,核心任务是对数据关系和特征进行探索。常见的数据挖掘方法可分为监督学习、无监督学习和半监督学习。

(1)监督学习的数据集中,每个观测单位既有自变量(特征 x_i),又有因变量(标签 y_i)。根据已有的数据集,训练出模型可以根据自变量数据得到因变量预测结果的过程称为监督学习。模型学习的好坏可以根据因变量的实际值和预测值之间的差异判断。监督学习中有两大类典型任务:分类和回归。分类是通过特征变量确定观测单位所属的类别,因变量是分类变量。例如,根据用户的满意度、财务信息判断用户合约到期后是否会续约,根据发件人、主题、内容等信息判断邮件是否为垃圾邮件。常用的分类方法有逻辑斯特回归、决策树、随机森林和支持向量机等。回归是通过特征变量确定观测单位因变量的取值,因变量是定量变量。例如,根据钻

教材 P213

石的克拉数、颜色、切割工艺等信息预测钻石的价格,根据房屋面积、位置、楼层等信息预测房价。常用的回归方法包括线性回归、非线性回归、分位数回归等传统模型。随着深度学习的发展,集成学习、神经网络等方法在复杂高维数据的分类和回归中也被广泛应用。

(2)无监督学习的数据集中,每个观测单位只有自变量(特征 x_i)没有因变量(标签 y_i)。无监督学习的主要任务是探索数据之间的内在联系和结构。无监督学习中有两大类典型任务:聚类和降维。聚类是指把一组数据按照差异性和相似性分为几个类别,使得同类的数据相似性尽可能大,不同类的数据相似性尽可能小,跨类的数据关联性尽可能低。聚类分析常用于客户细分、文本归类、结构分组、行为跟踪等。与分类不同,聚类要划分的类是未知的,聚类是根据观察学习来确定数据之间的关系,因此是一种无监督学习。常用的聚类方法包括基于划分的方法(例如 k 均值聚类算法)、基于分层的方法、基于密度的方法、基于网格的方法和基于模型的方法。降维是指在不损失过多信息的前提下将 N 个相关的特征降为 k 个不相关的特征(其中 k < N),使其具有更好的解释性,因此降维也称为特征提取。例如,根据客户的能力、品格、担保、资本、环境等特征评价客户的信用等级。常用的降维方法包括主成分分析法、因子分析法等。

(3)半监督学习是监督学习与无监督学习相结合的一种学习方法。半监督学习的数据集中,一部分观测单位既有自变量(特征 x_i)又有因变量(标签 y_i),另一部分观测单位只有自变量(特征 x_i)没有因变量(标签 y_i),而且没有标签的观测单位数量远大于有标签的观测单位数量。半监督学习的成本低于监督学习,准确性又高于无监督学习。因此,半监督学习越来越受到人们的重视。常见的半监督学习有半监督分类、半监督回归、半监督聚类。

3必背

这些是必须背下来的。先遮住右边一列,看左边考点名,自己说出内容,说不出来的做记号。

经济基础 第23章 统计与数据科学 必背

红 ★★★ 必考

考点必背内容
统计调查的概念按预定目的和任务,运用科学的统计调查方法,有计划、有组织地收集数据信息资料的过程
按调查对象范围分全面调查(全面统计报表 + 普查,例:人口普查、经济普查);非全面调查(非全面统计报表 + 抽样调查 + 重点调查 + 典型调查)
为什么常用非全面调查全面调查单位多、工作量大、耗人力财力,所以在不影响研究目的的条件下常用非全面调查
按登记时间是否连续分连续调查:一定时期内(通常一年内)连续登记,看发展过程,目的是一段时期的总量(例:产品生产、原材料投入、能源消耗、人口出生死亡);不连续调查:间隔相当长时间(通常一年以上),看某一时点的状态(例:生产设备拥有量、耕地面积)
五种调查方式统计报表、普查、抽样调查、重点调查、典型调查
统计报表按国家法规,自上而下统一布置、自下而上逐级提供基本统计数据;分全面统计报表(每个单位都填报,目前大多数)和非全面统计报表(一部分单位填报)
普查含义为某一特定目的而专门组织的一次性全面调查(人口普查、经济普查、农业普查)
普查四特点一次性或周期性;规定统一的标准调查时间(防重复遗漏);数据准确、规范化程度高;适用范围窄,只能查最基本及特定的现象
普查年份经济普查逢 3、8(每 10 年两次);人口普查逢 0;农业普查逢 6;均每 10 年一次
抽样调查含义从总体中抽取一部分单位作为样本调查,根据样本结果推断总体数量特征的非全面调查;应用最广泛
抽样调查四特点口诀「经时适准」:经济性(最显著优点)、时效性强、适应面广、准确性高
重点调查含义非全面调查,选一部分重点单位,重点单位的标志值在总体中占绝大比重,能大致反映基本情况
重点调查特点适用范围广、投入较少、速度较快(例:35 个大中城市零售物价、5000 家工业企业联网直报)
典型调查含义非全面调查,在全面分析基础上有意识地选择若干典型或有代表性的单位进行调查
典型调查特点灵活机动、少数典型单位即可取得深入翔实资料;受主观认识影响,须结合其他调查使用,避免片面性
统计质量评价标准九条口诀「真准全、及适经、比协获」:真实性、准确性、完整性、及时性、适用性、经济性、可比性、协调性、可获得性(《国家统计质量保证框架(2021)》)

黄 ★★ 重点

考点必背内容
变量定义研究对象的属性或特征,相对于常数而言,可以有两个或更多个可能的取值
变量三分类定量变量(数量变量):取值是数量,例销售额、员工数;分类变量:取值是类别,例所属行业;顺序变量:类别且有顺序,例受教育水平
数据含义对变量进行测量、观测的结果,可以是数值、文字或图像等形式
数据三分类分类数据(1 = 男、2 = 女);顺序数据(1 = 硕士及以上、2 = 本科、3 = 大专及以下);数值型数据(能做数学运算,算均值方差)
按收集方法分观测数据:直接调查或测量,无人为控制,社会经济数据几乎都是,例 GDP、CPI、房价;实验数据:控制实验对象和环境,例新产品寿命、新药疗效,自然科学数据大多是
按数据本身来源分一手数据:直接的调查和科学实验;二手数据:别人的调查或实验的数据

绿 ★ 会考数字与分类

考点必背内容
统计学定义关于收集、整理、分析数据和从数据中得出结论的科学
统计学两分支描述统计(收集、整理、描述数据);推断统计(用样本推断总体,分参数估计和假设检验两大类)
参数估计 / 假设检验参数估计:用样本信息推断总体特征;假设检验:用样本信息判断对总体的假设是否成立
数据科学通过系统性研究获取与数据相关的知识体系的学科;研究对象是数据
大数据无法在一定时间内用常规软件工具捕捉、管理和处理的数据集合
大数据 5V口诀「量多价低快又真」:数据量大(Volume)、数据多样性(Variety)、价值密度低(Value)、产生和处理速度快(Velocity)、真实性(Veracity)
数据挖掘核心任务对数据关系和特征进行探索
数据挖掘三方法监督学习:有特征有标签(分类、回归);无监督学习:只有特征无标签(聚类、降维);半监督学习:部分有标签且无标签的远多于有标签的

数字与公式清单

  • 统计学 2 个分支:描述统计、推断统计;推断统计 2 大类:参数估计、假设检验
  • 变量 3 类:定量、分类、顺序;数据 3 类:数值型、分类、顺序
  • 数据来源 2 组:观测 / 实验(按收集方法);一手 / 二手(按数据本身来源)
  • 统计调查 5 种方式:统计报表、普查、抽样、重点、典型;全面调查包括全面统计报表和普查,非全面调查包括非全面统计报表、抽样、重点、典型
  • 连续调查通常一年内;不连续调查通常一年以上
  • 普查一般每隔 10 年或 5 年一次;经济普查逢 3、8,人口普查逢 0,农业普查逢 6
  • 人口普查标准时间:前四次 7 月 1 日 0 时,第五至七次 11 月 1 日 0 时;农业普查、第四次经济普查 1 月 1 日 0 时
  • 普查 4 特点;抽样调查 4 特点;典型调查 2 作用
  • 重点调查例子:35 个大中城市零售物价;大中型工业企业数不到 5% 但增加值和资产总额占 60% 以上;5000 家工业企业联网直报
  • 统计质量评价标准 9 条(《国家统计质量保证框架(2021)》)
  • 「数据科学」一词近 60 年历史,丹麦彼得·诺尔提出
  • 大数据 5V;计量单位 PB = 1024 TB,EB = 1024 PB,ZB = 1024 EB;「1 秒定律」指处理速度
  • 数据挖掘定义 4 层含义;3 种方法;监督学习 2 任务(分类、回归),无监督学习 2 任务(聚类、降维)

4总结

一页纸看完整章。二轮快刷和考前只看这里和必背。

经济基础 第23章 统计与数据科学 一页纸总结

本章一句话

这章是统计部分的开场,讲三件事:数据是什么(变量和数据的分类、从哪来),数据怎么收(五种统计调查方式,这是全章的大头,★★★),以及数据多到常规工具处理不了时怎么办(数据科学、大数据 5V、数据挖掘三种学习方法)。考试基本都是概念辨析题,背清楚「谁属于谁」就能拿分。

章末总览表

考点星级一句话要点考法
考点一 统计学★统计学 = 收集、整理、分析数据并得结论的科学;两分支:描述统计(收、理、描)和推断统计(用样本推总体,含参数估计和假设检验)单选(辨析描述统计 / 推断统计)
考点二 变量和数据★★变量按取值分定量、分类、顺序三种,数据跟着变量分数值型、分类、顺序三种;来源按收集方法分观测 / 实验,按数据本身来源分一手 / 二手单选、多选(给例子判类型)
考点三 统计调查★★★全面调查包括全面统计报表和普查,非全面调查包括非全面统计报表、抽样、重点、典型;连续(一年内)/ 不连续(一年以上);五种方式各自的含义和特点;普查逢 3、8 / 0 / 6;抽样四特点「经时适准」;九条质量标准「真准全、及适经、比协获」单选、多选(每年必考,给场景判断是哪种调查)
考点四 数据科学与大数据★数据科学研究对象是数据;大数据 5V「量多价低快又真」;数据挖掘核心任务是探索数据关系和特征;监督(有标签)、无监督(无标签)、半监督(部分有标签且无标签占多)单选、多选(5V 和三种学习)

易错坑

  1. 普查是全面调查,抽样、重点、典型都是非全面调查;统计报表大多数是全面的,但也有非全面统计报表。
  2. 重点调查 vs 典型调查:重点调查看「标志值占总体绝大比重」(挑大户),典型调查看「有意识地选有代表性的单位」(挑代表)。题干出现「有意识」就是典型调查。
  3. 连续调查通常「一年内」、看一段时期的总量;不连续调查通常「一年以上」、看某个时点的状态。生产设备拥有量、耕地面积属于不连续调查。
  4. 变量与数据对应别串:受教育水平是顺序变量(顺序数据),所属行业是分类变量(分类数据);用 1、2、3 编码的分类和顺序数据不能做加减乘除。
  5. 大数据的价值密度是「低」不是「高」,与数据总量成反比;分类属于监督学习,聚类属于无监督学习,看有没有标签就能分。

和前后章的关系

本章是第四部分「统计」的第一章,负责铺垫概念:什么是数据、数据怎么收。第 24 章描述统计接着讲拿到数据后怎么算均值、方差、偏态和相关系数,第 25 章抽样调查会把本章「抽样调查」这一种方式单独展开讲抽样方法和误差,第 26 章回归分析对应本章数据挖掘里「监督学习的回归任务」。本章的「参数估计 / 假设检验」在后面的章节还会再出现,先把名字记住。

5解读(读透版讲义)

哪里没看懂,来这里看大白话讲解。生活例子、考法、坑都在这。可以先读这个再回去读教材。

统计与数据科学(教材原文·OCR)

文字为主,公式/图表以教材扫描为准。配套精华看复习网页。

第二十三章 ”统计与数据科学

一`统 计 学

在工作和生活中,人们经常面对各种各样的数据,并希望从数据中得出某些结论以帮助决
策。统计学就是一门关于数据的学科,它提供了一系列用于收集处理、分析和解释数据的方
法。例如,根据人口普查数据和 1% 人口抽样调查数据推算我国总人口 ,根据公司的财务数据
和商业资料判断公司信用等级,根据电脑寿命的实验数据确定产品免费保修期的长短,根据寿
命记录数据确定人寿保险的定价等,这些都是统计学的范畴。概括来讲,统计学是关于收集、
整理、分析数据和从数据中得出结论的科学。

统计学有两个分支: 描述统计和推断统计。

描述统计是研究数据收集 ,整理和描述的统计学方法,其内容包括如何取得所需要的数
据,如何用图表或数学方法对数据进行整理和展示,如何描述数据的一般性特征。例如,为了
解与居民生活相关的商品及服务价格水平的变动情况,收集国家统计局发布的居民消费价格
指数( CPI)数据,利用统计图形展示 CPI 的变化,利用增长率计算 CPI 的基本走势。

推断统计是研究如何利用样本数据来推断总体特征的统计学方法,其内容包括参数估计
和假设检验两大类。参数估计是利用样本信息推断总体特征; 假设检验是利用样本信息判断
对总体的假设是否成立。例如,某公司要评测顾客满意度,由于时间.人力和财力等条件的限
制不可能对公司所有的顾客进行满意度调查,于是从中随机抽取一部分顾客,调查他们对该公
司的质量感知 满意状况和忠诚度等信息,再对公司顾客总体满意度情况进行估计,这就需要
用到参数估计方法; 然后验证满意度高的顾客更倾向于成为忠诚顾客,这就是假设检验要解决
的问题。

统计学是帮助我们认识周围世界的工具。描述统计和推断统计可以一起发挥作用,具体
使用哪种方法取决于要解决的问题。

汕

二\变量和数据

变量是研究对象的属性或特征,它是相对于常数而言的。常数只有一个固定取值,而变量
可以有两个或更多个可能的取值。研究对象从不同的角度考察,可以有许多不同的属性或特
征,也就有许多变量。比如,研究某个企业 ,我们可以研究其销售额 .注册员工数量`员工受教
育水平 .所属行业等。当变量的取值是数量时,该变量被称为定量变量或数量变量。例如,企
业销售额 .注册员工数量等。当变量的取值表现为类别时则被称为分类变量,比如企业所属行
业。当变量的取值表现为类别且具有一定顺序时被称为顺序变量,比如员工受教育水平。分

四部分 统计

' 208 经济基础知识 (中级)

数据是对变量进行测量,观测的结果。例如,对企业销售额的测量可以得到其销售金额
数据; 对员工受教育水平的观测可以得到员工受教育水平的数据。数据根据需要可以是数
值 文字或者图像等形式。分类变量的观测结果称为分类数据,表现为类别 ,一般用文字来
表述,也可用数值代码表示。比如用 1 表示“男性,用2 表示"女性"。顺序数据是对顺序
变量的观测结果,也表现为类别,一般用文字表述,也可用数值代码表示。比如用 1 表示“硕
士及以上",用2表示 "本科”,用3 表示 “大专及以下"。数值型数据是对定量变量的观测结
果,其取值表现为具体表示大小或多少的数值。对不同类型的数据,可采用不同的统计方法
来处理和分析。例如,对分类数据可以计算出各类别的频率,但对其进行加 ,减,乘或除等
数学运算是没有意义的。而数值型数据则可以进行数学运算, 比如计算均值和方差等统计

星。

( 一 )观测数据和实验数据

统计数据,按其收集方法,可以分为观测数据和实验数据。通过直接调查或测量而收集到
的数据 ,称为观测数据。观测数据是在没有对事物施加任何人为控制因素的条件下得到的,几
乎所有与社会经济现象有关的统计数据都是观测数据,如 GDP、CPI 房价等。通过在实验中
控制实验对象以及其所处的实验环境收集到的数据,称为实验数据。比如,一种新产品使用寿
命的数据,一种新药疗效的数据。自然科学领域的数据大多是实验数据。

( 二 )一手数据和二手数据

统计数据,就其本身的来源来看,最初都来源于调查或实验。但从使用者的角度看,数据
的来源主要有两种: 一是直接的调查和科学实验,对使用者来说,这是数据的直接来源,称为直
接数据或一手数据; 二是别人的调查或实验的数据,对使用者来说,这是数据的间接来源,称为
间接数据或二手数据。一手数据的来源主要有两个: 一是调查或观察,二是实验。在社会经济
领域,统计调查是获得数据的主要方法,也是获得一手数据的重要方式。

四\统 计 调查

( 一 )统计调查的概念与分类

统计调查是按照预定的目的和任务,运用科学的统计调查方法,有计划,有组织地收集数
据信息资料的过程。调查过程有两个重要特征:首先,调查是一种有计划 .有方法有程序的活
动; 其次,调查的结果表现为收集到的数据。

统计调查可以按不同标准分类:

  1. 按调查对象的范围不同,分为全面调查和非全面调查。全面调查是对构成调查对象的

所有单位进行逐一的、无一遗漏的调查,包括全面统计报表和普查。例如,人口普查就要对全
国人口无一例外地进行登记调查。又如,经济普查的对象是中华人民共和国境内从事第二 第
三产业活动的全部法人单位.产业活动单位和个体经营户。

全面调查由于调查的单位多组织工作量大,往往需要耗费大量的人力和财力。因此,在

影响实现统计研究目的的条件下 ,常常采用非全面调查。
非全面调查是对调查对象中的一部分单位进行调查,包括非全面统计报表抽样调查 .重

第二十三章” 统计与数据科学 “209,

点调查和典型调查等。例如 ,为了研究城市居民家庭的生活水平,可以只对一定数量的住户进
行调查; 为了掌握进出口商品的质量,抽取一部分商品做检验。又如,为了研究出生婴儿的性
别比,可以抽选一定数量的医院保健院,对其出生婴儿进行调查 ,而不必对全国每一个出生婴
儿都进行调查。

  1. 按调查登记的时间是否连续,分为连续调查和不连续调查。连续调查是为了观察总体

现象在一定时期内(通常是一年内 ) 的数量变化,它要求随着调查对象的发展变化,连续地进
行调查登记。例如,工厂的产品生产,原材料的投入,能源的消耗,人口的出生、死亡等,必须在
调查期内连续登记,然后再进行加总。可见,连续调查的资料可以说明现象的发展过程,目的
是了解现象在一段时期内的总量。

不连续调查是间隔一个相当长的时间 ( 通常是一年以上 )所作的调查,一般是为了对
总体现象在一定时点上的状态进行研究。例如,生产设备拥有量 .耕地面积等,这些指标的
数值在短期内变化不大,不需要连续登记,通常是隔一段时间登记其某时刻或某一天的数
里。

( 二 )统计调查的方式

在我国,常用的统计调查的方式有统计报表 .普查,抽样调查 .重点调查和典型调查。

  1. 统计报表。统计报表是目前我国收集统计数据的一种重要方式。统计报表是按照国家

有关法规的规定,自上而下地统一布置、自下而上地逐级提供基本统计数据的一种调查方式。
统计报表要以一定的原始数据为基础,按照统一的表式、统一的指标、统一的报送时间和报送
程序进行填报。

统计报表的类型多样,按调查对象范围的不同可分为全面统计报表和非全面统计报表。
全面统计报表要求调查对象中的每一个单位都填报,非全面统计报表只要求调查对象中的
一部分单位填报。目前的大多数统计报表都是全面统计报表,按报送周期长短不同可分为
日报月报.季报、年报等; 按报表内容和实施范围不同可分为国家的、部门的、地方的统计报
表。

  1. 普查。普查是为某一特定目的而专门组织的一次性全面调查,如人口普查经济普查、

农业普查等。世界各国一般都定期进行各种普查,以便掌握有关国情国力的基本统计数据。
普查是适合特定目的特定对象的一种调查方式,主要用于了解处于某一时点状态上的社会
经济现象的基本全貌,为国家制定有关政策提供依据。普查作为一种特殊的数据收集方式,具
有以下几个特点: GD普查通常是一次性的或周期性的。由于普查涉及面广调查单位多,需要
耗费大量的人力 .物力和财力,通常需要间隔较长的时间 ,一般每隔 10 年或 5 年进行一次。经
济普查每 10 年进行两次,分别在每逢年份的末尾数字为“3”和“8” 的年份实施。人口普查
逢“0" 的年份进行,农业普查逢“6" 的年份进行,均为每 10 年一次。@)普查一般需要规定统
一的标准调查时间,以避免调查数据的重复或遗漏,保证普查结果的准确性。例如,我国前四
次人口普查的标准时间定为普查年份的7月 1 日0时,第五次至第七次人口普查的标准时间
定为普查年份的11 月 1 日 0时,农业普查的标准时间定为普查年份的1月 1 日0时,第四次
全国经济普查的标准时间定为普查年份的 1 月 1 日 0 时。标准时间一般定为调查对象比较集
中 相对变动较小的时间。@@普查的数据一般比较准确,规范化程度也较高,因此,它可以为抽
样调查或其他调查提供基本依据。@普查的适用范围比较窄,只能调查一些最基本及特定的
现象。

  1. 抽样调查。抽样调查是从调查对象的总体中抽取一部分单位作为样本进行调查,并根

' 210 .经济基础知识 (中级)

据样本调查结果来推断总体数量特征的一种非全面调查。

抽样调查具有以下几个特点: 四经济性。这是抽样调查的一个最显著优点。由于调
查的样本单位通常是总体单位中的很小一部分,调查的工作量小,因而可以节省大量的人
力、物力.财力和时间。@时效性强。抽样调查可以迅速.及时地获得所需要的信息。由于
工作量小,调查的准备时间、调查时间 .数据处理时间等都可以大大缩短,从而提高数据的
时效性。与普查等全面调查相比,抽样调查可以频繁地进行,随着事物的发生和发展及时
取得有关信息,以弥补普查等全面调查的不足。例如,在两次人口普查之间各年份的人口
数据都是通过抽样调查取得的。图适应面广。抽样调查可以获得更广泛的信息,它适用于
对各个领域.各种问题的调查。从适用的范围和问题来看,抽样调查可用于调查全面调查
能够调查的现象,也能调查全面调查所不能调查的现象,特别适合对一些特殊现象的调查,
如产品质量检验农产品实验、医药的临床试验等。从调查的项目和指标来看,抽样调查的
内容和指标可以更详细,更深入,能获得更全面`更广泛和更深入的数据。@轩准确性高。抽
样调查的数据质量有时比全面调查更高,因为全面调查的工作量大,环节多,登记性(或调
查 ) 误差往往很大, 而抽样调查由于工作量小,可使各环节的工作做得更细致,误差往往
很小。

抽样调查是应用最广泛的一种调查方式和方法 ,后面将对其进行更为详细的介绍。

  1. 重点调查。重点调查是一种非全面调查,它是在所要调查的总体中选择一部分重点单

位进行的调查。所选择的重点单位虽然只是全部单位中的一部分,但就调查的标志值来说在
总体中占绝大部分比重,调查这一部分单位的情况,能够大致反映被调查对象的基本情况。

重点调查的适用范围很广。当调查目的只要求了解基本状况和发展趋势,不要求掌握全
面数据,而调查少数重点单位就能满足需要时,采用重点调查就比较适宜。

例如,为了及时了解全国城市零售物价的变动趋势,就可以对全国 35 个大中型城市的零
售物价的变化进行调查,这种调查就是重点调查。

又如,要及时了解全国工业企业的增加值和资产总额情况,只需对全国大中型工业企业进
行重点调查即可。因为虽然大中型工业企业数占全国工业企业数不到 5%,但是这些大中型企
业的增加值和资产总额却均占全国工业的 60% 以上。

重点调查能以较少的投入、较快的速度取得某些现象主要标志的基本情况或变动趋势。
我国有一些重点调查已列人定期报表制度,以便及时取得必要的资料。例如,国家统计局的全
国 5000 家工业企业联网直报制度。

  1. 典型调查。典型调查是一种非全面调查,它是根据调查的目的与要求,在对被调查对

象进行全面分析的基础上,有意识地选择若干具有典型意义的或有代表性的单位进行的调
查。

典型调查的主要作用有: @通过对典型单位深入细致的调查,可以及时发现新情况 .新问
题; @)在一定条件下可以验证全面调查数据的真实性。例如,在一次重大普查之后,可以选择
若干个典型单位,检查统计数据的准确程度。

典型调查与其他调查方法比较,具有灵活机动 .通过少数典型单位即可取得深入翔实的统
计资料的优点。典型调查虽然不是统计活动所特有的方法,但从统计活动的全过程来说,它是
一种必不可少的方法。在统计活动中运用典型调查的方法,一般来说主要不在于反映现象的
总体数量特征,而在于了解与统计数字有关的生动的具体情况,即与现象数量有关的社会条件
及其相互联系,以便进行深入的统计分析,做到定性分析与定量分析相结合。

第二十三章* 统计与数据科学 ,2171,

但是,这种调查由于受“有意识地选出若干有代表性单位”的限制 ,在很大程度上受到人
们主观认识的影响。如果调查者对情况相当熟悉,研究问题的态度比较客观,深入调查研究的
作风比较好,便可以使典型调查运用得当,取得好的效果; 反之,可能会产生较大偏差。因此,
必须同其他调查结合起来使用,才能避免出现片面性。

( 三 )统计质量评价标准

国家统计局制定的《国家统计质量保证框架( 2021 )》针对统计数据生产全过程,从真实
性、准确性、完整性.及时性.适用性、经济性可比性,协调性和可获得性九个方面,确定了统计
数据的质量评价标准。

  1. 真实性,要求统计源头数据必须符合统计调查对象的实际情况,确保统计数据有依据、

可溯源。侧重于对基础数据质量的评价。

  1. 准确性 ,要求统计数据的误差必须控制在允许范围内,能够为形势判断 .政策制定 宏观

调控等提供可靠依据。侧重于对统计数据生产科学性的评价。

  1. 完整性,要求统计数据应当全面完整,统计范围不重不漏,统计口径完备无缺。侧重于

对统计数据全面系统反映客观实际程度的评价。

  1. 及时性,要求统计数据生产应当在符合统计科学规律的前提下 ,尽可能缩短从调查到公

布的时间间隔。侧重于对统计数据生产效率的评价。

  1. 适用性,要求统计数据能够最大限度为用户所用,统计指标要紧跟时代发展,切合统计

需求。侧重于对统计用户满意度的评价。

  1. 经济性,要求统计数据生产应当尽可能降低成本,统计调查,行政记录 大数据等数据资

源得到充分利用。侧重于对统计数据成本效益的评价。

  1. 可比性,要求统计数据应当连续、可比,不同时间 空间数据生产使用规范统一的统计标

准和统计原则。侧重于对统计工作标准化 ,规范化程度的评价。

8.协调性,要求统计数据结构严谨、.刘辑合理,各总量数据、结构数据相互之间高度匹配。
侧重于对统计数据间逻辑关系的评价。

  1. 可获得性,要求多渠道 .多方式公布统计数据,同时公布相应的统计制度方法,加强数据

解读,满足社会需求。侧重于对统计服务质量的评价。

五,数据科学与大数据

在大数据爆发式增长的时代,数据科学这门学科受到越来越多的关注。 "数据科学”这个
词已有近 60 年历史,最早由丹麦的计算机科学领域先驱彼得诺尔提出,但是这门学科是新
兴的、亚待探索的学科。

( 一 )数据科学

数据科学 (data seience ) 是一门通过系统性研究获取与数据相关的知识体系的学科。数
据科学一方面研究数据本身的特性和变化规律,另一方面通过对数据的研究为自然科学和社
会科学提供一种新的方法,从而揭示自然春和人类行为的现象和规律。

数据科学研究的是从“数据” 整合成“信息”进而组织成“知识”的整个过程,包含对数据
进行采集 存储、处理、分析、表现等一系列活动。

数据科学的研究对象是数据,研究目标是获得洞察力和理解力,通过对数据的分析 ,来解
释 ,预测`.洞见和决策,为现实世界服务。数据科学涉及的范围非常广泛,例如统计学`计算机

“212 经济基础知误 (中级)

科学 可视化.人工智能 、领域知识等。
( 二 )大数据
大数据(big data ) 指无法在一定时间范围内用常规软件工具进行捕捉、管理和处理的数据
合,是需要运用新处理模式才能具有更强的决策力 .洞察发现力和流程优化能力的海量 高
增长率和多样化的信息资产。

大数据具有“5V”特性:

1.数据量大(Volume ) : 大数据的起始计量单位是PB(1024 TB ).EB(1024 PB,约 100
万TB )或ZB(1024EB,约 10亿TB ),未来甚至会达到YB(1024ZB )或BB(1024YB)

  1. 数据多样性(Variety ) : 大数据类型繁多,包括网络日志 .音频视频.图片.地理位置等

各种结构化`半结构化和非结构化的数据。结构化数据是指存储在数据库里,可以用二维表结
构实现表达的数据; 非结构化数据是指数据结构不规则或不完整,没有预定义的数据,包括所
有格式的办公文档\文本,图片报表、图像 音频、视频等; 半结构化数据是介于完全结构化数
据和完全非结构化数据之间的数据,具有一定的结构性,例如员工简历,有的简历只有教育情
况,有的简历包括教育.婚姻 户籍.出人境情况等很多信息。

  1. 价值密度低( Value ) : 大数据价值密度的高低与数据总量的大小成反比。以视频为例,

在连续不间断的监控中,有用数据可能仅有一两秒。原始零散 .复杂多样,甚至可能有数据品
声和污染的数据需要经历价值“提纯”才能得出信息 .获取知识。

  1. 数据的产生和处理速度快( Velocity ) : 大数据的智能化和实时性要求越来越高,对处理

速度也有极严格的要求 ,一般要在秒级时间范围内给出分析结果,超出这个时间数据就可能失
去价值,即大数据的处理要符合“1 秒定律”。

  1. 真实性( Veracity ) : 大数据来源广泛,采集方式多样,数据中往往存在噪声 .偏差.内容

不一致 ,数据缺失或人为错误等各类问题。真实性是数据质量.可信度与准确性的核心要求,
需通过数据清洗数据治理,质量控制等一系列规范手段确保数据可靠,从而为科学决策与深

( 三 )数据挖掘

数据挖掘( data mining ) 就是从大量的不完全的,有噪声的、模糊的.随机的实际应用数据
中,提取隐藏在其中但又有潜在价值的信息和知识的过程。该定义包含以下几层含义:GD数据
源必须是真实的,大量的有噪声的; @发现的是用户感兴趣的知识; 国发现的知识是可接受、
可理解.可运用的; 图并不要求发现放之四海而皆准的知识,仅支持特定的发现问题。

在大数据时代,要从海量多样.价值密度低的大数据中快速发现隐含在其中的有价值的
信息和知识,数据挖掘的方法研究至关重要。数据挖据以解决实际问题为出发点 ,融合了多学
科领域的知识,核心任务是对数据关系和特征进行探索。常见的数据挖掘方法可分为监督学

(1 )监督学习的数据集中,每个观测单位既有自变量( 特征* ),又有因变量( 标签 %) 根
据已有的数据集 ,训练出模型可以根据自变量数据得到因变量预测结果的过程称为监督学习。
模型学习的好坏可以根据因变量的实际值和预测值之间的差异判断。监督学习中有两大类典
型任务: 分类和回归。分类是通过特征变量确定观测单位所属的类别,因变量是分类变量。例
如,根据用户的满意度 ,财务信息判断用户合约到期后是否会续约,根据发件人 .主题,内容等
言息判断邮件是否为垃圾邮件。常用的分类方法有逻辑斯特回归 决策树 .随机森林和支持向
量机等。回归是通过特征变量确定观测单位因变量的取值,因变量是定量变量。例如,根据钻

第二十三章” 统计与数据科学 213

石的克拉数 .颜色 .切割工艺等信息预测钻石的价格,根据房屋面积位置楼层等信息预测房
价。常用的回归方法包括线性回归 ,非线性回归、分位数回归等传统模型。随着深度学习的发
展,集成学习 .神经网络等方法在复杂高维数据的分类和回归中也被广泛应用。

(2 )无监督学习的数据集中,每个观测单位只有自变量( 特征世)没有因变量( 标签六)
无监督学习的主要任务是探索数据之间的内在联系和结构。无监督学习中有两大类典型任
务: 聚类和降维。聚类是指把一组数据按照差异性和相似性分为几个类别,使得同类的数据
相似性尽可能大,不同类的数据相似性尽可能小,跨类的数据关联性尽可能低。聚类分析常用
于客户细分 文本归类结构分组,行为跟踪等。与分类不同,聚类要划分的类是未知的,聚类
是根据观察学习来确定数据之间的关系,因此是一种无监督学习。常用的聚类方法包括基于
划分的方法( 例如大均值聚类算法 )基于分层的方法.基于密度的方法、基于网格的方法和基
于模型的方法。降维是指在不损失过多信息的前提下将 个相关的特征降为上个不相关的
特征(其中大< N),使其具有更好的解释性,因此降维也称为特征提取。例如,根据客户的能
力\唱格 .担保资本、环境等特征评价客户的信用等级。常用的降维方法包括主成分分析法、
因子分析法等。

(3 )半监督学习是监督学习与无监督学习相结合的一种学习方法。半监督学习的数据集
中,一部分观测单位既有自变量( 特征思)又有因变量( 标签思),另一部分观测单位只有自变
量( 特征x )没有因变量(标签思),而且没有标签的观测单位数量远大于有标签的观测单位数
量。半监督学习的成本低于监督学习,准确性又高于无监督学习。因此,半监督学习越来越受
到人们的重视。常见的半监督学习有半监督分类 ,半监督回归 、半监督聚类。


零基础复习卡(两版教材核验)

来源核验:主教材《2026经济基础知识中级原书有色差(371)》PDF 第218-224页;《经济基础知识(中级)-292》PDF 第174-179页(书内第166-171页)。以下为理解性改写,定义与分类以教材为准。

一句话先懂

统计就是把杂乱数据变成可以决策的信息;描述统计回答“样本长什么样”,推断统计回答“能否由样本推总体”。

零基础解释

  1. 统计学两条主线:描述统计负责收集、整理、制图和概括;推断统计利用样本做参数估计或假设检验。
  2. 变量和数据:变量是要观察的特征,数据是观察变量得到的结果。定量变量产生数值型数据;分类变量产生分类数据;有次序的分类变量产生顺序数据。
  3. 数据来源:没有人为控制的是观测数据,有控制实验条件的是实验数据;自己调查或实验得到的是一手数据,使用别人已有资料的是二手数据。
  4. 调查的两组分类:按调查范围分全面调查和非全面调查;按登记时间是否连续分连续调查和不连续调查。普查是一次性全面调查,抽样、重点、典型调查通常是非全面调查。
  5. 数据科学:统计学偏重从数据得出可靠结论;数据科学还综合计算机科学、数学和领域知识,处理规模更大、类型更复杂的数据。
  6. 机器学习:有标签是监督学习,无标签是无监督学习,少量有标签加大量无标签是半监督学习。分类、回归常属监督学习;聚类、降维常属无监督学习。

必背清单

  • 描述统计:取得、整理、展示、概括数据。
  • 推断统计:参数估计、假设检验。
  • 统计数据质量九项:真实性、准确性、完整性、及时性、适用性、经济性、可比性、协调性、可获得性。
  • 大数据“五V”:Volume(量大)、Variety(多样)、Value(价值密度低)、Velocity(速度快)、Veracity(真实性)。
  • 普查:特定目的、一次性、全面;重点调查:重点单位总量占比大;典型调查:有意识选择有代表性的单位。

易混点

  • 分类数据不等于顺序数据:顺序数据能排先后,但类别代码之间不能做有意义的加减乘除。
  • 一手/二手看使用者:同一份原始调查资料,对调查者是一手,对后来引用者是二手。
  • 重点调查不推总体数量,主要掌握基本情况;抽样调查可依据随机原则推断总体。
  • 分类与聚类:分类的类别事先已知,聚类的类别由算法从数据中发现。

记忆口诀

  • 两类统计:“描述看现在,推断猜总体”。
  • 九项质量:“真准全时,适经比协得”。
  • 五V:“量多值低、速度真实”。

自测题(先答后看)

  1. 判断:用1表示男性、2表示女性后,性别就成为数值型数据。

答案:错。 数字只是类别代码,不能进行有意义的数值运算。

  1. 单选:某药企控制剂量和环境观察药效,取得的数据属于( )。A观测数据 B实验数据 C二手数据 D顺序数据

答案:B。 关键是人为控制实验对象或环境。

  1. 单选:为掌握全国人口总量和结构而逐户登记,最典型的方式是( )。A重点调查 B典型调查 C普查 D抽样调查

答案:C。 普查是一次性全面调查。

  1. 判断:没有标签的数据最适合直接做监督分类。

答案:错。 监督学习需要标签;无标签数据常用于聚类、降维等无监督学习。

  1. 多选:大数据“五V”包括( )。A数据量大 B数据类型多 C处理速度快 D价值密度低 E绝对无误差

答案:ABCD。 第五个V是真实性,不是“绝对无误差”。

  1. 简答:抽样调查和重点调查最核心的区别是什么?

答案: 抽样调查强调按抽样原则抽取样本并据此推断总体;重点调查选择在总体总量中占较大比重的重点单位,主要了解基本情况。

6刷题(章节配套练习,含校订与教学改编)

先做后看答案。单选点一下就判,多选选完点「核对答案」。错题自动进错题本,二轮会回来重做。

1. 单项选择题
下列统计处理中,属于描述统计的是()。
A. 利用抽样调查样本数据估计某行业员工薪酬水平B. 利用圆形图展示我国三次产业的构成C. 利用样本统计量估计回归模型中的参数D. 在回归分析中对回归系数进行显著性检验
答案 B 描述统计是研究数据收集、整理和描述的统计学方法,其内容包括如何取得所需要 的数据,如何用图表或数字方法对数据进行整理和展示,如何描述数据的一般性特征。
2. 单项选择题
某公司从年初全部销售人员中随机抽取200人,跟踪记录其本年度是否离职,据此估计全体年初销售人员的年度离职率。所采用的统计方法是()。
A. 参数估计B. 假设检验C. 数据整理D. 数据展示
答案 A 用随机样本中观测到的年度离职比例估计总体年度离职率,属于参数估计。

校勘说明:为使抽样设计、数据来源或实验条件明确而作的校订后教学题设,不冒充原题原文。

3. 单项选择题
某公司随机抽取一批销售人员,记录其工作年限并跟踪未来一年的离职情况,检验“调查时工龄3年以上人员的后续一年离职率低于入职半年人员”的假设,应采用()。
A. 参数估计B. 假设检验C. 数据整理D. 数据展示
答案 B 根据样本的分组离职结果判断总体中两组离职率的大小关系是否成立,属于假设检验。

校勘说明:为使抽样设计、数据来源或实验条件明确而作的校订后教学题设,不冒充原题原文。

4. 单项选择题
下列统计处理中,属于推断统计的是()。
A. 利用圆形图展示人口年龄结构B. 参数估计C. 利用国内生产总值增长率反映经济增长状况D. 利用统计表展示近10年我国工业企业利润变化情况
答案 B 推断统计是研究如何利用样本数据来推断总体特征的统计学方法,其内容包括参数 估计和假设检验两大类。
5. 单项选择题
下列统计处理中,属于推断统计的是( )。
A. 利用抽样调查数据估计居民网络消费倾向B. 采用比率反映人口性别结构C. 利用增长率计算固定资产投资变化情况D. 利用条形图展示某地区产业类型分布
答案 A 推断统计是研究如何利用样本数据来推断总体特征的统计学方法,其内容包括参 数估计和假设检验两大类。选项 B、C、D 属于描述统计。
6. 单项选择题
下列统计处理中,属于推断统计的是()。
A. 利用统计图表展示 GDP 的变化B. 利用增长率描述人均可支配收入的基本走势C. 利用统计表描述公司员工年龄分布D. 利用抽样调查数据估计城镇居民人均消费支出水平
答案 D 推断统计是研究如何利用样本数据来推断总体特征的统计学方法,利用抽样调查 数据估计城镇居民人均消费支出水平属于推断统计。描述统计是研究数据收集、整理和描述 的统计学方法,选项 A、B、C均属于描述统计。
7. 单项选择题
某公司从客户名录中随机抽取1000个客户进行满意度和忠诚度调查, 为了验证客户总体中满意度高的客户更倾向于成为忠诚客户,应采用的统计方法是()。
A. 假设检验B. 参数估计C. 数据整理D. 数据展示
答案 A 假设检验是利用样本信息判断对总体的假设是否成立。例如,某公司要评测顾客 满意度,由于时间、人力和财力等条件的限制不可能对公司所有的顾客进行满意度调查,于是 从中随机抽取一部分顾客,调查对该公司的质量感知、满意状况和忠诚度等信息,再对公司顾 客总体满意度情况进行估计,这就需要用到参数估计方法;然后验证满意度高的客户更倾向于 成为忠诚客户,这就是推断统计要解决的问题。
8. 多项选择题
下列统计方法中,属于描述统计的有()。
A. 用样本信息判断关于总体的假设是否成立B. 利用图形展示数据的变化趋势C. 用数学方法展示数据分布特征D. 用样本均值估计总体均值E. 利用表格展示数据的频数分布
答案 BCE 描述统计是研究数据收集、整理和描述的统计学方法,其内容包括如何取得所需 要的数据,如何用图表或数学方法对数据进行整理和展示,如何描述数据的一般性特征。
9. 多项选择题
下列统计处理中,属于描述统计的有()。
A. 利用折线图展示生产者价格指数的变化B. 利用圆形图展示居民消费支出构成C. 利用增长率计算居民消费价格指数的基本走势D. 在某个城市随机抽取一部分居民住户对该城市居民收入进行估计E. 根据1%人口抽样数据推算我国总人口
答案 ABC 描述统计是研究数据收集、整理和描述的统计学方法,其内容包括如何取得所需 要的数据,如何用图表或数学方法对数据进行整理和展示,如何描述数据的一般性特征。选项 A、B、C属于描述统计,选项 D、E属于推断统计。
10. 单项选择题
下列变量中,属于定量变量的是()。
A. 法律部门B. 城市人口C. 所属行业D. 会计要素
答案 B 本题考查定量变量。当变量的取值是数量时,该变量称为定量变量或数量变量,例 如企业销售额、注册员工数量、天然气产量等。
11. 单项选择题
下列统计变量中,属于定量变量的是()。
A. 天然气产量B. 产品类别C. 产品质量等级D. 外语水平等级
答案 A 天然气产量的取值表示数量,属于定量变量;产品类别为分类变量,质量及外语水平等级为顺序变量。
12. 单项选择题
下列变量中,属于分类变量的是()。
A. 销售收入B. 员工数量C. 汽车产量D. 所属行业
答案 D 本题考查分类变量。当变量的取值是类别时被称为分类变量,比如企业所属行业。
13. 单项选择题
下列变量中,属于分类变量的是()。
A. 企业所属行业B. 能源消费总量C. 第三产业就业人员数D. 工业增加值
答案 A 所属行业表示类别,属于分类变量;能源消费量、就业人数及工业增加值均属于定量变量。
14. 单项选择题
用1表示“男性”、用2表示“女性”,这种对变量进行观测得到的数据属于()。
A. 分类数据B. 定量数据C. 顺序数据D. 数值型数据
答案 A 本题考查变量和数据中的分类数据。当变量的取值是类别时被称为分类变量。分 类变量的观测结果称为分类数据,表现为类别,一般用文字来表达,也可用数值代码表示。
15. 单项选择题
下列变量中,属于顺序变量的是()。
A. 行业类别B. 可支配收入C. 员工受教育水平D. 性别
答案 C 当变量的取值表现为类别且具有一定顺序时被称顺序变量,比如员工受教育水 平、学业成绩等级等。
16. 单项选择题
下列统计变量中,属于顺序变量的是()。
A. 学业成绩等级B. 工业增加值C. 基础设施投资D. 房屋竣工面积
答案 A 学业成绩等级是有顺序的类别,属于顺序变量;工业增加值、基础设施投资和房屋竣工面积均是定量变量。
17. 单项选择题
下列变量中,属于定性变量的是()。
A. 性别B. 金融业增加值C. 城镇居民可支配收入D. 采矿业中间投入
答案 A 分类变量和顺序变量统称为定性变量。
18. 单项选择题
对定量变量观测的结果称为()。
A. 分类数据B. 顺序数据C. 数值型数据D. 定性数据
答案 C 数值型数据是对定量变量的观测结果,其取值表现为具体的表示大小或多少的 数值。
19. 多项选择题
下列变量中,通常用数值型数据表示的有()。
A. 注册员工人数B. 交通工具C. 家庭收入D. 居住地区E. 年龄
答案 ACE 本题考查数据类型,数值型数据是对定量变量的观测结果,其取值表现为具体 的表示大小或多少的数值。选项 A、C、E属于定量变量的取值,即为数值型数据。
20. 单项选择题
下列统计数据中,属于实验数据的是()。
A. 统计部门发布的地区生产总值B. 市场调查获得的价格C. 在控制试验条件的临床试验中取得的新药疗效数据D. 财政部门记录的财政收入
答案 C 实验数据是指通过在实验中控制实验对象以及其所处的实验环境收集到的数据,比 如,一种新产品使用寿命的数据,一种新药疗效的数据。

校勘说明:为使抽样设计、数据来源或实验条件明确而作的校订后教学题设,不冒充原题原文。

21. 单项选择题
下列统计数据中,属于观测数据的是()。
A. 控制试验条件取得的新品种小麦粗蛋白质含量B. 随机对照试验取得的新药疗效C. 控制试验条件取得的新产品使用寿命D. 日常价格调查获得的工业生产者价格
答案 D 观测数据是在没有对事物施加任何人为控制因素的条件下得到的,几乎所有与社 会经济现象有关的统计数据都是观测数据,如GDP、CPI、房价等。

校勘说明:为使抽样设计、数据来源或实验条件明确而作的校订后教学题设,不冒充原题原文。

22. 单项选择题
下列关于统计数据来源的说法,正确的是()。
A. 从使用者的角度看,他人的调查或实验的数据是统计数据的直接来源B. 一手数据只来源于实验C. 在社会经济领域,统计调查是获得数据的主要方法,也是获得一手数据的重要方式D. 从统计年鉴上收集的数据是一手数据
答案 C 他人的调查或实验的数据,对使用者来说,这是数据的间接来源,称为间接数据或 二手数据,选项A错误。一手数据的来源主要有两个:一是调查或观察;二是实验。选项B错 误。从统计年鉴上收集的数据是二手数据,选项D错误。
23. 多项选择题
下列统计数据中,属于观测数据的有()。
A. 控制试验条件取得的新产品使用寿命B. 统计部门核算的国内生产总值C. 随机对照试验获得的新药疗效D. 日常市场调查获得的房价E. 日常住户调查获得的消费支出
答案 BDE A和C的数据来自人为控制条件的试验;B、D和E来自常规统计核算或未施加试验干预的调查,属于观测数据,选BDE。

校勘说明:为使抽样设计、数据来源或实验条件明确而作的校订后教学题设,不冒充原题原文。

24. 多项选择题
下列统计数据中,属于观测数据的有()。
A. GDPB. CPIC. PPID. 房地产价格E. 随机对照试验获得的某种新药疗效
答案 ABCD GDP、CPI、PPI及日常房地产价格统计为常见观测数据;本题E明确来自随机对照试验,属于实验数据。药效变量本身不决定数据类型。

校勘说明:为使抽样设计、数据来源或实验条件明确而作的校订后教学题设,不冒充原题原文。

25. 多项选择题
下列统计数据中,属于一手数据的有()。
A. 通过自行开展临床试验获得的新药疗效数据B. 通过查阅统计年鉴获得的居民消费价格指数C. 通过房地产管理部门数据库获得的房价数据D. 通过自行开展入户调查得到的家庭月收入数据E. 通过自行开展网络调查得到的网民对某项政策的支持率数据
答案 ADE 一手数据是指直接的调查和科学实验,对使用者来说,是数据的直接来源。选项 B、C属于二手数据。

校勘说明:为使抽样设计、数据来源或实验条件明确而作的校订后教学题设,不冒充原题原文。

26. 多项选择题
下列数据收集方法中,属于收集第二手数据的有( )。
A. 在控制条件下进行试验并在试验过程中收集数据B. 通过电话询问被调查者C. 要求当事人到相关机构进行登记D. 购买公开出版的统计年鉴E. 与原调查单位合作获得未公开的内部调查资料
答案 DE 本题考查数据来源中的一手数据和二手数据。选项A、B、C属于一手数据,选项 D、E属于二手数据。
27. 单项选择题
下列方式属于全面调查的是()。
A. 每十年进行一次的人口普查B. 为掌握产品质量,抽取其中一部分商品做实验C. 为研究居民生活水平,对城市中的部分住户进行调查D. 统计人口出生率,抽选一定数量的妇产医院,对出生儿进行调查
答案 A 本题考查统计调查的分类。按调查对象的范围不同,分为全面调查和非全面调查。 选项A属于全面调查,选项B、C、D属于非全面调查。
28. 单项选择题
经济普查的对象是在中华人民共和国境内从事()活动的全部法人 单位、产业活动单位和个体经营户。
A. 第一产业B. 第二、第三产业C. 第一、第二产业D. 第一、第三产业
答案 B 本题考查全面调查的范围。经济普查的对象是在中华人民共和国境内从事第二、第 三产业活动的全部法人单位、产业活动单位和个体经营户。
29. 单项选择题
下列调查数据,属于不连续调查的是()。
A. 工厂的产品生产B. 原材料的投入C. 生产设备拥有量D. 能源的消耗
答案 C 不连续调查是间隔一个相当长的时间所作的调查,一般是总体现象在一定时点上的 状态。如生产设备拥有量、耕地面积等。
30. 多项选择题
下列调查方式中,属于非全面调查的有()。
A. 重点调查B. 抽样调查C. 典型调查D. 普查E. 全面报表
答案 ABC 全面调查包括全面统计报表和普查;非全面调查包括非全面统计报表、抽样调查、重点调查和典型调查等,故选ABC。
31. 单项选择题
根据国家有关法律法规,按照统一表式、统一指标、统一报送时间,自上 而下地统一布置、自下而上地逐级提供基本统计数据,这种统计调查方式是()。
A. 统计报表B. 抽样调查C. 普查D. 重点调查
答案 A 统计报表是按照国家有关法规的规定,自上而下地统一布置、自下而上地逐级提供 基本统计数据的一种调查方式。统计报表要以一定的原始数据为基础,按照统一表式、统一指 标、统一报送时间和报送程序进行填报。
32. 单项选择题
统计报表按照调查对象范围,可分为()。
A. 一次性报表和经常性报表B. 全面报表和非全面报表C. 基层报表和综合报表D. 国家统计报表、地方统计报表和部门统计报表
答案 B 本题考查统计报表的分类。统计报表的类型多样,按调查对象范围的不同可分为全 面统计报表和非全面统计报表。全面统计报表要求调查对象中的每一个单位都填报,非全面 统计报表只要求调查对象中的一部分单位填报。
33. 单项选择题
按报送周期长短,统计报表可以分为()。
A. 日报、月报、季报、年报等B. 全面和非全面统计报表C. 国家、部门和地方统计报表D. 基层和综合报表
答案 A 本题考查统计报表的类型。按报送周期长短,统计报表可以分为日报、月报、季报、 年报等。
34. 单项选择题
第七次全国人口普查的标准时间定为普查年份的11月1日0时,这是 为了保证( )。
A. 普查结果的准确性B. 普查的周期性C. 普查的经济性D. 普查结果的适应性
答案 A 普查一般需要规定统一的标准调查时间,以避免调查数据的重复或遗漏,保证普查 结果的准确性。
35. 单项选择题
抽样调查是从调查对象的总体中抽取一部分单位作为样本进行调查,以 下抽样调查特点中,()是最显著的优点。
A. 时效性强B. 适应面广C. 准确性高D. 经济性
答案 D 本题考查抽样调查的特点内容。抽样调查具有以下特点:经济性、时效性强、适应 面广、准确性高。其中,经济性是最显著的优点。
36. 单项选择题
关于抽样调查的说法,正确的是()。
A. 抽样调查中不存在误差B. 抽样调查用样本数据推断总体数量特征C. 抽样调查时效差D. 抽样调查通常从总体中选择重点单位进行调查
答案 B 抽样调查是用样本来推断总体,所以会有误差,选项A错误。抽样调查的特点之一 是时效性强,选项C错误。从总体中选择重点单位进行调查是重点调查,选项D错误。
37. 单项选择题
与普查相比,抽样调查具有()的特点。
A. 时效性强B. 周期性C. 适应面窄D. 统一标准调查时间
答案 A 抽样调查具有以下几个特点:①经济性;②时效性强;③适应面广;④准确性高。
38. 单项选择题
在进行重点调查时,应选择的调查单位是()。
A. 就调查的标志值来说在总体中占绝大比重的单位B. 有典型意义的单位C. 主动参与调查的单位D. 随机抽取的单位
答案 A 重点调查是指从调查对象的全部单位中选择一部分重点单位进行调查。重点单位 虽然只是全部单位中的一部分,但就调查的标志值来说在总体中占绝大比重。
39. 单项选择题
为了解全国煤炭企业的生产安全状况,找出安全隐患,专家根据经验选择10个有代表性的企业进行深入细致的调查。这类调查方法属于()。
A. 专家调查B. 重点调查C. 系统调查D. 典型调查
答案 D 典型调查是一种非全面调查,它是根据调查的目的与要求,在对被调查对象进行全 面分析的基础上,有意识地选择若干具有典型意义的或有代表性的单位进行的调查。
40. 单项选择题
在国家统计局制定的统计质量评价标准中,真实性侧重于评价()。
A. 基础数据质量B. 统计服务质量C. 统计数据生产科学性D. 统计用户满意度
答案 A 国家统计局制定的《国家统计质量保证框架(2021)》,确定了统计数据的质量评 价标准,其中真实性要求统计源头数据必须符合统计调查对象的实际情况,确保统计数据有依 据、可溯源。侧重于对基础数据质量的评价。
41. 多项选择题
下列关于统计报表的说法,正确的有()。
A. 以二手数据为基础进行填报B. 按统一表式填报C. 按统一报送时间填报D. 按统一报送程序填报E. 自上而下统一布置填报
答案 BCDE 统计报表要以一定的原始数据为基础,选项A错误。
42. 多项选择题
普查是为某一特定目的而专门组织的全面调查,其特点有()。
A. 时效性强B. 通常是一次性或周期性的C. 规范化程度较高D. 适用范围较广E. 需要规定统一的标准调查时间
答案 BCE 普查作为一种特殊的数据搜集方式,具有以下几个特点:①普查通常是一次性 的或周期性的。普查涉及面广、调查单位多,需要耗费大量的人力、物力和财力,通常需要间隔 较长的时间。②普查一般需要规定统一的标准调查时间,以避免调查数据的重复或遗漏,保证 普查结果的准确性。③普查的数据一般比较准确,规范化程度也较高。④普查的适用范围比 较窄,只能调查一些最基本及特定的现象。
43. 多项选择题
抽样调查是实际中应用最广泛的一种调查方式和方法,其特点有 ()。
A. 时效性强B. 通常是一次性或周期性的C. 准确性高D. 适用面广E. 需要规定统一的标准调查时间
答案 ACD 抽样调查的特点包括:经济性、时效性强、适应面广、准确性高。
44. 多项选择题
关于典型调查的说法,正确的有()。
A. 典型调查可以弥补全面调查的不足B. 典型调查受“有意识地选出若干有代表性单位”的限制,在很大程度上受到人们主观 认识的影响C. 典型调查主要用于反映现象的总体数量特征D. 典型调查具有灵活机动、通过少数典型单位即可取得深入翔实的统计资料的优点E. 典型调查是一种非全面调查
答案 ABDE 典型调查不在于反映现象的总体数量特征,而在于了解与统计数字有关的生 动的具体情况,即与现象数量有关的社会条件及其相互联系,选项C错误。
45. 多项选择题
大数据的特性包括()。
A. 数据量大B. 数据多样性C. 价值密度低D. 数据的产生和处理速度快E. 数据挖掘
答案 ABCD 大数据具有数据量大、数据多样性、价值密度低、数据的产生和处理速度快、真实性 等特性。
46. 多项选择题
关于大数据特性的说法,正确的有()。
A. 大数据具有“5V”特性B. 大数据类型繁多C. 大数据的价值密度低D. 大数据的产生和处理速度快E. 大数据都是结构化数据
答案 ABCD 大数据类型繁多,包括结构化、半结构化和非结构化的数据,选项E错误。
47. 多项选择题
下列数据特征中,属于大数据特性的有()。
A. 数据量大B. 数据多样性C. 数据结构化D. 数据价值密度低E. 数据产生和处理速度快
答案 ABDE 大数据具有“5V”特性:数据量大(Volume)、数据多样性(Variety)、价值密度 低(Value)数据的产生和处理速度快(Velocity)、真实性(Veracity)。
48. 多项选择题
关于数据挖掘的说法,正确的有()。
A. 数据源必须是真实的、大量的、无噪声的B. 发现的是用户感兴趣的知识C. 发现的知识是可接受、可理解、可运用的D. 并不要求发现放之四海而皆准的知识E. 核心任务是对数据关系和特征进行探索
答案 BCDE 数据挖掘从大量真实应用数据中发现潜在有价值知识,能够处理不完整、有噪声的数据,并不要求数据无噪声,也不要求数据必须有噪声。发现的知识应有用、可理解、可运用,可针对特定问题,其核心任务是探索数据关系和特征。
49. 多项选择题
关于数据科学的说法,正确的有()。
A. 数据科学的研究目的是通过对数据的分析,来解释、预测、洞见和决策B. 数据科学只涉及统计学和机器学习C. 数据科学涉及可视化和人工智能D. 数据科学只研究数据本身的特性和变化规律E. 数据科学研究的是从“数据”整合成“信息”进而组织成“知识”的整个过程
答案 ACE 数据科学一方面研究数据本身的特性和变化规律,另一方面通过对数据的研究 为自然科学和社会科学提供一种新的方法,从而揭示自然界和人类行为的现象和规律。数据 科学研究的是从“数据”整合成“信息”进而组织成“知识”的整个过程,包含对数据进行采 集、存储、处理、分析、表现等一系列活动。数据科学的研究对象是数据,研究目标是获得洞察 力和理解力,通过对数据的分析,来解释、预测、洞见和决策,为现实世界服务。数据科学涉及 的范围非常广泛,例如统计学、计算机科学、可视化、人工智能、领域知识等。
50. 多项选择题
采用无监督学习方法进行数据挖掘时,常用的方法有()。
A. 主成分分析法B. 线性回归C. 决策树D. 非线性回归E. k均值聚类算法
答案 AE 无监督学习主要任务包括聚类和降维。k均值是聚类方法,主成分分析是降维方法,故选AE。
51. 多项选择题
采用无监督学习方法进行数据挖掘时,常用的降维方法有()。
A. 主成分分析法B. 因子分析法C. 决策树D. 非线性回归E. 线性回归
答案 AB 常用的降维方法包括主成分分析法、因子分析法等。

7本章打卡

做完一项勾一项,当天页会自动更新整体进度。

学完这章就是往前走了一步。记不住的,明天再来看必背,不用今天全记住。
↑ 回到今日顶部

1重点一览

先花 2 分钟看清这章有几个考点、哪几个是必考,心里有数再读书。

7页教材2个 ★★★1个 ★★1个 ★50道章节题约 56 分钟教材印刷页 214-220
考点一 集中趋势的测度★★★
考点二 离散程度的测度★★★
考点三 分布形态的测度★
考点四 变量间的相关分析★★

2教材标色 + 三色笔记

左边是教材原文,彩色句子就是《考点速记》收了的内容,颜色是星级。右边是速记的考点表,和左边的小节对齐。读一节,看一眼右边的表,再往下走。

一、集中趋势的测度

教材 P214

在描述统计中,可以通过统计量描述数据的分布特征。对于数据分布特征的测度主要分为三个方面:一是分布的集中趋势,反映各数据向其中心值靠拢或聚集的程度;二是分布的离散程度,既能反映各数据之间的差异程度,也能反映中心值对数据的代表程度;三是分布的偏态,反映数据分布的不对称性。对于两个定量变量之间的相关分析,经常采用的描述方法是散点图和相关系数统计量。

集中趋势是指一组数据向某一中心值靠拢的程度,它反映了一组数据中心点的位置所在。集中趋势的测度也就是寻找数据水平的代表值或中心值。

1. 均值。均值也叫作平均数,就是数据组中所有数值的总和除以该组数值的个数。设一组数据为 X1,X2,…,Xn,平均数 X̄ 的计算公式为:

X̄ = (X1 + X2 + … + Xn) ÷ n = ΣXi ÷ n

例如,某售货小组有 5 名营业员,元旦全天的销售额分别为 520 元、600 元、480 元、750 元和 500 元,求该日平均销售额。

X̄ = (520 + 600 + 480 + 750 + 500) ÷ 5 = 570(元)

计算结果表明,元旦 5 名营业员的平均销售额为 570 元。

均值是集中趋势最主要的测度值,它是一组数据的重心所在,解释了一组数据的平均水平。它主要适用于数值型数据,但不适用于分类数据和顺序数据。此外,均值容易受到极端值的影响,极端值会使得均值向极大值或极小值方向倾斜,使得均值对数据组的代表性减弱。

2. 中位数。把一组数据按从小到大或从大到小的顺序进行排列,位置居中的数值叫作中位数,用 Me 表示。中位数将数据分成两部分,其中一半数据小于中位数,另一半数据大于中位数。设一组数据为 X1,X2,…,Xn,按从小到大顺序为 X(1),X(2),…,X(n),则中位数为:

当 n 为奇数时:Me = X((n+1)/2);当 n 为偶数时:Me = 1/2 × [X(n/2) + X(n/2+1)]

例如,某地级市下辖 9 个县,每个县的面积如下(单位:平方千米),计算该市下辖县面积的中位数:

1455 2019 912 1016 1352 1031 2128 1075 2000

首先,将上面的数据排序结果如下:

912 1016 1031 1075 1352 1455 2000 2019 2128

数据共有 9 个,即奇数个,中位数为 Me = X((9+1)/2) = X(5) = 1352(平方千米)。

教材 P215

在上例中,由于行政区划调整,邻市的一个面积为 1000 平方千米的县被划归该市。行政区划调整后,该市现在下辖 10 个县,该市下辖县的面积(单位:平方千米)从小到大依次为:

912 1000 1016 1031 1075 1352 1455 2000 2019 2128

计算行政区划调整后该市下辖县面积的中位数:

数据共有 10 个,即偶数个,中位数为 Me = 1/2 × [X(10/2) + X(10/2+1)] = 1/2 × (X(5) + X(6)) = 1/2 × (1075 + 1352) = 1213.5(平方千米)。

中位数是一个位置代表值,主要用于顺序数据和数值型数据,但不适用于分类数据。中位数的优点是不受极端值的影响,抗干扰性强,尤其适用于收入这类偏斜分布的数值型数据。

3. 众数。众数是指一组数据中出现次数(频数)最多的变量值。例如,某能源公司有 9 个分公司,每个分公司的主营产品分别是煤制品、有机化工原料、火电、煤制品、热力、电解铝、火电、煤制品、煤制品,则该能源公司分公司主营产品的众数为煤制品。

众数适用于描述分类数据和顺序数据的集中趋势。而在定量数据中,可能出现多众数和无众数的情况,因此众数不适用于描述定量数据的集中位置。

4. 均值、中位数和众数的比较及适用范围。三者的关系及各自的适用范围如下。①均值适用于定量变量。优点是能够充分利用数据的全部信息,均值大小受每个观测值的影响,比较稳定;缺点是易受极端值的影响,如果观测值中有明显的极端值,则均值的代表性较差。②中位数不适用于分类变量,适用于顺序变量和定量变量,特别是分布不对称的数据。优点是不受极端值的影响;缺点是没有充分利用数据的全部信息,稳定性差于均值,优于众数。③众数不适用于定量变量,主要适用于分类变量和顺序变量。优点是不受极端值的影响,尤其是分布明显呈偏态时,众数的代表性更好;缺点是没有充分利用数据的全部信息,缺乏稳定性,而且可能不唯一。

二、离散程度的测度

离散程度反映的是数据之间的差异程度。集中趋势的测度值是对数据水平的一个概括性的度量,它对一组数据的代表程度,取决于该组数据的离散水平。数据的离散程度越大,集中趋势的测度值对该组数据的代表性就越差,离散程度越小,其代表性就越好。

1. 方差。方差是数据组中各数值与其均值离差平方的平均数,它能较好地反映出数据的离散程度,是实际中应用最广泛的离散程度测度值。方差越小,说明数据值与均值的平均距离越小,均值的代表性越好。

对于总体数据,常用的方差计算公式有两种:

σ² = Σ(Xi − X̄)² ÷ N

S² = Σ(Xi − X̄)² ÷ (N − 1)

前者的分母是总体规模 N,后者的分母是总体规模 N 减去 1。

对于样本数据,常用的方差计算公式为:

s² = Σ(Xi − X̄)² ÷ (n − 1)

教材 P216

样本方差 s² 的分母是样本规模减去 1。在有放回的简单随机抽样中,样本方差 s² 是总体方差 σ² 的无偏估计量;而在不放回的简单随机抽样中,样本方差 s² 是总体方差 S² 的无偏估计量。

根据本章前例中 5 名营业员元旦当天的销售额样本数据,计算日销售额的样本方差。

s² = Σ(Xi − X̄)² ÷ (n − 1) = [(520 − 570)² + (600 − 570)² + (480 − 570)² + (750 − 570)² + (500 − 570)²] ÷ (5 − 1) = 12200

2. 标准差。方差是反映数据离散程度的重要测度指标,但是其单位是原数据单位的平方,没有解释意义。因此,我们经常使用标准差来测度数据的离散程度,标准差即方差的平方根。对于样本数据,常用的标准差计算公式为:

s = √[Σ(Xi − X̄)² ÷ (n − 1)]

标准差不仅能度量数值与均值的平均距离,还与原始数值具有相同的计量单位。

同样地,利用 5 名营业员元旦当天的销售额样本数据,计算日销售额的标准差。

s = √[Σ(Xi − X̄)² ÷ (n − 1)] = √12200 ≈ 110.45(元)

标准差与方差计算比较简便,又具有比较好的数学性质,是应用最广泛的统计离散程度的测度方法。但是标准差与方差只适用于数值型数据。此外,与均值一样,它们对极端值也很敏感。

3. 离散系数。离散系数也称变异系数或标准差系数,即标准差与均值的比值,主要用于不同类别数据离散程度的比较,记为 CV。离散系数计算公式为:

CV = s ÷ X̄

根据 5 名营业员元旦当天的销售额案例数据,计算日销售额的离散系数。

CV = 110.45 ÷ 570 ≈ 0.19

标准差的大小不仅与数据的测度单位有关,也与观测值的均值大小有关,不能直接用标准差比较不同变量的离散程度。离散系数消除了测度单位和观测值水平不同的影响,因而可以直接用来比较变量的离散程度。

三、分布形态的测度

1. 偏态系数。偏度是指数据分布的偏斜方向和程度,描述的是数据分布对称程度。测度数据分布偏度的统计量称为偏态系数,其计算公式为:

SK = n ÷ [(n − 1)(n − 2)] × Σ[(Xi − X̄) ÷ s]³

偏态系数取决于离差三次方的平均数与标准差三次方的比值。如果偏态系数等于 0,说

教材 P217

明数据的分布是对称的;如果偏态系数为正值,说明分布为右偏的,取值在 0 和 0.5 之间说明轻度右偏,取值在 0.5 和 1 之间说明中度右偏,取值大于 1 说明严重右偏;如果偏态系数为负值,说明分布为左偏,取值在 0 和 −0.5 之间说明轻度左偏,取值在 −0.5 和 −1 之间说明中度左偏,取值小于 −1 说明严重左偏。偏态系数的绝对值越大,说明数据分布的偏斜程度越大。

2. 标准分数。在统计上,均值和标准差不同时,不同变量的数值是不能比较的。比如,在考核 A 中员工得分的均值为 80 分,标准差为 20 分,在考核 B 中员工得分的均值为 60 分,标准差为 5 分。同样是 80 的得分,在考核 A 中属于中等水平,在考核 B 中可能名列前茅。来自不同分布的变量值不可比,但是每个数值在变量分布中相对于均值的相对位置是可比的,因此可以通过计算标准分数来比较不同变量的取值。标准分数可以给出数值距离均值的相对位置,计算方法是用数值减去均值所得的差除以标准差,计算公式为:

Zi = (Xi − X̄) ÷ s

在上面所说的两次考核得分分布假定下,在考核 A 中 80 分转化后的标准分数为 0,在考核 B 中 70 分转化后的标准分数为 2,说明 70 分在考核 B 中的相对排名高于 80 分在考核 A 中的相对排名。

标准分数也称为 Z 分数,是统计上常用的一种标准化方法,转变后的标准分数并没有改变数值在原分布中的位置,也没有改变数据原分布的偏度,但是标准分数的平均数为 0,标准差为 1。

在实际应用中,当数据服从对称的钟形分布时,可以运用经验法则来判断与均值的距离在特定倍数标准差之内的数据项所占比例。经验法则表明:约有 68% 的数据与平均数的距离在 1 个标准差之内,约有 95% 的数据与平均数的距离在 2 个标准差之内,约有 99% 的数据与平均数的距离在 3 个标准差之内。也就是说,对于服从对称的钟形分布的标准分数来说,约有 68% 的标准分数在 [−1, +1] 范围内,约有 95% 的标准分数在 [−2, +2] 范围之内,约有 99% 的标准分数在 [−3, +3] 范围之内。因此,根据经验法则,如果上面的考核 B 中的得分服从对称钟形分布,则 95% 的得分都在 50 分和 70 分之间。

四、变量间的相关分析

现实中很多变量之间存在着相关关系。比如,一般来说,身高越高的人体重也越重,收入较高的家庭消费水平也较高,诸如此类的例子不胜枚举。有的变量间相关关系较强,有的变量间相关关系较弱,并且变量间相关的模式也是不尽相同的。因此,我们需要度量变量间相关关系的强弱,并对不同的相关关系进行分类。

(一)变量间的相关关系

客观现象的相关关系可以按不同的标准进行分类。

1. 按相关的程度可分为完全相关、不完全相关和不相关。当一个变量的取值变化完全由另一个变量的取值变化所确定时,称这两个变量间的关系为完全相关。例如,在价格不变的条件下,某种商品的销售总额由其销售量决定。当两个变量的取值变化彼此互不影响时,称为不相关现象。例如,通常认为股票价格的高低与气温的高低是不相关的。当两个变量之间的关系介于完全相关和不相关之间,称为不完全相关,一般相关现象都是指这种不完全相关。

2. 按相关的方向可分为正相关和负相关。当一个变量的取值由小变大,另一个变量的取

教材 P218

值也相应由小变大,这种相关称为正相关。例如,工人的工资随着劳动生产率的提高而增加。当一个变量的取值由小变大,而另一个变量的取值相反地由大变小,这种相关称为负相关。例如,商品的销售量随着单价的升高而降低。

3. 按相关的形式可分为线性相关和非线性相关。当两个相关变量之间的关系大致呈现为线性关系时,称之为线性相关。如果两个相关变量之间,并不表现为直线的关系,而是近似于某种曲线方程的关系,则这种相关关系称为非线性相关。

需要注意的是,相关关系并不等同于因果关系。例如,夏季我们也许能得到雪糕的销售量与遮阳伞的销售量之间呈正相关,但常识告诉我们它们之间并不存在因果关系。

(二)散点图

两个变量间的关系可以用散点图来展示。在散点图中,每个点代表一个观测值,横纵坐标值分别代表两个变量相应的观测值。

图 24-1 是一些数据的散点图。横坐标值表示变量 X 的观测值,纵坐标值表示变量 Y 的观测值。图 a 的点几乎无规律而言,表示这两个变量不相关。图 b 和图 c 中,观测点密集在一条直线周围,表现为较强的线性相关,但相关的方向不同。图 b 中的两个变量为正相关关系,图 c 中的两个变量为负相关关系。图 d 中的观测点呈现出曲线模式,这表示两个变量为非线性相关。

(图 24-1 不同形态的散点图:a)点无规律散开,不相关;b)点沿右上方向直线密集,正相关;c)点沿右下方向直线密集,负相关;d)点呈 U 形曲线,非线性相关。图形见教材扫描件)

(三)相关系数

相关系数是度量两个变量间相关关系的统计量。最常用的相关系数是 Pearson 相关系数,它度量的是两个变量间的线性相关关系。

教材 P219

假设分别可得到两个变量 X 和 Y 的 n 组观测值,即 (xi, yi),i = 1, 2, …, n,其中两组观测值之间是一一对应的,那么 Pearson 相关系数 r 的计算公式为:

r = Σ(xi − x̄)(yi − ȳ) ÷ √[Σ(xi − x̄)² × Σ(yi − ȳ)²]

表 24-1 是 2012 至 2023 年我国城镇居民人均可支配收入和人均消费支出数据。图 24-2 所示为相应的散点图。从图中可以看出,这两个变量呈正线性相关。

表 24-1 2012 至 2023 年我国城镇居民人均可支配收入和人均消费支出(单位:元)

年份城镇居民人均可支配收入城镇居民人均消费支出
20122412717107
20132646718488
20142884419968
20153119521392
20163361623079
20173639624445
20183925126112
20194235928063
20204383427007
20214741230307
20224928330391
20235182132994

资料来源:《中国统计年鉴》。(编者注:表中数据为统计软件导出,存在统计误差。)

(图 24-2 2012 至 2023 年我国城镇居民人均可支配收入和人均消费支出的散点图:横轴为人均可支配收入,纵轴为人均消费支出,各点近似排成一条向右上方的直线。图形见教材扫描件)

用公式进行计算,可得两变量观测值的 Pearson 相关系数 r:

r = Σ(xi − x̄)(yi − ȳ) ÷ √[Σ(xi − x̄)² × Σ(yi − ȳ)²] ≈ 0.9941

可以证明,Pearson 相关系数的取值范围在 +1 和 −1 之间,即 −1 ≤ r ≤ 1。若 0 < r ≤ 1,表明变量 X 和 Y 之间存在正线性相关关系;若 −1 ≤ r < 0,表明变量 X 和 Y 之间存在负线性

教材 P220

相关关系。若 r = 1,表明变量 X 和 Y 之间为完全正线性相关;若 r = −1,表明变量 X 和 Y 之间为完全负线性相关。可见,当 |r| = 1 时,变量 Y 的取值完全依赖于 X;当 r = 0 时,说明 Y 和 X 之间不存在线性相关关系。需要注意的是,Pearson 相关系数只适用于线性相关关系的判断。因此,r = 0 只表示两个变量之间不存在线性相关关系,并不说明变量之间没有任何关系,比如它们之间可能存在非线性相关关系。变量之间的非线性相关程度较大时,就可能会导致 r = 0。因此,当 r = 0 或很小时,不能轻易得出两个变量之间不存在相关关系的结论,而应结合散点图作出合理的解释。

根据实际数据计算出的 r,其取值范围一般为 −1 < r < 1。在说明两个变量之间的线性关系的强弱时,根据经验可将相关程度分为以下几种情况:当 |r| ≥ 0.8 时,可视为高度相关;当 0.5 ≤ |r| < 0.8 时,可视为中度相关;当 0.3 ≤ |r| < 0.5 时,可视为低度相关;当 |r| < 0.3 时,说明两个变量之间的相关程度极弱,可视为无线性相关关系。

3必背

这些是必须背下来的。先遮住右边一列,看左边考点名,自己说出内容,说不出来的做记号。

经济基础 第24章 描述统计 必背

红 ★★★ 必考

考点必背内容
数据分布特征三方面集中趋势(向中心靠拢)、离散程度(差异 + 中心值代表性)、偏态(不对称性)
均值总和 ÷ 个数:X̄ = ΣXi ÷ n;集中趋势最主要的测度值,是一组数据的重心
均值适用只用于数值型数据,不适用于分类数据和顺序数据;易受极端值影响,代表性减弱
中位数排序后居中的数,记 Me;n 为奇数取第 (n+1)/2 个,n 为偶数取中间两个的平均
中位数适用位置代表值,用于顺序数据和数值型数据,不适用于分类数据;不受极端值影响,抗干扰强,收入类偏斜数据最适合
众数出现次数(频数)最多的变量值;适用于分类数据和顺序数据,不适用于定量数据(可能多众数或无众数)
三者比较:均值定量变量。优点:充分利用全部信息,比较稳定;缺点:易受极端值影响
三者比较:中位数顺序变量和定量变量(尤其分布不对称),不用于分类变量。优点:不受极端值影响;缺点:没用全部信息,稳定性差于均值、优于众数
三者比较:众数分类变量和顺序变量,不用于定量变量。优点:不受极端值影响,明显偏态时代表性更好;缺点:没用全部信息,缺乏稳定性,可能不唯一
方差各数值与均值离差平方的平均数,应用最广泛的离散程度测度值;样本方差 s² = Σ(Xi − X̄)² ÷ (n − 1);方差越小,均值代表性越好
标准差方差的平方根:s = √[Σ(Xi − X̄)² ÷ (n − 1)];与原始数据同单位,能度量数值与均值的平均距离
方差与标准差的局限只适用于数值型数据;对极端值敏感
离散系数又叫变异系数、标准差系数:CV = s ÷ X̄;消除单位和均值水平的影响,用于不同类别数据离散程度的比较
教材例题数字5 名营业员销售额 520、600、480、750、500:均值 570,样本方差 12200,标准差 110.45,离散系数 0.19

黄 ★★ 重点

考点必背内容
按相关程度分完全相关(一个变量完全由另一个决定)、不相关(彼此互不影响)、不完全相关(介于两者之间,一般相关都是这种)
按相关方向分正相关(一个变大另一个也变大)、负相关(一个变大另一个变小)
按相关形式分线性相关(大致呈直线)、非线性相关(近似某种曲线)
相关与因果相关关系不等于因果关系(雪糕销量与遮阳伞销量)
散点图四图a 无规律 = 不相关;b 沿直线右上 = 正相关;c 沿直线右下 = 负相关;d 曲线 = 非线性相关
Pearson 相关系数r = Σ(xi − x̄)(yi − ȳ) ÷ √[Σ(xi − x̄)² × Σ(yi − ȳ)²];只适用于线性相关关系的判断
r 的取值−1 ≤ r ≤ 1;0 < r ≤ 1 正线性相关,−1 ≤ r < 0 负线性相关;r = 1 完全正线性相关,r = −1 完全负线性相关(r 的绝对值 = 1 时 Y 完全依赖于 X);r = 0 无线性相关(不等于没关系,可能非线性)
相关强弱经验标准绝对值 ≥ 0.8 高度相关;0.5 到 0.8 中度相关;0.3 到 0.5 低度相关;小于 0.3 极弱,视为无线性相关

绿 ★ 会考数字的点

考点必背内容
偏态系数 SK离差三次方的平均数 ÷ 标准差三次方;SK = 0 对称,正值右偏,负值左偏;绝对值越大偏得越厉害
偏态轻中重右偏:0 到 0.5 轻度,0.5 到 1 中度,大于 1 严重;左偏对称取负:0 到 −0.5 轻度,−0.5 到 −1 中度,小于 −1 严重
标准分数(Z 分数)Zi = (Xi − X̄) ÷ s,数值离均值几个标准差;不改变数值在原分布中的位置,不改变偏度;转化后平均数为 0、标准差为 1
经验法则对称钟形分布:68% 在 1 个标准差内 [−1, +1],95% 在 2 个标准差内 [−2, +2],99% 在 3 个标准差内 [−3, +3]

数字与公式清单

  • 均值 X̄ = ΣXi ÷ n;例题 570 元
  • 中位数:奇数取第 (n+1)/2 个,偶数取第 n/2 和 n/2+1 个的平均;例题 9 个县 1352,10 个县 1213.5
  • 样本方差 s² = Σ(Xi − X̄)² ÷ (n − 1),分母 n − 1;例题 12200
  • 标准差 s = √方差;例题 110.45 元
  • 离散系数 CV = s ÷ X̄;例题 0.19
  • 偏态系数 SK = n ÷ [(n − 1)(n − 2)] × Σ[(Xi − X̄) ÷ s]³,分界线 0.5 和 1
  • 标准分数 Z = (X − X̄) ÷ s;例题考核 B 里 70 分 Z = (70 − 60) ÷ 5 = 2
  • 经验法则 68%、95%、99% 对应 1、2、3 个标准差
  • Pearson r 范围 −1 到 1;强弱分界 0.8、0.5、0.3;例题城镇居民收入与消费 r ≈ 0.9941
  • 稳定性排序:均值 > 中位数 > 众数;抗极端值:中位数、众数强,均值弱
  • 数据类型配对:分类数据只能用众数;顺序数据用众数、中位数;数值型数据三个都行

4总结

一页纸看完整章。二轮快刷和考前只看这里和必背。

经济基础 第24章 描述统计 一页纸总结

本章一句话

拿到一堆数,先找「中间在哪」(均值、中位数、众数),再看「散得多开」(方差、标准差、离散系数),再看「歪不歪」(偏态系数、标准分数),最后看两个变量「有没有一起动」(散点图、Pearson 相关系数 r)。四件事对应四个考点,公式就那几个,例题数字 570、12200、110.45、0.19 串起前两个考点。

章末总览表

考点星级一句话要点考法
考点一 集中趋势的测度★★★均值 = 总和 ÷ 个数,数值型专用,怕极端值;中位数 = 排序取中间,顺序和数值型可用,不怕极端值,收入用它;众数 = 出现最多的值,分类和顺序数据用;稳定性均值 > 中位数 > 众数单选(适用数据类型、优缺点)、多选(三者比较)、计算(求均值、求中位数)
考点二 离散程度的测度★★★方差 = 离差平方的平均(分母 n − 1),标准差 = 开根号回到原单位,离散系数 = 标准差 ÷ 均值用于跨组比较;方差和标准差只用于数值型数据且对极端值敏感单选(概念和适用)、计算(给一组数求方差、标准差、离散系数)、多选(离散系数三个名字、作用)
考点三 分布形态的测度★偏态系数正右偏负左偏 0 对称,0.5 和 1 分轻中重;标准分数 Z = (X − 均值) ÷ 标准差,均值变 0 标准差变 1;经验法则 68%、95%、99% 对应 1、2、3 个标准差单选(偏态方向和程度判断、经验法则比例)、计算(求 Z 分数)
考点四 变量间的相关分析★★相关分三类:程度(完全、不完全、不相关)、方向(正、负)、形式(线性、非线性);散点图四种形态;Pearson r 在 −1 到 1,只判线性,0.8、0.5、0.3 分高中低单选(给 r 值判断相关程度和方向)、多选(相关关系分类)、判断(r = 0 是否无关系)

易错坑

  1. 均值「比较稳定」和「易受极端值影响」是同时成立的两句话,别以为矛盾就选错;中位数「稳定性差于均值、优于众数」这个排序常考。
  2. 样本方差、标准差的分母是 n − 1 不是 n;方差的单位是原单位的平方,所以才要标准差。
  3. 比较两组单位不同或均值差很大的数据谁更离散,只能用离散系数,不能直接比标准差;离散系数 = 变异系数 = 标准差系数,三个名字一回事。
  4. r = 0 只说明没有线性相关,不代表没关系(可能非线性);Pearson 相关系数只判线性;相关不等于因果。
  5. r 看强弱看绝对值:r = −0.9 是高度相关;偏态系数 1.2 是严重右偏,0.3 是轻度右偏,分界线是 0.5 和 1。

和前后章的关系

第 23 章讲统计与数据科学是总纲(数据类型:分类、顺序、数值型),本章所有「适用于什么数据」的判断都建立在第 23 章数据分类上。本章算出来的均值、方差是「描述」,第 25 章抽样调查讲怎么从样本推断总体,本章样本方差分母 n − 1 的无偏估计在那里接着用;第 26 章回归分析是本章相关系数的延伸,从「有没有关系」走到「关系是什么方程」。

5解读(读透版讲义)

哪里没看懂,来这里看大白话讲解。生活例子、考法、坑都在这。可以先读这个再回去读教材。

描述统计(教材原文·OCR)

文字为主,公式/图表以教材扫描为准。配套精华看复习网页。

第二十四章 描述统计

在描述统计中,可以通过统计量描述数据的分布特征。对于数据分布特征的测度主要分
为三个方面:一是分布的集中趋势,反映各数据向其中心值靠拢或聚集的程度; 二是分布的离
散程度 ,既能反映各数据之间的差异程度,也能反映中 心值对数据的代表程度; 三 =是分布的偏
态,反映数据分布的不对称性。对于两个定量变量之间的相关分析,经 常采用的描述方法是散
点图和相关系数统计量。

一\集中趋势的测度

集中趋势是指一组数据向某一中心值靠拢的程度,它反映了一组数据中心点的位置所在。
集中趋势的测度也就是寻找数据水平的代表值或中心值。
1均值。均值也叫作平均数,就是数据组中所有数值的总和除以该组数值的个数。设一
组数据为书,刺,…,闷,平均数筷的计算公式为:
了 丰二 7 辫志
4
例如,某售货小组有 5 名营业员 ,元旦全天的销售额分别为 520 元 .600 元.480 元.750元
和 500 元,求该日平均销售额。

喜 _320 +600 二 +750 +500 -570(元)

计算结果表明,元旦5 名营业员的平均销售额为 570 元。

均值是集中趋势最主要的测度值,它是一组数据的重心所在,解释了一组数据的平均水
平。它主要适用于数值型数据,但不适用于分类数据和顺序数据。此外,均值容易受到极端值

的影响,极端值会使得均值向极大值或极小值方向倾斜,使得均值对数据组的代表性减弱。

  1. 中位数。把一组数据按从小到大或从大到小的顺序进行排列,位置居中的数值叫作中

位数,用凡 表示。中位数将数据分成两部分,其中一半数据小于中位数,另一半数据大于中位
数。设一组数据为 吕, 于,… ,总,按从小到大顺序为Xih, Ko,…,开oh则中位数为:

工(呈0) 当 为奇数时
于[xG)+xG D)] 当,为偶数时

例如,某地级市下钳9个县,每个县的面积如下(单位: 平方千米),计算该市下钳县面积
的中位数:

1455 2019 912 1016 1352 1031 2128 1075 2000

首先,将上面的数据排序结果如下
912 1016 1031 1075 1352 1455 2000 2019 2128

数据共有 9 个,即奇数个,中位数为 W=X (sjD) =1352( 平方千米)。

1 =

第二让四章…,描*述*统*计 “2715,

在上例中,由于行政区划调整 ,邻市的一个面积为 1000 平方千米的县被划归该市。行政
区划调整后,该市现在下辖 10 个县,该市下辖县的面积(单位:平方千米 )从小到大依次为:

912 1000 1016 1031 1075 1352 1455 2000 2019 2128

计算行政区划调整后该市下辖县面积的中位数:

数据共有 10 个,即偶数个,中位数为W= [Kom)+X(Ce |] = 2=(1075+1352) = 2=12135
(平方下米)

中位数是一个位置代表值,主要用于顺序数据和数值型数据,但不适用于分类数据。中位
数的优点是不受极端值的影响,抗干扰性强,尤其适用于收入这类偏斜分布的数值型数据。

  1. 众数。众数是指一组数据中出现次数( 频数)最多的变量值。例如,某能源公司有 9 个

分公司,每个分公司的主营产品分别是煤制品`有机化工原料火电、煤制品 ,热力,电解铝、火
电、煤制品 .煤制品,则该能源公司分公司主营产品的众数为煤制品。

众数适用于描述分类数据和顺序数据的集中趋势。而在定量数据中,可能出现多众数和
无众数的情况,因此众数不适用于描述定量数据的集中位置。

  1. 均值.中位数和众数的比较及适用范围。三者的关系及各自的适用范围如下。@D均值适

用于定量变量。优点是能够充分利用数据的全部信息,均值大小受每个观测值的影响,比较稳
定; 缺点是易受极端值的影响,如果观测值中有明显的极端值,则均值的代表性较差。@中位数
不适用于分类变量,适用于顺序变量和定量变量,特别是分布不对称的数据。优点是不受极端
值的影响; 缺点是没有充分利用数据的全部信息,稳定性差于均值,优于众数。@)众数不适用于
定量变量, 主要适用于分类变量和顺序变量。优点是不受极端值的影响,尤其是分布明显呈偏
态时,众数的代表性更好; 缺点是没有充分利用数据的全部信息,缺乏稳定性,而且可能不唯一。

二\离散程度的测度

离散程度反映的是数据之间的差异程度。集中趋势的测度值是对数据水平的一个概括性
的度量,它对一组数据的代表程度,取决于该组数据的离散水平。数据的离散程度越大,集中
趋势的测度值对该组数据的代表性就越差,离散程度越小,其代表性就越好。

1.方差。方差是数据组中各数值与其均值离差平方的平均数,它能较好地反映出数据的
离散程度,是实际中应用最广泛的离散程度测度值。方差越小,说明数据值与均值的平均距离
越小,均值的代表性越好。

对于总体数据,常用的方差计算公式有两种:

守 (和-7
-气- 一

2
OF

之 (互 一 ) “

NV-1l
前者的分母是总体规模 NW,后者的分母是总体规模 N 减去 1。
对于样本数据,常用的方差计算公式为:

三

3 =

灵一1

“216 经济基础知识 (中级)

样本方差* 的分母是样本规模减去 1。在有放回的简单随机抽样中,样本方差立是总
体方差 r ”的无偏估计量; 而在不放回的简单随机抽样中,样本方差叶是总体方差 8? 的无偏
估计量。

根据本章前例中 5 名营业员元旦当天的销售额样本数据,计算日销售额的样本方差。

守(世-2旭)?
玉= msE
九一1
_ (520 - 570)” + (600 - 570)” + (480 - 570)? + (750 - 570) + (500 - 570)
本 SS -1
= 12200

  1. 标准差。方差是反映数据离散程度的重要测度指标,但是其单位是原数据单位的平方,

没有解释意义。因此,我们经常使用标准差来测度数据的离散程度,标准差即方差的平方根。
对于样本数据,常用的标准差计算公式为:

立 (厂=-

=
“一 九一1

标准差不仅能度量数值与均值的平均距离 ,还与原始数值具有相同的计量单位。
同样地,利用 5 名营业员元旦当天的销售额样本数据,计算日销售额的标准差。

(天 一)

一 一= 12200 ~ 110.45 (元)
元二

标准差与方差计算比较简便,又具有比较好的数学性质,是应用最广泛的统计离散程度的
测度方法。但是标准差与方差只适用于数值型数据。此外,与均值一样,它们对极端值也很敏

  1. 离散系数。离散系数也称变异系数或标准差系数,即标准差与均值的比值,主要用于不

同类别数据离散程度的比较,记为 CY。离散系数计算公式为,

CY=二
元
根据 5 名营业员元旦当天的销售额案例数据,计算日销售额的离散系数。
CY =了人 ~0.19

标准差的大小不仅与数据的测度单位有关,也与观测值的均值大小有关,不能直接用标准
差比较不同变量的离散程度。离散系数消除了测度单位和观测值水平不同的影响,因而可以
直接用来比较变量的离散程度。

三分布形态的测度

  1. 偏态系数。偏度是指数据分布的偏笠方向和程度,描述的是数据分布对称程度测度

数据分布偏度的统计量称为偏态系数,其计算公式为;
加 用 系一X下
你 Ce这 > 】
偏态系数取决于离差三次方的平均数与标准差三次方的比值。如果偏态系数等于0 说

第二让四章”,描*述统计 2177,

明数据的分布是对称的; 如果偏态系数为正值,说明分布为右偏的,取值在 0 和 0.5 之间说明
轻度右偏,取值在 0.5 和 1 之间说明中度右偏,取值大于 1 说明严重右偏; 如果偏态系数为负
值,说明分布为左偏,取值在 0 和 -0.5 之间说明轻度左偏,取值在 -0.5 和 -1 之间说明中度左
偏,取值小于 -1 说明严重左偏。偏态系数的绝对值越大,说明数据分布的偏斜程度越大。

  1. 标准分数。在统计上 ,均值和标准差不同时,不同变量的数值是不能比较的。比如,在

考核 A 中员工得分的均值为 80 分,标准差为 20 分,在考核 B 中员工得分的均值为 60 分,标
准差为5 分。同样是 80 的得分,在考核 A 中属于中等水平,在考核 B 中可能名列前匾。来自
不同分布的变量值不可比,但是每个数值在变量分布中相对于均值的相对位置是可比的,因此
可以通过计算标准分数来比较不同变量的取值。标准分数可以给出数值距离均值的相对位
置,计算方法是用数值减去均值所得的差除以标准差 ,计算公式为:

成-碟

2 =

在上面所说的两次考核得分分布假定下 ,在考核 A 中 80 分转化后的标准分数为 0,在考
核B 中70 分转化后的标准分数为2,说明 70 分在考核 B 中的相对排名高于 80 分在考核 A
中的相对排名。

标准分数也称为Z 分数,是统计上常用的一种标准化方法 ,转变后的标准分数并没有改变
数值在原分布中的位置,也没有改变数据原分布的偏度,但是标准分数的平均数为0,标准差
为 1。

在实际应用中, 当数据服从对称的钟形分布时,可以运用经验法则来判断与均值的距离
在特定倍数标准差之内的数据项所占比例。经验法则表明: 约有 68% 的数据与平均数的距离
在 1 个标准差之内,约有 95% 的数据与平均数的距离在 2 个标准差之内,约有 99%5 的数据与
平均数的距离在 3 个标准差之内。也就是说,对于服从对称的钟形分布的标准分数来说,约有
6896 的标准分数在[ -1, +1]范围内,约有 95% 的标准分数在[ -2, +2 ] 范围之内,约有 99% 的
标准分数在[ -3, +3 ] 范围之内。因此,根据经验法则,如果上面的考核 B 中的得分服从对称
钟形分布,则 95% 的得分都在 50 分和 70 分之间。

四、变量间的相关分析

现实中很多变量之间存在着相关关系。比如,一般来说,身高越高的人体重也越重,收入
较高的家庭消费水平也较高,诸如此类的例子不胜枚举。有的变量间相关关系较强,有的变量
间相关关系较弱,并且变量间相关的模式也是不尽相同的。因此,我们需要度量变量问相关关
系的强弱,并对不同的相关关系进行分类。

( 一 )变量间的相关关系

客观现象的相关关系可以按不同的标准进行分类。

  1. 按相关的程度可分为完全相关、不完全相关和不相关。当一个变量的取值变化完全由

另一个变量的取值变化所确定时,称这两个变量间的关系为完全相关。例如,在价格不变的条
件下 ,某种商品的销售总额由其销售量决定。当两个变量的取值变化彼此互不影响时 ,称为不
相关现象。例如,通常认为股票价格的高低与气温的高低是不相关的。当两个变量之间的关
系介于完全相关和不相关之间 ,称为不完全相关,一般相关现象都是指这种不完全相关。

  1. 按相关的方向可分为正相关和负相关。当一个变量的取值由小变大,另一个变量的取

218 经济基础知识(中级)

值也相应由小变大,这种相关称为正相关。例如,工人的工资随着劳动生产率的提高而增加。
当一个变量的取值由小变大,而另一个变量的取值相反地由大变小,这种相关称为负相关。例
如,商品的销售量随着单价的升高而降低。

  1. 按相关的形式可分为线性相关和非线性相关。当两个相关变量之间的关系大致呈现为

线性关系时,称之为线性相关。如果两个相关变量之间,并不表现为直线的关系,而是近似于
某种曲线方程的关系,则这种相关关系称为非线性相关。

需要注意的是,相关关系并不等同于因果关系。例如,夏季我们也许能得到雪糕的销售量
与遮阳们的销售量之间呈正相关,但常识告诉我们它们之间并不存在因果关系。

( 二)散点图

两个变量间的关系可以用散点图来展示。在散点图中,每个点代表一个观测值,横纵坐标
值分别代表两个变量相应的观测值。

图 24-1 是一些数据的散点图。横坐标值表示变量了的观测值,纵坐标值表示变量了的
观测值。图 a 的点几乎无规律而言 ,表示这两个变量不相关。图 b 和图 e 中,观测点密集在一
条直线周围,表现为较强的线性相关,但相关的方向不同。图 b 中的两个变量为正相关关系,

图e 中的两个变量为负相关关系。图 d 中的观测点呈现出曲线模式,这表示两个变量为非线
性相关。
员 十? 6 5
尽了| o
SS了] 。 了 o” 8
ooo oo o 局 四
己 二 站 oo ae 。 一 8
_ o 。 & 吕 四 相
了了 多 06 ?
S o 8 o。 S 了 o
1 oo 隐
D 己 O
T T T T T 全 T T T T
=-10 -5 0 5 10 =-20 =10 0 10 20
大 大
a) b)
加
[5 吉 5

10 20
1

了
1
了
4e+05
L _ 1
o

己二 中
宁
二 |
己
?] 和 “| 。
9 哆
二 oo 忆 站| Romemm ap
T T T T T 包 T T T T T
-20 -10 0 10 20 -20 -10 0 10 20
互 下
c) d)

24-1 不同形态的散点图

( 三 )相关系数
相关系数是度量两个变量间相关关系的统计量。最常用的相关系数是 Pearson 相关系
数,它度量的是两个变量间的线性相关关系。

第二让四章…横*述-统-计 .279 .

假设分别可得到两个变量X和了的m组观测值,即 ,yx,i=1,2,…,m,其中两组观测值
之间是一一对应的,那么 Pearson 相关系数 的计算公式为:

人-

辫 (和一无) 区 (和一7)
表 24-1 是 2012一2023 年我国城镇居民人均可支配收入和人均消费支出数据。图 24-2
所示为相应的散点图。从图中可以看出,这两个变量呈正线性相关。

表 24-1 2012一2023 年我国城镇居民人均可支配收入和人均消费支出
年份 2012 | 2013 | 2014 | 2015 | 2016 | 2017 | 2018 | 2019 | 2020 | 2021 | 2022 | 2023

城镇居民
人均可支
配收入和
(元)
城镇居民
人均消
费支出六

(元)
资料来源:中国统计年鉴》

24127 | 26467 | 28844 | 31195 | 33616 | 36396 | 39251 | 42359 | 43834 | 47412 | 49283 | 51821

17107 | 18488 | 19968 | 21392 | 23079 | 24445 | 26112 | 28063 | 27007 | 30307 | 30391 | 32994

35000

30000 全多
25000 3 4 多
20000 ee

15000
10000
5000

城镇居民人均消费支出〈元)

0 10000 20000 30000 40000 50000 60000
城镇居民人均可支配收入(元)

图 24-2 ”2012一2023 年我国城镇居民人均可支配收入和人均消费支出的散点图
用公式进行计算,可得两变量观测值的 Pearson 相关系数 r:

严

2 0)

全 (过 (入一了)

可以证明, Pearson 相关系数的取值范围在+1和-1之间,即-1和7<1。 若0一r友1,
表明变量革和了之间存在正线性相关关系;若 -1 和r < 0,表明变量X和了之间存在负线性

一 0.9941

人四”表中数据为统计软件导出 ,存在统计误差。一一编者注

' 220 ”经济基础知误(中级)

相关关系。若 =1,表明变量碟和了之间为完全正线性相关; 若 王-1,表明变量蒜和了之间为
完全负线性相关。可见,当|r|=1l 时,变量了的取值完全依赖于X; 当r=0 时,说明了和成之间
不存在线性相关关系。需要注意的是, Pearson 相关系数只适用于线性相关关系的判断。
此,r=0 只表示两个变量之间不存在线性相关关系,并不说明变量之间没有任何关系,比如它
们之间可能存在非线性相关关系。变量之间的非线性相关程度较大时,就可能会导致 王0。
因此,当z=0 或很小时,不能轻易得出两个变量之间不存在相关关系的结论,而应结合散点图
作出合理的解释。

根据实际数据计算出的,其取值范围一般为 -1 < > < 1。在说明两个变量之间的线性
关系的强弱时,根据经验可将相关程度分为以下几种情况: 当|r| > 0.8 时,可视为高度相关;
当0.5 < |r| < 0.8 时,可视为中度相关; 当0.3 < |r| < 0.5 时,可视为低度相关; 当|>| < 0.3
时 ,说明两个变量之间的相关程度极弱,可视为无线性相关关系。


零基础复习卡(两版教材核验)

来源核验:主教材《2026经济基础知识中级原书有色差(371)》PDF 第225-231页;《经济基础知识(中级)-292》PDF 第180-185页(书内第172-177页)。公式已对照主教材第225页原图复核。

一句话先懂

描述统计用“中心在哪里、数据散不散、分布歪不歪、两个变量一起怎么变”四个问题概括一组数据。

零基础解释

  1. 集中趋势:均值利用全部数据,但怕极端值;中位数只看排序后的中间位置,抗极端值;众数是出现最多的值,分类数据也能用。
  2. 离散程度:方差是离均差平方的平均,标准差是方差开平方;离散系数是标准差与均值之比,可比较量纲或均值不同的数据。
  3. 分布形态:偏态系数等于0为对称,大于0为右偏(长尾向右),小于0为左偏。标准分数把不同均值、标准差的数据拉到同一尺度。
  4. 相关分析:散点图先看形状,相关系数再量化线性方向和程度。相关系数只刻画线性关系,不证明因果。

必背清单

  • 均值:`x̄=Σx/n`;中位数:排序后取中间位置;众数:频数最多。
  • 方差越大越分散;标准差与原数据同单位。
  • 离散系数:`CV=s/x̄`,通常写成百分数。
  • 标准分数:`z=(x-x̄)/s`;`z>0`表示高于均值。
  • 相关系数 `r` 的范围是 `[-1,1]`;符号表方向,绝对值表线性相关强弱。
  • 教材经验判断:`|r|>0.8`高度相关;0.5-0.8中度;0.3-0.5低度;小于0.3线性相关极弱。

易混点

  • 均值适用于数值型数据;中位数适用于顺序和数值型;众数适用于分类、顺序和数值型。
  • 方差有平方单位,不便直接解释;标准差有原单位。
  • 两组数据均值或计量单位差别大时,不宜只比较标准差,应比较离散系数。
  • `r=0`只说明无线性相关,不等于完全没有任何关系。
  • 正相关不是“数值都为正”,而是一个增大时另一个总体上也增大。

记忆口诀

  • “均值用全体,极端会牵引;中位看位置,众数看次数”。
  • “方差平方,标准同量纲;跨组比较看变异系数”。

自测题

  1. 单选:收入数据中有少数亿元级极端值,描述典型收入最稳健的是( )。A均值 B中位数 C方差 D相关系数

答案:B。 中位数对极端值不敏感。

  1. 判断:标准差的单位是原数据单位的平方。

答案:错。 方差是平方单位,标准差与原数据同单位。

  1. 计算:某人得分80分,班级均值70分、标准差5分,其标准分数是多少?

答案:2。 `(80-70)/5=2`,即高于均值2个标准差。

  1. 单选:比较“月工资”和“销售额”哪组波动相对更大,优先用( )。A极差 B方差 C标准差 D离散系数

答案:D。 两组量纲或均值不同,应看相对离散程度。

  1. 判断:相关系数为0,就能断定两个变量毫无关系。

答案:错。 只能说明没有线性相关,仍可能存在非线性关系。

  1. 单选:相关系数 `r=-0.92` 表示( )。A高度正相关 B高度负相关 C低度负相关 D因果关系

答案:B。 负号表方向,绝对值0.92表高度线性相关。

6刷题(章节配套练习,含校订与教学改编)

先做后看答案。单选点一下就判,多选选完点「核对答案」。错题自动进错题本,二轮会回来重做。

1. 单项选择题
下列统计量中,用于测度数据集中趋势的是()。
A. 均值B. 方差C. 标准差D. 相关系数
答案 A 集中趋势是指一组数据向某一中心值靠拢的程度,反映了一组数据中心点的位置 所在,包括均值、中位数、众数等。
2. 单项选择题
某连锁超市6家分店的职工人数(单位:人)由少到多排序后为:57、58、 58、60、63、70,其算术平均数、众数分别为( )。
A. 59,58B. 61,58C. 61,59D. 61,70
答案 B 算术平均数=(57+58+58+60+63+70)÷6=61人;58出现2次,频数最高,故众数为58人,选B。
3. 单项选择题
某小学六年级8个班的学生人数由少到多依次为34、34、34、34、36、36、37、37,其中位数为()。
A. 34B. 35C. 36D. 37
答案 B 8个数的中位数为第4个与第5个数的平均数,即(34+36)÷2=35人。
4. 单项选择题
随机抽取7名员工,其2025年上半年请假天数分别为1、5、3、10、0、7、2。这组数据的中位数是()。
A. 0B. 3C. 4D. 10
答案 B 将题目中的一组数据排序:0,1,2,3,5,7,10。位置居中的数值为3。
5. 单项选择题
2025年某县有8家大型建筑企业,这8家建筑企业的员工人数(单位: 人)分别为: 600 632 710 740 760 800 850 910 这组数据的中位数是()。
A. 740B. 750C. 760D. 800
答案 B 8个观测值的中位数为中间两个数的平均数,即(740+760)÷2=750人。
6. 单项选择题
2025年某地级市下辖10个县的粮食产量(单位:万吨)分别为: 65 65 78 87 92 108 119 155 156 158 这组数据的中位数是()。
A. 92B. 100C. 108D. 119
答案 B 10个数的中位数是第5个与第6个数的平均数:(92+108)÷2=100万吨。
7. 单项选择题
2025年某地级市下辖8个县的年末人口数(单位:万人)分别为: 25 28 44 48 52 66 72 105 这组数据的中位数是()。
A. 50B. 55C. 52D. 48
答案 A 8个数的中位数是第4个与第5个数的平均数:(48+52)÷2=50万人。
8. 单项选择题
用于顺序数据和数值型数据,特别是分布不对称的数值型数据的是( )。
A. 中位数B. 均值C. 标准差D. 众数
答案 A 中位数不适用于分类变量,适用于顺序变量和定量变量,特别是分布不对称的数值型 数据。
9. 单项选择题
下列统计量中,尤其适用于收入这类偏斜分布的数值型数据的是 ()。
A. 中位数B. 众数C. 均值D. 算术平均数
答案 A 中位数由排序位置决定,对极端值较稳健,尤其适合收入这类偏斜分布数据。均值容易受极端值影响;众数可用于数值数据,但可能不唯一或不稳定。
10. 单项选择题
样本量及居中的排序值不变,仅改变两端极端值的大小时,下列统计量中一定保持不变的是()。
A. 中位数B. 方差C. 均值D. 标准差
答案 A 中位数由排序后居中的一个或两个数确定,在这些值与样本量不变时保持不变。均值、方差和标准差一般会随极端值大小改变。

校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

11. 单项选择题
下面是抽样调查的10个学生的考试分数等级,分别为:不及格,中,中, 良,良,良,良,优,优,优。这10个学生分数的众数为()。
A. 优B. 中C. 良D. 不及格
答案 C 众数是指一组数据中出现次数(频数)最多的变量值,题目中良的出现次数最多, 所以应为良。
12. 单项选择题
下列指标中,用于描述数据集中趋势,并且易受极端值影响的是()。
A. 均值B. 中位数C. 众数D. 标准差
答案 A 选项A、B、C属于集中趋势测度值。其中,均值是易受极端值影响的集中趋势测 度值。选项D标准差对极端值也很敏感,但它是离散的测度值。
13. 多项选择题
下列关于中位数的说法,正确的有()。
A. 中位数是指一组数据中出现次数最多的变量值B. 中位数适用于不对称的定量数据C. 只改变尾部极端值大小而不改变样本量和中央排序值时,中位数不变D. 中位数能充分利用数据的全部信息E. 中位数适用于分类数据
答案 BC 中位数适用于顺序数据和数值型数据,对尾部极端值较稳健,常用于偏斜数据;它不利用每个观测值的具体大小,不能用于无序分类数据。

校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

14. 多项选择题
下列变量中,属于分类变量、适合用众数描述集中趋势的有()。
A. 某医院患者就诊疾病类型B. 某城市家庭月收入C. 某学校学生选修课程种类D. 某工厂产品合格率E. 消费者喜欢的手机品牌
答案 ACE 疾病类型、选修课程种类和手机品牌是分类变量,适合用众数概括,选ACE。收入和合格率是定量变量;这不意味着定量数据不能有众数。

校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

15. 多项选择题
关于众数的说法,正确的有()。
A. 众数是指一组数据中出现次数最多的变量值B. 定量数据也可以用众数描述最常出现的值C. 在频数结构不变且不发生取值合并时,改变非众数极端值的大小不改变众数D. 众数能充分利用数据的全部信息E. 众数可能不唯一
答案 ABCE 众数由最大频数对应的值确定,可用于数值数据,也可能有多个。在不改变频数结构、不把不同取值合并且仅改变非众数值大小时,众数不变;它没有利用全部数值信息。选ABCE。

校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

16. 多项选择题
关于均值的说法,正确的有()。
A. 均值就是平均数B. 均值大小受每个观测值的影响,比较稳定C. 均值的缺点是易受极端值的影响D. 均值适用于分类数据E. 均值适用于顺序数据
答案 ABC 均值主要适用于数值型数据,但不适用于分类数据和顺序数据。
17. 多项选择题
适于测度顺序数据的指标有()。
A. 方差B. 中位数C. 众数D. 均值E. 标准差
答案 BC 在集中趋势的测度值中,中位数和众数适用于顺序变量。
18. 多项选择题
下列统计量中,适用于定量数据的有()。
A. 均值B. 中位数C. 众数D. 方差E. 标准差
答案 ABCDE 均值、中位数、众数均可描述数值数据的集中趋势,方差和标准差描述其离散程度。众数可能不唯一或不稳定,但不能据此认定不适用于全部定量数据。
19. 单项选择题
采用分母N定义的总体方差,是总体各数值与其均值离差平方的()。
A. 中位数B. 众数C. 相关系数D. 平均数
答案 D 采用分母N的总体方差等于总体各数值与总体均值离差平方的算术平均数,选D。无偏样本方差通常使用分母n−1,需与此区分。

校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

20. 单项选择题
方差适用于测度统计数据分布的()。
A. 集中趋势B. 离散程度C. 偏态D. 相关程度
答案 B 方差是数据组中各数值与其均值离差平方的平均数,它能较好地反映出数据的离散 程度,是实际中应用最广泛的离散程度测度值。
21. 单项选择题
下列数据特征的测度中,能反映均值对数据代表程度的是()。
A. 众数B. 方差C. 偏态系数D. 相关系数
答案 B 方差反映数据与均值的离散程度。在可比口径下,方差越小,数据越集中于均值附近,均值代表性越好。
22. 单项选择题
下列关于标准差的表述,错误的是()。
A. 能够度量数值与均值的平均距离B. 用来测量数据的离散程度C. 与原始数值具有相同的计量单位D. 标准差越小,均值的代表性越差
答案 D 本题考查离散程度测度值。方差或标准差越小,均值的代表性越好。
23. 单项选择题
在同类数据、相同计量尺度的可比条件下,数据的离散程度越大,集中趋势测度值对该组数据的代表性通常()。
A. 越好B. 越差C. 始终不变D. 不确定
答案 B 数据的离散程度越大,集中趋势的测度值对该组数据的代表性越差。

校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

24. 单项选择题
离散系数主要用于不同类别数据离散程度的比较,其计算公式是() 之比。
A. 标准差与其相应的算术平均数B. 标准差与其相应的中位数C. 算术平均数与其相应的方差D. 标准差与其相应的几何平均数
答案 A 离散系数CV=s/x̄,即标准差除以算术平均数,通常用于均值为正、具有实际零点的数值数据的相对离散程度比较。
25. 单项选择题
根据2025年某城市金融业和制造业各1000人的年薪样本数据,比较这 两个行业从业人员年薪的离散程度,应采用的统计量是()。
A. 标准分数B. 相关系数C. 变异系数D. 偏态系数
答案 C 离散系数也称变异系数或标准差系数,即标准差与均值的比值,消除了测度单位和 观测值水平不同的影响,主要用于不同类别数据离散程度的比较。由于金融业和制造业属于 不同的行业类别,将两者数据进行比较时应采用变异系数。
26. 单项选择题
一组数据的标准差为25,均值为100,则这组数据的离散系数为()。
A. 0.1B. 0.25C. 0.05D. 1
答案 B CV=标准差÷均值=25÷100=0.25,选B。
27. 单项选择题
根据某单位员工的一组体检数据计算,身高变异系数CV=0.05,体重变异 系数CV=0.08。关于该单位员工体检数据的说法,正确的是()。
A. 体重数据的相对离散程度更大B. 身高数据的相对离散程度更大C. 身高和体重数据的相对离散程度相同D. 无法比较身高和体重数据的相对离散程度
答案 A 变异系数比较的是相对离散程度。体重CV=0.08大于身高CV=0.05,因此体重数据的相对离散程度更大,选A。

校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

28. 多项选择题
下列数据特征的测度值中,易受极端值影响的有()。
A. 均值B. 中位数C. 方差D. 众数E. 离散系数
答案 ACE 本题考查数据分布特征的各测度值,比较综合。均值会受到极端值的影响,方 差和离散系数的计算中都有均值,所以也会受到极端值的影响。
29. 多项选择题
关于数据离散程度的说法,正确的有()。
A. 离散程度反映的是数据之间的差异程度B. 离散程度反映的是数据分布的不对称性C. 集中趋势的测度值对一组数据的代表程度,取决于该组数据的离散程度D. 方差适用于测度数值型数据的离散程度E. 标准差测度数据离散程度时对极端值比较敏感
答案 ACDE 离散程度反映的是数据之间的差异程度。集中趋势的测度值对一组数据的代 表程度,取决于该组数据的离散水平。方差能较好地反映出数据的离散程度,是实际中应用最 广泛的离散程度测度值。标准差适用于数值型数据,对极端值也很敏感。
30. 多项选择题
关于方差的说法,正确的有()。
A. 方差越小,说明均值的代表性越好B. 方差是标准差的平方C. 样本方差计算公式中的分母是样本规模减1D. 方差是各数值与均值离差的平均数E. 方差对极端值比较敏感
答案 ABCE 方差是数据组中各数值与其均值离差平方的平均数,选项D错误。
31. 单项选择题
如果一组数据的分布是右偏的,则这组数据的偏态系数取值范围是()。
A. 大于0B. 小于0C. 绝对值小于1D. 绝对值大于1
答案 A 按教材的偏度分类,偏态系数为正表示右偏;0至0.5为轻度,0.5至1为中度,大于1为严重右偏。
32. 单项选择题
一组标准差非零的数值数据,其以三阶中心矩定义的偏态系数为0,可以确定的是()。
A. 三阶中心矩为0,但不能仅据此保证分布对称B. 轻度右偏C. 中度右偏D. 严重右偏
答案 A 矩偏度为三阶中心矩除以标准差的三次方。标准差非零且偏度为0,只能确定三阶中心矩为0,并不充分保证对称;例如[-3,-1,-1,-1,-1,-1,2,2,2,2]均值和三阶中心矩均为0但分布不对称,选A。

校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

33. 单项选择题
如果一组数据的偏态系数为 0.3,则该组数据的分布为()。
A. 轻度右偏B. 中度右偏C. 严重右偏D. 轻度左偏
答案 A 0.3为正且介于0与0.5之间,按教材经验分类为轻度右偏,选A。
34. 单项选择题
如果一组数据的偏态系数为10,则按教材分类,该组数据的分布为()。
A. 中度右偏B. 严重右偏C. 中度左偏D. 严重左偏
答案 B 偏态系数10为正且大于1,按教材分类为严重右偏,选B。

校勘说明:为明确统计定义、经验标准或教学条件所作的校订后教学题设,不冒充原题原文。

35. 单项选择题
( )可以给出数值距离均值的相对位置,用来比较不同变量的取值。
A. 偏态系数B. 离散系数C. 标准分数D. 标准差
答案 C 本题考查标准分数。来自不同分布的变量值不可比,但是每个数值在变量分布中相 对于均值的相对位置是可比的,因此可以通过计算标准分数来比较不同变量的取值。
36. 单项选择题
如果一个数据的标准分数是-3,表明该数据()。
A. 比平均数高出3个标准差B. 比平均数低3个标准差C. 等于3倍的平均数D. 等于3倍的标准差
答案 B 标准分数的计算方法是用数值减去均值所得的差除以标准差。
37. 单项选择题
当数据近似服从正态分布时,按经验法则,约95%的标准分数在()范围内。
A. [-1,+1]B. [-2,+2]C. [-3,+3]D. [-4,+4]
答案 B 近似正态分布的经验法则为68%—95%—99.7%,分别对应均值±1、±2、±3个标准差,故选B。

校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

38. 单项选择题
某组数据近似服从正态分布,均值60、标准差5。根据经验法则,约95%的数据在()范围内。
A. [55,65]B. [50,70]C. [45,75]D. [40,80]
答案 B 近似正态分布约95%的数据在均值±2个标准差内。下限=60−2×5=50,上限=60+2×5=70,故选B。

校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

39. 单项选择题
某企业客户月投诉量近似服从正态分布,均值80次、标准差15次。根据经验法则,约99.7%的月投诉量在()范围内。
A. [65,95]B. [50,110]C. [35,125]D. [70,100]
答案 C 约99.7%的数据在均值±3个标准差内,即80±3×15=[35,125],选C。

校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

40. 多项选择题
某企业员工年收入数据分布的偏态系数为3.0,则该组数据的分布形态 为()。
A. 右偏B. 左偏C. 轻度偏斜D. 严重偏斜E. 中度偏斜
答案 AD 偏态系数3.0为正且大于1,按教材经验分类为严重右偏,选AD。
41. 多项选择题
某企业员工考核得分近似服从正态分布,均值65、标准差5。以下说法正确的有()。
A. 约有65%的员工得分在[60,70]范围内B. 约有68%的员工得分在[60,70]范围内C. 约有90%的员工得分在[55,75]范围内D. 约有95%的员工得分在[50,80]范围内E. 约有99.7%的员工得分在[50,80]范围内
答案 BE 均值±1σ为[60,70],覆盖约68%;±2σ为[55,75],覆盖约95%;±3σ为[50,80],覆盖约99.7%。故选BE。

校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

42. 单项选择题
从两个定量变量的散点图中无法判断的是()。
A. 两个变量之间的相关方向B. 两个变量之间相关的强弱C. 两个变量相关的形状是否为线性D. 两个变量是否存在因果关系
答案 D 两个变量的散点图中,可以表示变量之间的相关方向、强弱、是否为线性,无法判断 是否存在因果关系。
43. 多项选择题
按相关的程度,两个变量之间的关系可以分为()。
A. 完全相关B. 正相关C. 不完全相关D. 不相关E. 负相关
答案 ACD 按变量间的相关程度可分为完全相关、不完全相关、不相关。
44. 多项选择题
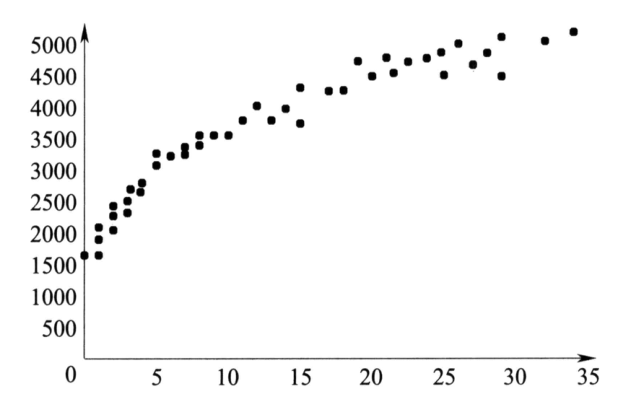
根据变量X和变量Y的散点图,可以看出这两个变量间的相关关系为( )。
原题散点图:横轴刻度0至35,纵轴刻度0至5000
A. 正相关B. 非线性相关C. 负相关D. 线性相关E. 完全相关
答案 AB 本题考查散点图。据图判断是正向的,但不是线性的。

校勘说明:按《经济基础知识(中级)章节同步习题集-304.pdf》原PDF第191页题面、第194页答案复核修正;保留原题答案。图像为原PDF散点图裁剪,仅移除周边题文,未重画数据点。

45. 多项选择题
下列统计方法中,适用于描述变量间相关关系的有()。
A. 散点图B. 离散系数C. 相关系数D. 标准分数E. 偏态系数
答案 AC 本题考查相关分析。对于变量之间的相关分析,经常采用的描述方法是散点图和 相关系数。
46. 单项选择题
变量X和变量Y的Pearson相关系数r=1,说明二者的相关关系是()。
A. 完全负线性相关B. 低度线性相关C. 完全正线性相关D. 不存在线性相关
答案 C Pearson相关系数r=1表示完全正线性相关;r=−1为完全负线性相关;r=0仅表示无线性相关,不能排除非线性关系。
47. 单项选择题
两个变量间的Pearson 相关系数为-0.9,则这两个变量间的相关关系为 ()。
A. 高度相关B. 中度相关C. 低度相关D. 无相关关系
答案 A 比较相关系数的绝对值。|r|=0.9≥0.8,按教材经验标准为高度线性相关;负号表示方向为负。
48. 单项选择题
两个变量的Pearson相关系数r=0.33,按教材经验标准,其相关关系可视为()。
A. 无线性相关关系B. 低度线性相关C. 中度线性相关D. 高度线性相关
答案 B 0.3≤|r|=0.33<0.5,按教材经验标准属于低度线性相关。

校勘说明:为明确统计定义、经验标准或教学条件所作的校订后教学题设,不冒充原题原文。

49. 单项选择题
下列Pearson相关系数中,表示线性相关程度最高的是()。
A. 0.82B. -0.93C. -0.58D. 0.9
答案 B 比较绝对值:0.93>0.90>0.82>0.58,故−0.93对应的线性相关程度最高,选B。

校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

50. 多项选择题
关于 Pearson 相关系数的说法,正确的有()。
A. Pearson 相关系数等于1,表明两个变量之间完全正线性相关B. Pearson 相关系数等于0,表明两个变量之间不存在任何关系C. Pearson 相关系数的绝对值大于0.8,说明两个变量之间存在高度相关关系D. Pearson 相关系数的取值可以大于1E. Pearson 相关系数小于0,表明两个变量之间为负线性相关
答案 ACE Pearson 相关系数等于0,只表示两个变量之间不存在线性相关关系,并不说明变 量之间没有任何关系,比如它们之间可能存在非线性相关关系,选项B错误。Pearson 相关系 数的取值范围在+1和-1之间,即-1≤r≤1,选项D错误。

7本章打卡

做完一项勾一项,当天页会自动更新整体进度。

学完这章就是往前走了一步。记不住的,明天再来看必背,不用今天全记住。

↑ 回到今日顶部

1重点一览

先花 2 分钟看清这章有几个考点、哪几个是必考,心里有数再读书。

8页教材2个 ★★★0个 ★★1个 ★53道章节题约 64 分钟教材印刷页 221-228
考点一 抽样调查基本概念★★★
考点二 基本概率抽样方法★★★
考点三 估计量和样本量★

2教材标色 + 三色笔记

左边是教材原文,彩色句子就是《考点速记》收了的内容,颜色是星级。右边是速记的考点表,和左边的小节对齐。读一节,看一眼右边的表,再往下走。

一、抽样调查基本概念

教材 P221

(一)基本概念

抽样调查是使用频率最高的一种调查方式。它是指按照某种原则和程序,从总体中抽取一部分单位,通过对这一部分单位进行调查得到信息,以达到对总体情况的了解,或者对总体的有关参数进行估计。下面先介绍几个基本概念。

1. 总体与样本。总体即调查对象的全体。例如,欲对北京市的个体商业进行抽样调查,则北京市所有的个体商业单位就构成一个总体。如果要研究某公司所有注册在职人员的工资状况,总体就是该公司所有注册在职员工。在一项具体的调查项目中,调查总体必须是明确的而不能是模糊的。

样本是总体的一部分,它由从总体中按一定原则或程序抽出的部分个体所组成。因此,与总体一样,样本也是一个集合。每个被抽中进入样本的单位称为入样单位。样本中包含的入样单位的个数称为样本量。抽样调查中调查的具体实施是针对样本而言的。

2. 总体参数与样本统计量。总体参数是我们所关心变量的数字特征,它是根据总体中所有单位的数值计算的。例如,在对北京市个体商业进行的调查中,北京市个体商业的年零售总额就是一个总体参数。也可以说总体参数就是总体指标值,它是未知的常数,是我们通过调查想要了解的,不受样本的抽选结果影响。常用的总体参数有总体总量、总体均值、总体比例、总体方差等。例如,某公司所有注册在职人员的平均工资,某城市拥有两套以上住房的人口比例等。

样本统计量是根据样本中各单位的数值计算的,是对总体参数的估计,因此也称为估计量。样本统计量是一个随机变量,它取决于样本设计和正好被选入样本的单元特定组合。例如,用样本中员工的平均工资来估计该公司所有注册在职人员的平均工资,这里,样本中员工的平均工资是该公司所有员工平均工资的一个估计量。常用的样本统计量有样本均值、样本比例、样本方差等。

3. 抽样框。抽样框是供抽样所用的所有抽样单元的名单,是抽样总体的具体表现。在抽样框中,可以对每个单位编上一个号码,由此可以按一定随机化程序进行抽样。在抽样后,调查人员也可以根据抽样框上所提供的信息找到被选中的入样单位,从而实施调查。

抽样框可以有多种形式,常用的有名录框,如企业名录、电话号码簿、人员名册等。抽样框也可以是一张地图或其他适当形式。但不管什么形式,抽样框中的单位必须是有序的,便于编号。高质量的抽样框应当提供被调查单位更多的信息,并且没有重复和遗漏。

(二)概率抽样与非概率抽样

根据抽取样本方法的不同,可以将抽样分为概率抽样和非概率抽样两类。

概率抽样也称随机抽样,是指依据随机原则,按照某种事先设计的程序,从总体中抽取部分单元的方法。概率抽样具有以下特点:①按一定的概率以随机原则抽取样本。所谓随机原则,就是在抽取样本时排除主观上有意识地抽取调查单元的情况,使每个单元都有一定的机会

教材 P222

被抽中。②总体中每个单元被抽中的概率是已知的,或者是可以计算出来的。③当采用样本对总体参数进行估计时,要考虑到每个样本单元被抽中的概率。也就是说,估计量不仅与对样本单元的观测有关,也与样本单元被选入样本的概率有关。概率抽样中,如果每个单位被抽入样本的概率相等,则称这种抽样方法为等概率抽样;如果每个单位被抽入样本的概率不同,则称为不等概率抽样。无论等概率或不等概率抽样,抽取时都要通过一定的随机化程序来实现。

非概率抽样又称为非随机抽样,是调查者根据自己的方便或主观判断抽取样本的方法,其最主要的特征是抽取样本时并不是依据随机原则。这类抽样有许多不同的具体抽取样本的方法,下面列举一些主要的方法:①判断抽样。这是指在抽取样本时,调查人员依据调查目的和对调查对象情况的了解,人为确定样本单元。例如,选择“平均型”单元作为样本,选定的样本可以代表所研究变量的平均水平。②方便抽样。这是指在抽取样本时,依据方便原则,以达到最大限度降低调查成本的目的。比如“拦截式”调查,在街边或居民小区拦住行人进行调查。③自愿样本。这是指不是经过抽取,而是由自愿接受调查的单元所组成的样本。比较典型的是网上调查。④配额抽样。这是指将总体中的各单元按一定标准划分为若干类型,将样本数额分配到各类型中,从各类型中抽取样本的方法则没有严格限制,一般采用方便抽样的方法抽取样本单元。

(三)抽样调查的一般步骤

一般而言,一个完整的抽样调查过程需要以下几个步骤。

1. 确定调查问题。确定调查问题所要回答的是“要做什么样的调查研究”和“为什么要做这项调查研究”。在这个过程中需要明确地定义问题,包括对整个问题的叙述以及确定研究问题的具体组成部分。

2. 调查方案设计。这一阶段,要明确如何实施调查,主要包括抽样方案的设计和问卷设计。抽样方案描述如何抽取样本,问卷设计则将比较抽象的调研问题逐步细化,演变为现场调查中采访者询问的、比较具体的问题的工作过程。

3. 实施调查过程。在这个过程中要获得样本单元的调查数据,关键的问题是要保证原始数据的质量,这就需要对调查过程进行有效的管理和监控。在调查过程中,要有管理制度和措施,使得从事具体调查的人员有章可循,按章操作。

4. 数据处理分析。这个过程包括对调查获得的原始数据进行检查、核对,对验收合格的数据进行编码和录入,对录入的数据进行预处理,对数据进行统计分析,对总体参数进行估计等。

5. 撰写调查报告。调查报告是调查活动的最终成果,是前面劳动成果的展现。

(四)抽样调查中的误差

样本估计值和总体参数真值之间的差异称为误差。凡调查就一定有误差,误差或大或小总会存在,不可能完全避免。一般来说,调查中的误差可以分为抽样误差和非抽样误差两大类。

抽样误差是由于抽样的随机性造成的,用样本统计量估计总体参数时出现的误差。对任何抽样方案,都会存在许多待选样本,实际中抽到的只是其中一个样本。抽到哪一个样本完全是随机的,而抽到不同的样本,对总体的估计就会不同,这就是抽样误差产生的根本原因。

非抽样误差是指除抽样误差以外,由其他原因引起的样本统计量与总体真值之间的差异。非抽样误差产生的原因主要有以下三种。

1. 抽样框误差。例如,用市场监督管理局签发的营业执照作为个体商业的抽样框,对个体商业实施抽样调查,以掌握个体商业零售额的情况。但有些个体商贩是无照经营,这部分零售

教材 P223

额就会漏掉。有些人虽有营业执照,但已经转行,不再经商。用抽样框中的单位数对总体零售额进行推估,也会造成误差。有些人虽然只有一个摊点,却办理了多个营业执照,他入选样本的概率就是其他人的数倍,使得在设计入样概率基础上的估计结果失真。凡此种种都是由于抽样框不完善造成的,故称其为抽样框误差。

2. 无回答误差。现场调查中由于各种原因,调查人员没能从被调查者那里得到所需要的数据。例如,被调查者不在家,因病无法接受调查,拒绝接受调查等。可以把无回答分为两类:一类是由于随机因素造成的,如调查时被调查者恰巧不在家,这种无回答减少了有效样本量,会造成估计量方差增大;另一类无回答是非随机因素的影响,如被调查者不愿告诉实情而拒绝回答。第二类情况下,回答者与不回答者在调查指标上存在数量的差异,调查的结果中只有回答者的信息,却没有无回答者的信息。这类无回答不仅造成估计量方差增大,还会带来估计偏差。

3. 计量误差。计量误差是指由于调查所获得的数据与其真值之间不一致造成的误差。这种误差可能是由调查人员、问卷设计、受访者等原因造成的。例如,调查员在调查中有意无意地诱导被调查者,调查中的提问错误或记录答案错误,调查人员有意作弊,由于问卷的原因受访者对调查问题的理解上有偏误,受访者记忆不清,受访者提供虚假数字等。

二、几种基本概率抽样方法

概率抽样中有不同的抽样方法,下面简要介绍几种最基本的方法。

(一)简单随机抽样

简单随机抽样分为有放回简单随机抽样和不放回简单随机抽样两种方法。有放回简单随机抽样是指从总体中随机抽出一个样本单位,记录观测结果后,将其放回总体中去,再抽取第二个,以此类推,直到抽满 n 个单位为止。采用这种方法,单位有被重复抽中的可能。这种抽样方法容易造成信息重复而影响估计的效率,所以较少采用。不放回简单随机抽样是指从包含 N 个单元的总体中逐个随机地抽取单元并不放回,每次都在所有尚未被抽入样本的单元中等概率地抽取下一个单元,直到抽取 n 个单元为止。采用这种方法,每个单元最多只能被抽中一次,故不会由于样本单位被重复抽中而提供重复信息,所以比有放回抽样的抽样误差低。

简单随机抽样是最基本的随机抽样方法,操作简单,且每个单位的入样概率相同,因而样本估计量形式也比较简单。但是,简单随机抽样没有利用抽样框中更多的辅助信息,所以用样本统计量估计总体参数的效率受到影响。同时,在简单随机抽样条件下,样本的分布可能十分分散,这就增加了调查过程中的费用和时间。这种抽样方法的适用条件是:①抽样框中没有更多可以利用的辅助信息;②调查对象分布的范围不广阔;③个体之间的差异不是很大。

(二)分层抽样

分层抽样是指先按照某种规则把总体分为不同的层,然后在不同的层内独立、随机地抽取样本,这样所得到的样本称为分层样本。如果每层中的抽样都是简单随机抽样,则称为分层随机抽样。分层抽样的优点如下。①分层抽样不仅可以估计总体参数,同时也可以估计各层的参数。例如,按照行业将某市所有中小企业进行分层,进行就业人口的抽样调查,最终不仅能估计全市中小企业就业的相关指标,还可以在各行业进行推算。②便于抽样工作的组织。例如,某项全国范围的大型抽样调查,要编制全国范围的抽样框往往是一件非常困难的事,但如果按行政区划或行业分层后,可以调动各级主管部门的积极性,分头编制抽样框并实施抽样的组织和调查工作。此外,为了组织调查的方便,各层还可以根据层内的特点,分别采用不同的

教材 P224

抽样方法。③每层都要抽取一定的样本单位,这样样本在总体中分布比较均匀,可以降低抽样误差。例如,某部门共有 6 名员工,其中 3 名经理、3 名普通职员,现要估计该部门的平均工资。他们的年薪见表 25-1。

表 25-1 某部门员工年薪

编号经理层(万元)普通职员层(万元)
1126
2146
3148
合计4020

虽然很容易算出总体均值 Ȳ = (40 + 20) ÷ 6 = 10(万元),仍用概率抽样方法随机抽取 2 人为样本,并用样本数据对总体均值进行估计。在简单随机抽样下,抽中年薪最少的 2 个人的样本均值为 ȳ1 = (6 + 6) ÷ 2 = 6(万元),年薪最多的 2 个人的样本均值为 ȳ2 = (14 + 14) ÷ 2 = 14(万元),显然与总体均值 10 万元相比误差都比较大。如果抽样前已经知道所有员工的职位信息,且知道不同职位的员工年薪有较大差异,则可以采用分层抽样,在经理层中抽一人,在普通职员层中抽一人,共同组成样本,这时样本最小的可能值为 ȳ1 = (12 + 6) ÷ 2 = 9(万元),最大的可能值为 ȳ2 = (14 + 8) ÷ 2 = 11(万元),显然分层抽样的估计值更集中在总体均值周围。

分层抽样中,样本量在各层中分配的方法可以归为两类:等比例分配和不等比例分配。等比例分配是指层中单位数越多,在该层中抽取的样本单位就越多,该层的样本单位比例与该层中的总体单位比例相一致,即 nh ÷ n = Nh ÷ N。这里,n 为样本量,nh 为第 h 层的样本量,N 为总体单位数,Nh 为第 h 层的总体单位数。等比例分配操作比较容易,也易于理解,在实践中被广泛使用。但在有些情况下需要使用不等比例分配方法。比如各层单位数相差悬殊,如果按等比例抽样,总体单位数少的层所分到的样本量过小,代表性不足,就需要在该层适当增大样本量;或者有些层内的方差过大,为了降低抽样误差,在方差大的层中多抽,在方差小的层中少抽,这些都属于不等比例抽样。显然,在条件具备时,如果各层的总体方差已知,不等比例抽样的抽样误差可能比等比例抽样更小。

分层抽样的应用条件是:抽样框中有足够的辅助信息,能够将总体单位按某种标准划分到各层之中,实现在同一层内各单位之间的差异尽可能地小,不同层之间各单位的差异尽可能地大。

(三)系统抽样

系统抽样是指先将总体中的所有单元按一定顺序排列,在规定范围内随机抽取一个初始单元,然后按事先规定的规则抽取其他样本单元。最简单的系统抽样是等距抽样,即将总体 N 个单位按直线排列,根据样本量 n 确定抽样间隔,即抽样间隔为 N ÷ n ≈ k,k 为最接近 N ÷ n 的一个整数。在 1 ~ k 范围内随机抽取一个整数 i,令位于 i 位置上的单位为起始单位,往后每间隔 k 抽取一个单位,直至抽满 n。

系统抽样的优点是:①操作简便。它只需要随机确定起始单位,整个样本就自然确定了。

教材 P225

②对抽样框的要求也比较简单。它只要求总体单位按一定顺序排列,而不一定是一份具体的名录清单。例如,欲对某城市汽车尾气排放情况进行调查,抽样比为 1%,即平均每 100 辆车中抽 1 辆,采用系统抽样,可以将汽车牌号作为一种排列,在 1 ~ 100 中随机抽取一个号,如 53,结果凡牌号末两位为 53 的车辆均作为样本单位。

系统抽样的缺点是方差估计比较复杂,这就会给计算抽样误差带来一定困难。

系统抽样的估计效果与总体单位排列顺序有关。如果排列顺序与调查内容没有联系,称为按无关标识排列,这时系统抽样估计与简单随机抽样估计效率相仿。如果排列顺序与调查内容有关,称为按有关标识排列。按有关标识排列的系统抽样精度一般比简单随机抽样的精度高。上例对汽车尾气排放情况的调查中,是按汽车牌号排列,牌号与尾气排放没有关系,属于按无关标识排列。如果是按汽车价格排列,价格与尾气排放量有相关性,则属于按有关标识排列。在后一种情况下的系统样本中,既有高档汽车,也有低价位的汽车,样本的结构与总体的结构十分相似,因而可以有效降低抽样误差。

(四)整群抽样

整群抽样是将总体中所有的基本单位按照一定规则划分为互不重叠的群,抽样时直接抽取群,对抽中的群调查其全部基本单位,对没有抽中的群则不进行调查。例如,欲调查某市在职的房地产行业人员工资水平,将房地产行业所有在职人员按照所属企业分群,直接抽取企业单位,入样的企业单位内所有职工均接受调查,没有入样的企业单位员工都不调查。相对于简单随机抽样,整群抽样的优点有:①实施调查方便,可以节省费用和时间。在总体单位分布很广的条件下,如采用简单随机抽样,样本的分布十分分散,调查实施有一定难度,费时费力。而群中各单位的分布非常集中,抽中一个群以后,在一个点上可以调查多个单位,调查效率较高。②抽样框编制得以简化,抽样时只需要群的抽样框,而不要求全部基本单位的抽样框。例如,调查房地产行业在职人员工资水平时,没有所有员工名单的抽样框,但是有当地房地产企业的抽样框,所以可以依据该抽样框抽取单位,然后对抽中的企事业单位,调查其所有在职人员的工资水平。

整群抽样的主要缺点是:由于抽取的样本单位比较集中,群内各单位之间存在相似性,差异比较小,而群与群之间的差别往往比较大,使得整群抽样的抽样误差比较大。为了达到一定的误差要求,就有必要增大样本量,如多抽取一些群进行调查。但是,如果群的构造是相反的情况,即群内各单位之间存在较大的差异,而群与群的结构相似,整群抽样反而会降低估计误差。例如,以家庭为群,采用整群抽样估计某地区的男女比例,家庭内成员之间存在很大差异(有男有女),而家庭与家庭之间的性别结构却十分相似(同样也是有男有女),在这个背景下整群抽样估计男女比例的误差就低于简单随机抽样。所以,整群抽样特别适合于对某些特殊群结构进行调查。

(五)多阶段抽样

在大规模抽样调查中,一次抽取到最终样本单位是很难实现的,往往需要经过两个或两个以上阶段才能抽到最终样本单位,这就是多阶段抽样方法。首先从总体中采用随机方法抽取若干个小总体,称为初级单元;再在这些选中的初级单元中随机抽取若干个单位。如果经过两个阶段抽样,抽取到接受调查的最终单位,称为二阶段抽样;如果经过三个阶段才抽取到接受调查的最终单位,称为三阶段抽样,以此类推。所以,多阶段抽样是对经过两个及两个以上抽样阶段的抽样方法的统称。

在大范围的抽样调查中,采用多阶段抽样是必要的。首先,在大范围抽样调查中,往往没

教材 P226

有包括所有总体单位的抽样框,或者编制这样的抽样框十分困难。多阶段抽样是分阶段进行的,抽样框也可以分级进行准备。在第一阶段抽样中,只需准备总体中关于初级单元的抽样框;在第二阶段抽样中,仅在那些被抽中的初级单元中准备第二阶段抽样所需的抽样框。其次,因为多阶段抽样是在选中的单位中进行再抽选,这样就使样本的分布相对集中,从而可以节省调查中的人力和财力。例如,全国性的居民入户调查,首先抽区县,然后在选中的区县中抽居委会(村委会),最后在选中的居委会(村委会)中抽取居民户。如果构造下一级抽样框的工作和抽取样本的工作能得到各级行政单位的配合,则为多阶段抽样的实施创造了十分有利的条件。

多阶段的抽样设计比较复杂,这里不仅涉及如何划分阶段,还包括在每个阶段上应当抽取多大样本量,以及每个阶段的抽样方法。此外,多阶段的抽样误差计算也比较复杂。

现实中的抽样设计经常是多种抽样方法的组合。比如两阶段抽样中,第一阶段采用分层随机抽样,第二阶段采用系统抽样。又如采用分层抽样时,不同层内可以采用不同抽样方法,某些层内采用简单随机抽样,某些层内采用系统抽样。不同的抽样方法下,估计量会呈现不同的性质。因此,抽样设计中除了设计样本单位的选择之外,还需要选择适用的样本估计量。

三、估计量和样本量

(一)估计量的性质

在不同的抽样方法下,同一估计量也会有不同的估计效果。在同一抽样方法下,也会有不同的估计量可供选择,什么样的估计量是好估计量,下面以不放回简单随机抽样下的总体均值估计为例,介绍几个常用的选择标准。

1. 估计量的无偏性。假设一个总体包含 6,7,8,9,10 这 5 个数字。虽然很容易计算出总体均值为 8,但为说明估计量的性质,仍采用不放回简单随机抽样的方法,从中抽取 2 个数字作为样本,并选用样本均值作为估计量。由于总体比较小,可以列出所有可能的样本及相应样本均值,见表 25-2。

表 25-2 可能的样本组合及样本均值

样本样本均值
6,76.5
6,87
6,97.5
6,108
7,87.5
7,98
7,108.5
8,98.5
8,109
9,109.5
教材 P227

一共有 10 种不同的样本,显然用样本均值估计总体均值时,对于不同的样本可以得到不同的估计值,这些估计值的均值为:

(1 ÷ 10) × (6.5 + 7 + 7.5 + 8 + 7.5 + 8 + 8.5 + 8.5 + 9 + 9.5) = 8

与总体均值 8 相等。实际上,对于不放回简单随机抽样,所有可能的样本均值取值的平均值总是等于总体均值,这就是样本均值估计量的无偏性。

2. 估计量的有效性。在同一抽样方案下,对某一总体参数 θ,如果有两个无偏估计量 θ̂1 和 θ̂2,由于样本的随机性,θ̂1 的可能样本取值较 θ̂2 更密集在总体参数真值 θ 附近,人们会认为 θ̂1 比 θ̂2 更有效。

由于方差是度量分布密集或离散状况的重要指标,估计量方差常用于描述抽样误差。估计量方差越大,说明用可能的样本估计值之间的差异越大,用样本统计量估计总体参数的效率就越低,抽样误差越大。因此,θ̂1 比 θ̂2 更有效,必然有 Var(θ̂1) < Var(θ̂2),即 θ̂1 的方差小于 θ̂2 的方差。

3. 估计量的一致性。随着样本量的增大,估计量的值如果稳定于总体参数的真值,这个估计量就有一致性,可称为一致估计量。

(二)抽样误差的估计

抽样误差虽然无法避免,但它是可计算的。调查人员可以计算抽样误差有多大,并采用适当的方式(如增大样本量)对其进行控制。下面以不放回简单随机抽样下均值估计量为例,简要介绍估计量方差的估计方法。

假设从总体的 N 个单元中按照不放回简单随机抽样方法抽取 n 个单元作为样本,用 Y1,Y2,…,YN 表示总体关于变量 Y 的 N 个观测值,用 y1,y2,…,yn 表示样本中的 n 个观测值。把样本均值 ȳ = (1 ÷ n) × Σyi 作为总体均值 Ȳ = (1 ÷ N) × ΣYi 的估计量,则估计量 ȳ 的方差为:

V(ȳ) = (1 − n ÷ N) × S² ÷ n

式中,S² = [1 ÷ (N − 1)] × Σ(Yi − Ȳ)²,为总体方差。

由上面的估计量方差可以看出:①抽样误差与总体分布有关,总体单位值之间差异越大,即总体方差 S² 越大,抽样误差就越大;②抽样误差与样本量 n 有关,在其他条件相同的情况下,样本量越大,抽样误差就越小。此外,抽样误差与抽样方式和估计量的选择也有关系。例如,分层抽样的估计量方差一般小于简单随机抽样。利用有效辅助信息也可以有效地减小抽样误差。

(三)样本量的计算

通常情况下,样本中所包含的样本单位数量(样本量,n)增大,相应样本估计量的抽样误差会减小;反之,样本中所包含的样本单位数量(样本量,n)减少,相应样本估计量的抽样误差会增大。在实际应用中,样本量的确定主要应考虑以下几方面因素。

1. 调查的精度。调查的精度是指用样本数据对总体进行估计时可以接受的误差水平。要求的调查精度越高(误差水平越小),所需要的样本量就越大。

2. 总体的离散程度。在其他条件相同的情况下,总体方差越大,所需要的样本量也越大。

教材 P228

3. 总体的规模。对于大规模的总体,总体规模对样本量的需求几乎没有影响。但是对小规模的总体,总体规模越大,为保证相同估计精度,样本量也要随之增大(但不是同比例的)。

4. 无回答情况。无回答减少了有效样本量。在无回答率较高的调查项目中,样本量要大一些,以减少无回答带来的影响。

5. 经费的制约。调查经费是影响样本量的一个十分重要的因素。事实上,样本量是调查经费与调查精度之间的某种折中和平衡。

此外,调查的限定时间、实施调查的人力资源也是影响样本量的客观因素。

不考虑费用限制、无回答情况及其他影响因素时,简单随机抽样的样本量计算公式为:

n0 = uα² × S² ÷ d²,n = n0 ÷ (1 + n0 ÷ N)

其中,N 为总体规模,当总体规模很大(N 大于 10000)时,总体规模 N 对样本量 n 的影响较小,样本量 n 接近于 n0。uα 为标准正态分布的双侧 α 分位数,在置信度(1 − α)为 95% 时 uα 值为 1.96。d 为绝对允许误差,用于表示一定的置信度(1 − α)下样本估计值 θ̂ 与总体参数 θ 之间的误差不超过某一给定的最大可能范围 Pr(|θ̂ − θ| ≤ d) = 1 − α,允许误差越小,表明人们就越相信抽样结果接近于“真实”。S² 为总体方差,总体方差 S² 未知时,一般用样本方差 s² 替代。在比例估计中,若 P 为总体比例,则总体方差 S² 计算公式为 P(1 − P)。

假定待估计的总体比例在 0.5 附近,总体规模(N)为 1000 万,当绝对允许误差分别为 0.01、0.03、0.05 时,简单随机抽样所需要的样本量分别为 9604、1068、385。随着样本量的增大,增加同等样本量所增加的精度幅度呈下降趋势。

3必背

这些是必须背下来的。先遮住右边一列,看左边考点名,自己说出内容,说不出来的做记号。

经济基础 第25章 抽样调查 必背

红 ★★★ 必考

考点必背内容
总体调查对象的全体;具体调查中总体必须明确,不能模糊
样本总体的一部分,也是一个集合;抽中进入样本的单位叫入样单位,入样单位的个数叫样本量;调查的具体实施针对样本
抽样框供抽样用的所有抽样单元的名单,是抽样总体的具体表现;单位必须有序、便于编号;高质量抽样框要信息多、无重复无遗漏
总体参数按总体中所有单位数值算出来的总体指标值;是未知的常数,不受样本抽选结果影响;常见:总体总量、总体均值、总体比例、总体方差
样本统计量按样本中各单位数值算的,是对总体参数的估计,又叫估计量;是随机变量;常见:样本均值、样本比例、样本方差
概率抽样又叫随机抽样,依据随机原则按事先设计的程序抽;三特点:随机原则抽、每个单元被抽中概率已知或可算、估计时要考虑各单元被抽中的概率
非概率抽样又叫非随机抽样,靠方便或主观判断抽,最主要特征是不依据随机原则;四种「判方愿配」:判断抽样(人为定样本)、方便抽样(拦截式调查)、自愿样本(网上调查)、配额抽样(先分类型,再分配样本数额)
抽样误差由抽样的随机性造成;根本原因:抽到不同的样本,对总体的估计就不同;不可避免但可计算、可控制
非抽样误差除抽样误差以外的其他原因造成的差异;三种来源「框、答、量」:抽样框误差(重复、遗漏)、无回答误差(随机不在家 + 主观不愿答)、计量误差(诱导、提问错、作弊、理解偏、记忆不清、弄虚作假)
简单随机抽样分有放回和不放回两种;不放回误差更低,有放回较少用;适用条件三条:没有更多辅助信息、对象分布范围不广、个体差异不大
分层抽样先分层,再各层内独立随机抽;每层都简单随机抽叫分层随机抽样;优点三条:能估各层参数、便于组织、每层都抽从而降低抽样误差;应用条件:有足够辅助信息,层内差异小、层间差异大
系统抽样排好顺序,随机定起点,按规则往后抽;优点:操作简便、对抽样框要求低(只要有序不必有名单);缺点:方差估计复杂,算抽样误差难
整群抽样分成互不重叠的群,直接抽群,抽中的群全查、没抽中的不查;优点:省费用时间、只需群的抽样框;缺点:群内相似群间差异大,抽样误差大,要增大样本量(多抽几个群)
多阶段抽样经过两个及两个以上抽样阶段的抽样方法的统称

黄 ★★ 重点

本章速记里没有 ★★ 考点,只有两个 ★★★ 和一个 ★。

绿 ★ 里会考的点

考点必背内容
好估计量三性质无偏性(所有可能样本均值的平均值 = 总体均值)、有效性(取值越密集在真值附近越有效,方差小)、一致性(样本量越大越稳定于真值)
抽样误差影响因素总体方差越大误差越大;样本量越大误差越小;和抽样方式、估计量选择有关(分层抽样方差一般小于简单随机抽样);利用辅助信息可减小误差
样本量影响因素「精、散、模、答、钱」:精度越高样本越大;总体越离散样本越大;大总体几乎不影响、小总体越大样本要随之增大(非同比例);无回答率高要多抽;经费是精度和经费的折中;另有时间和人力

数字与公式清单

  • 分层抽样等比例分配:nh ÷ n = Nh ÷ N(该层样本比例 = 该层在总体中的比例)
  • 系统抽样抽样间隔:N ÷ n ≈ k(k 取最接近的整数),在 1 ~ k 里随机选起点 i,以后每隔 k 抽一个
  • 不放回简单随机抽样均值估计量方差:V(ȳ) = (1 − n ÷ N) × S² ÷ n,S² 为总体方差
  • 简单随机抽样样本量:n0 = uα² × S² ÷ d²,n = n0 ÷ (1 + n0 ÷ N);N 大于 10000 时 n 接近 n0
  • 95% 置信度对应 uα = 1.96;比例估计的总体方差 S² = P(1 − P)
  • 总体比例 0.5 附近、N 为 1000 万时,允许误差 0.01、0.03、0.05 对应样本量 9604、1068、385
  • 教材例子:6 名员工年薪,简单随机抽 2 人均值范围 6 到 14 万元,分层抽样范围 9 到 11 万元,总体均值 10 万元
  • 教材例子:总体 6、7、8、9、10,抽 2 个共 10 种样本,样本均值的平均值 = 8 = 总体均值(无偏性)

4总结

一页纸看完整章。二轮快刷和考前只看这里和必背。

经济基础 第25章 抽样调查 一页纸总结

本章一句话

不可能把所有人都问一遍,所以从总体里抽一部分(样本)来推全体。这章讲三件事:抽样要用哪些词(总体、样本、抽样框、参数、统计量)、误差从哪来、五种抽法怎么抽(简单随机、分层、系统、整群、多阶段),最后附带讲什么叫好的估计量、样本要抽多少。

章末总览表

考点星级一句话要点考法
考点一 抽样调查基本概念★★★总体参数是未知常数、样本统计量是随机变量;概率抽样三特点、非概率抽样四种「判方愿配」;抽样误差由随机性造成,非抽样误差三来源「框、答、量」单选(概念辨析)、多选(概率抽样特点、非概率抽样方法、非抽样误差来源)
考点二 基本概率抽样方法★★★五种方法「简分系群多」各自的含义、优缺点、适用条件;分层要层内像层间不像,整群误差大要多抽群,系统抽样简便但方差难算单选(给场景判断是哪种抽样)、多选(某种方法的优点或适用条件)
考点三 估计量和样本量★好估计量三性:无偏、有效、一致;抽样误差随总体方差增大、随样本量减小;样本量五因素「精、散、模、答、钱」单选、多选(影响因素方向题)

易错坑

  1. 总体参数不受样本影响,它是固定的真值;会随样本变的是样本统计量(估计量)。
  2. 配额抽样也「分类」,但它是非概率抽样;分层抽样才是概率抽样。题目里出现「按方便原则」「人为确定」「自愿」就是非概率。
  3. 分层抽样和整群抽样的区别:分层是每层都抽一部分,整群是抽几个群、抽中的群全查。分层要层内差异小,整群最怕群内差异小(会让误差变大)。
  4. 系统抽样的缺点是「方差估计复杂」,整群抽样的缺点才是「抽样误差大」,别互换。
  5. 总体规模对样本量的影响:大总体(大于 10000)几乎没影响,小总体才随之增大且不是同比例;不是「总体越大样本一定按比例越大」。

和前后章的关系

第 24 章描述统计讲的均值、方差是本章估计量和总体方差的基础,本章把「拿样本推总体」的过程讲清楚,抽样误差的公式里就用到了总体方差。后面第 26 章回归分析、第 27 章时间序列都是在拿到样本数据之后做分析,本章是数据从哪来的那一步。

5解读(读透版讲义)

哪里没看懂,来这里看大白话讲解。生活例子、考法、坑都在这。可以先读这个再回去读教材。

抽样调查(教材原文·OCR)

文字为主,公式/图表以教材扫描为准。配套精华看复习网页。

第二十五章 抽样调碍

一\抽样调查基本概念

( 一 )基本概念

抽样调查是使用频率最高的一种调查方式。它是指按照某种原则和程序,从总体中抽取
一部分单位,通过对这一部分单位进行调查得到信息,以达到对总体情况的了解 ,或者对总体
的有关参数进行估计。下面先介绍几个基本概念。

  1. 总体与样本。总体即调查对象的全体。例如 ,欲对北京市的个体商业进行抽样调查,则

北京市所有的个体商业单位就构成一个总体。如果要研究某公司所有注册在职人员的工资状
况,总体就是该公司所有注册在职员工。在一项具体的调查项目中,调查总体必须是明确的而
不能是模糊的。

样本是总体的一部分,它由从总体中按一定原则或程序抽出的部分个体所组成。因此,与
总体一样,样本也是一个集合。每个被抽中进入样本的单位称为人样单位。样本中包含的人
样单位的个数称为样本量。抽样调查中调查的具体实施是针对样本而言的。

  1. 总体参数与样本统计量。总体参数是我们所关心变量的数字特征,它是根据总体中所

有单位的数值计算的。例如,在对北京市个体商业进行的调查中 ,北京市个体商业的年零售总
额就是一个总体参数。也可以说总体参数就是总体指标值,它是未知的常数,是我们通过调查
想要了解的,不受样本的抽选结果影响。常用的总体参数有总体总量 ,总体均值 ,总体比例 总
体方差等。例如,某公司所有注册在职人员的平均工资,某城市拥有两套以上住房的人口比例
等。

样本统计量是根据样本中各单位的数值计算的,是对总体参数的估计,因此也称为估计
量。样本统计量是一个随机变量,它取决于样本设计和正好被选和人样本的单元特定组合。例
如,用样本中员工的平均工资来估计该公司所有注册在职人员的平均工资,这里,样本中员工
的平均工资是该公司所有员工平均工资的一个估计量。常用的样本统计量有样本均值.样本
比例,样本方差等。

  1. 抽样框。抽样框是供抽样所用的所有抽样单元的名单 ,是抽样总体的具体表现。在抽

样框中,可以对每个单位编上一个号码,由此可以按一定随机化程序进行抽样。在抽样后,调
查人员也可以根据抽样框上所提供的信息找到被选中的人样单位,从而实施调查。

抽样框可以有多种形式,常用的有名录框,如企业名录 .电话每人员名册等。抽样框也可
以是一张地图或其他适当形式。但不管什么形式,抽样框中的单位必须是有序的,便于编号。
高质量的抽样框应当提供被调查单位更多的信息,并且没有重复和遗漏。

( 二 )概率抽样与非概率抽样

根据抽取样本方法的不同,可以将抽样分为概率抽样和非概率抽样两类。

概率抽样也称随机抽样,是指依据随机原则 ,按照某种事先设计的程序,从总体中抽取部
分单元的方法。概率抽样具有以下特点: 四按一定的概率以随机原则抽取样本。所谓随机原
则 ,就是在抽取样本时排除主观上有意识地抽取调查单元的情况,使每个单元都有一定的机会

"222 .经济基础知识 (中级)

被抽中。@)总体中每个单元被抽中的概率是已知的,或者是可以计算出来的。图当采用样本
对总体参数进行估计时,要考虑到每个样本单元被抽中的概率。也就是说,估计量不仅与对样
本单元的观测有关,也与样本单元被选人样本的概率有关。概率抽样中,如果每个单位被抽
入样本的概率相等,则称这种抽样方法为等概率抽样; 如果每个单位被抽入样本的概率不同,
则称为不等概率抽样。无论等概率或不等概率抽样 ,抽取时都要通过一定的随机化程序来实
现。

非概率抽样又称为非随机抽样,是调查者根据自己的方便或主观判断抽取样本的方法,其
最主要的特征是抽取样本时并不是依据随机原则。这类抽样有许多不同的具体抽取样本的方
法,下面列举一些主要的方法: 四判断抽样。这是指在抽取样本时,调查人员依据调查目的和
对调查对象情况的了解,人为确定样本单元。例如 ,选择“平均型 单元作为样本 ,选定的样本
可以代表所研究变量的平均水平。@)方便抽样。这是指在抽取样本时 ,依据方便原则 ,以达到
最大限度降低调查成本的目的。比如“拦截式" 调查,在街边或居民小区拦住行人进行调查。
图自愿样本。这是指不是经过抽取,而是由自愿接受调查的单元所组成的样本。比较典型的
是网上调查。色配额抽样。这是指将总体中的各单元按一定标准划分为若干类型,将样本数
额分配到各类型中,从各类型中抽取样本的方法则没有严格限制 ,一般采用方便抽样的方法抽
取样本单元。

( 三 )抽样调查的一般步又

一般而言 ,一个完整的抽样调查过程需要以下几个步骤。

  1. 确定调查问题。确定调查问题所要回答的是“要做什么样的调查研究”和“为什么要

做这项调查研究”。在这个过程中需要明确地定义问题,包括对整个问题的叙述以及确定研究
问题的具体组成部分。

  1. 调查方案设计。这一阶段,要明确如何实施调查, 主要包括抽样方案的设计和问卷设

计。抽样方案描述如何抽取样本,问卷设计则将比较抽象的调研问题逐步细化,演变为现场调
查中采访者询问的.比较具体的问题的工作过程。

  1. 实施调查过程。在这个过程中要获得样本单元的调查数据,关键的问题是要保证原始

数据的质量,这就需要对调查过程进行有效的管理和监控。在调查过程中,要有管理制度和措
施,使得从事具体调查的人员有章可循,按章操作。

  1. 数据处理分析。这个过程包括对调查获得的原始数据进行检查 ,核对,对验收合格的数

据进行编码和录入,对录入的数据进行预处理,对数据进行统计分析,对总体参数进行估计等。

  1. 撰写调查报告。调查报告是调查活动的最终成果,是前面劳动成果的展现。

(四 )抽样调查中的误差

样本估计值和总体参数真值之问的差异称为误差。凡调查就一定有误差,误差或大或小
总会存在,不可能完全避免。一般来说,调查中的误差可以分为抽样误差和非抽样误差两大类。

抽样误差是由于抽样的随机性造成的,用样本统计量估计总体参数时出现的误差。对任
何抽样方案,都会存在许多待选样本,实际中抽到的只是其中一个样本。抽到哪一个样本完全
是随机的,而抽到不同的样本,对总体的估计就会不同,这就是抽样误差产生的根本原因。

非抽样误差是指除抽样误差以外,由其他原因引起的样本统计量与总体真值之间的差异。
非抽样误差产生的原因主要有以下三种。

  1. 抽样框误差。例如,用市场监督管理局签发的营业执照作为个体商业的抽样框,对个体

商业实施抽样调查,以掌握个体商业零售额的情况。但有些个体商贩是无照经营,这部分零售

第二让五章,抽“*样"调查 '223,

额就会漏掉。有些人虽有营业执照,但已经转行,不再经商。用抽样框中的单位数对总体零售
额进行推估,也会造成误差。有些人虽然只有一个摊点,却办理了多个营业执照,他人选样本
的概率就是其他人的数倍,使得在设计人样概率基础上的估计结果失真。凡此种种都是由于

  1. 无回答误差。现场调查中由于各种原因,调查人员没能从被调查者那里得到所需要的

数据。例如,被调查者不在家,因病无法接受调查,拒绝接受调查等。可以把无回答分为两类:
一类是由于随机因素造成的,如调查时被调查者恰巧不在家,这种无回答减少了有效样本量,会
造成估计量方差增大; 另一类无回答是非随机因素的影响,如被调查者不愿告诉实情而拒绝回
答。第二类情况下 ,回答者与不回答者在调查指标上存在数量的差异 ,调查的结果中只有回答
者的信息,却没有无回答者的信息。这类无回答不仅造成估计量方差增大,还会带来估计偏差。

  1. 计量误差。计量误差是指由于调查所获得的数据与其真值之间不一致造成的误差。这

种误差可能是由调查人员 ,问卷设计 `受访者等原因造成的。例如,调查员在调查中有意无意
地诱导被调查者,调查中的提问错误或记录答案错误,调查人员有意作弊,由于问卷的原因受
访者对调查问题的理解上有偏误,受访者记忆不清,受访者提供虚假数字等。

二\几种基本概率抽样方法

概率抽样中有不同的抽样方法,下面简要介绍几种最基本的方法。

( 一)简单随机抽样

简单随机抽样分为有放回简单随机抽样和不放回简单随机抽样两种方法。有放回简单随
机抽样是指从总体中随机抽出一个样本单位,记录观测结果后,将其放回总体中去,再抽取第
二个,以此类推,直到抽满个单位为止。采用这种方法,单位有被重复抽中的可能。这种抽
样方法容易造成信息重到而影响估计的效率,所以较少采用。不放回简单随机抽样是指从包
含 个单元的总体中逐个随机地抽取单元并不放回 ,每次都在所有尚未被抽和样本的单元中
等概率地抽取下一个单元,直到抽取半个单元为止。采用这种方法,每个单元最多只能被抽中
一次,故不会由于样本单位被重复抽中而提供重琶信息,所以比有放回抽样的抽样误差低。

简单随机抽样是最基本的随机抽样方法,操作简单 ,且每个单位的入样概率相同,因而样
本估计量形式也比较简单。但是,简单随机抽样没有利用抽样框中更多的辅助信息,所以用样
本统计量估计总体参数的效率受到影响。同时,在简单随机抽样条件下 ,样本的分布可能十分
分散,这就增加了调查过程中的费用和时间。这种抽样方法的适用条件是: 中抽样框中没有更
多可以利用的辅助信息; @)调查对象分布的范围不广阔; @个体之间的差异不是很大。

( 二 )分层抽样

分层抽样是指先按照某种规则把总体分为不同的层,然后在不同的层内独立 .随机地抽取
样本,这样所得到的样本称为分层样本。如果每层中的抽样都是简单随机抽样 ,则称为分层随
机抽样。分层抽样的优点如下。钙分层抽样不仅可以估计总体参数,同时也可以估计各层的
参数。例如,按照行业将某市所有中小企业进行分层,进行就业人口的抽样调查,最终不仅能
估计全市中小企业就业的相关指标,还可以在各行业进行推算。@便于抽样工作的组织。例
如,某项全国范围的大型抽样调查,要编制全国范围的抽样框往往是一件非常困难的事,但如
果按行政区划或行业分层后,可以调动各级主管部门的积极性,分头编制抽样框并实施抽样的
组织和调查工作。此外,为了组织调查的方便,各层还可以根据层内的特点,分别采用不同的

. 224 ”经济基础知识 (中级)

抽样方法。@)每层都要抽取一定的样本单位,这样样本在总体中分布比较均匀,可以降低抽
样误差。例如,某部门共有6 名员工,其中3 名经理.3 名普通职员 ,现要估计该部门的平均工
资。他们的年薪见表 25-1。

表 25-1 某部门员工年薪
编号 经理层( 万元 ) 普通职员层( 万元 )
1 12 6
2 14 6
3 14 8
合计 40 20
虽然很容易算出总体均值子=各二2 -10( 万元),仍用概率抽样方法随机抽取 2 人为样

本,并用样本数据对总体均值进行估计。在简单随机抽样下 ,抽中年薪最少的 2 个人的样本

均值为 放 =@ 二6 =6( 万元 ),年薪最多的 2 个人的样本均值为元 = 地半地 = 14(万元)显然
与总体均值 10 万元相比误差都比较大。如果抽样前已经知道所有员工的职位信息,且知着
不同职位的员工年薪有较大差异,则可以采用分层抽样,在经理层中抽一人,在普通职员层

中抽一人,共同组成样本,这时样本最小的可能值为 亢 = 也:*6 =9( 万元),最大的可能值为
元=革汪= 11(万元)显然分层抽样的估计值更集中在总体均值周轩。

分层抽样中,样本量在各层中分配的方法可以归为两类: 等比例分配和不等比例分配。
等比例分配是指层中单位数越多,在该层中抽取的样本单位就越多,该层的样本单位比例与该
层中的总体单位比例相一致,即 六 = 让。 这里 , 为样本量,mw 为第大层的样本量, N 为总体音
位数,N 为第坟层的总体单位数。等比例分配操作比较容易,也易于理解,在实践中被广泛使
用。但在有些情况下需要使用不等比例分配方法。比如各层单位数相差悬殊,如果按等比例
抽样,总体单位数少的层所分到的样本量过小,代表性不足,就需要在该层适当增大样本量;或
者有些层内的方差过大,为了降低抽样误差,在方差大的层中多抽,在方差小的层中少抽,这些
都属于不等比例抽样。显然,在条件具备时,如果各层的总体方差已知,不等比例抽样的抽样
误差可能比等比例抽样更小。

分层抽样的应用条件是: 抽样框中有是够的辅助信息,能够将总体单位按某种标准划分
到各层之中,实现在同一层内各单位之间的差异尽可能地小,不同层之间各单位的差异尽可能
地大。

( 三 )系统抽样

系统抽样是指先将总体中的所有单元按一定顺闯排列,在规定范围内随机抽取一个初始
单元,然后按事先规定的规则抽取其他样本单元。最简单的系统抽样是等距抽样,即将总体
W 个单位按直线排列,根据样本量 ”确定抽样间隔,即抽样间隔为 定~刀上为最接近六 的一
个整数。在 1趟范围内随机抽取一个整数.令位于;i 位置上的单位为起始单位,往后每间隔
抽取一个单位,直至抽满/。

系统抽样的优点是: 四操作简便。它只需要随机确定起始单位,整个样本就自然确定了。

第二让亚章”,抽*样"调查 225,

@)对抽样框的要求也比较简单。它只要求总体单位按一定顺序排列,而不一定是一份具体的
名录清单。例如 ,欲对某城市汽车尾气排放情况进行调查,抽样比为 1%,即平均每 100 辆车中
抽 1 辆,采用系统抽样,可以将汽车牌号作为一种排列,在 1~100 中随机抽取一个号,如 53 ,结
果凡牌号末两位为 53 的车辆均作为样本单位。

系统抽样的缺点是方差估计比较复杂,这就会给计算抽样误差带来一定困难。

系统抽样的估计效果与总体单位排列顺序有关。如果排列顺序与调查内容没有联系 ,称
为按无关标识排列,这时系统抽样估计与简单随机抽样估计效率相仿。如果排列顺序与调查
内容有关,称为按有关标识排列。按有关标识排列的系统抽样精度一般比简单随机抽样的精
度高。上例对汽车尾气排放情况的调查中,是按汽车牌号排列 ,牌号与尾气排放没有关系,属
于按无关标识排列。如果是按汽车价格排列,价格与尾气排放量有相关性,则属于按有关标识
排列。在后一种情况下的系统样本中,既有高档汽车,也有低价位的汽车,样本的结构与总体
的结构十分相似,因而可以有效降低抽样误差。

(四 )整群抽样

整群抽样是将总体中所有的基本单位按照一定规则划分为互不重到的群,抽样时直接抽
取群,对抽中的群调查其全部基本单位,对没有抽中的群则不进行调查。例如,和欲调查某市在
职的房地产行业人员工资水平,将房地产行业所有在职人员按照所属企业分群,直接抽取企业
单位,和人样的企业单位内所有职工均接受调查,没有入样的企业单位员工都不调查。相对于简
单随机抽样,整群抽样的优点有: @实施调查方便,可以节省费用和时间。在总体单位分布很
广的条件下 ,阁采用简单随机抽样 ,样本的分布十分分散,调查实施有一定难度,费时费力。而
群中各单位的分布非常集中 ,抽中一个群以后,在一个点上可以调查多个单位,调查效率较高。
@抽样框编制得以简化,抽样时只需要群的抽样框,而不要求全部基本单位的抽样框。例如,
调查房地产行业在职人员工资水平时,没有所有员工名单的抽样框,但是有当地房地产企业的
抽样框,所以可以依据该抽样框抽取单位,然后对抽中的企事业单位 ,调查其所有在职人员的
工资水平。

整群抽样的主要缺点是: 由于抽取的样本单位比较集中,群内各单位之间存在相似性,差
异比较小 ,而群与群之间的差别往往比较大,使得整群抽样的抽样误差比较大。为了达到一定
的误差要求,就有必要增大样本量,如多抽取一些群进行调查。但是,如果群的构造是相反的
情况,即群内各单位之间存在较大的差异 ,而群与群的结构相似,整群抽样反而会降低估计误
差。例如,以家庭为群,采用整群抽样估计某地区的男女比例,家庭内成员之间存在很大差异
(有男有女 ),而家庭与家庭之间的性别结构却十分相似( 同样也是有男有女 ),在这个背景
整群抽样估计男女比例的误差就低于简单随机抽样。所以,整群抽样特别适合于对某些特殊
群结构进行调查。

(五 )多阶段抽样

在大规模抽样调查中 ,一次抽取到最终样本单位是很难实现的,往往需要经过两个或两个
以上阶段才能抽到最终样本单位,这就是多阶段抽样方法。首先从总体中采用随机方法抽取
若干个小总体,称为初级单元; 再在这些选中的初级单元中随机抽取若干个单位。如果经过两
个阶段抽样,抽取到接受调查的最终单位 ,称为二阶段抽样; 如果经过三个阶段才抽取到接受
调查的最终单位,称为三阶段抽样,以此类推。所以,多阶段抽样是对经过两个及两个以上抽
样阶段的抽样方法的统称。

在大范围的抽样调查中,采用多阶段抽样是必要的。首先,在大范围抽样调查中 ,往往没

“ 226 ”经济基础知误 (中级)

有包括所有总体单位的抽样框,或者编制这样的抽样框十分困难。多阶段抽样是分阶段进行
的,抽样框也可以分级进行准备。在第一阶段抽样中,只需准备总体中关于初级单元的抽样
框; 在第二阶段抽样中,仅在那些被抽中的初级单元中准备第二阶段抽样所需的抽样框。其
次,因为多阶段抽样是在选中的单位中进行再抽选,这样就使样本的分布相对集中,从而可以
节省调查中的人力和财力。例如,全国性的居民入户调查,首先抽区县,然后在选中的区县中
抽居委会( 村委会 ),最后在选中的居委会( 村委会 )中抽取居民户。如果构造下一级抽样杠
的工作和抽取样本的工作能得到各级行政单位的配合,则为多阶段抽样的实施创造了十分有
利的条件。

多阶段的抽样设计比较复杂,这里不仅涉及如何划分阶段,还包括在每个阶段上应当抽取
多大样本量,以及每个阶段的抽样方法。此外,多阶段的抽样误差计算也比较复杂。

现实中的抽样设计经常是多种抽样方法的组合。比如两阶段抽样中,第一阶段采用分层
随机抽样,第二阶段采用系统抽样。又如采用分层抽样时,不同层内可以采用不同抽样方法,
某些层内采用简单随机抽样 ,某些层内采用系统抽样。不同的抽样方法下 ,估计量会呈现不同
的性质。因此 ,抽样设计中除了设计样本单位的选择之外,还需要选择适用的样本估计量。

三\估计量和样本量

(一)估计量的性质

在不同的抽样方法下 ,同一估计量也会有不同的估计效果。在同一抽样方法下 ,也会有不
同的估计量可供选择,什么样的估计量是好估计量, 下面以不放回简单随机抽样下的总体均值
估计为例 ,介绍几个常用的选择标准。

  1. 估计量的无偏性。假设一个总体包含 6,7, 8, 9, 10 这 5 个数字。虽然很容易计算出总

体均值为8,但为说明估计量的性质,仍采用不放回简单随机抽样的方法,从中抽取 2 个数字
作为样本 ,并选用样本均值作为估计量。由于总体比较小,可以列出所有可能的样本及相应样
本均值,见表 25-2。

表 25-2 可能的样本组合及样本均值
样本 样本均值
6,7 6.5
6,8 7
6,9 7.5
6, 10 8
7,8 7.5
7,9 8
7,10 8.5
8,9 8.5
8,10 9
9, 10 9.5

第二让五章”,抽“*样"调`查 227,

一共有 10 种不同的样本,显然用样本均值估计总体均值时,对于不同的样本可以得到不
同的估计值,这些估计值的均值为:
疝x(6.5 +7+7.5+8+7.5+8+8.5+8.5+9+9.5) =8

与总体均值 8 相等。实际上,对于不放回简单随机抽样,所有可能的样本均值取值的平均
值总是等于总体均值,这就是样本均值估计量的无偏性。

  1. 估计量的有效性。在同一抽样方案下,对某一总体参数 b ,如果有两个无偏估计量 b

和 饭 ,由于样本的随机性,b 的可能样本取值较 b. 更密集在总体参数真值 6 附近,人们会认
为 比 负 更有效。

由于方差是度量分布密集或离散状况的重要指标,估计量方差常用于描述抽样误差。估
计量方差越大,说明用可能的样本估计值之间的差异越大,用样本统计量估计总体参数的效率
就越低 ,抽样误差越大。因此,6 比 岂 更有效,必然有 Var(b ) 一 Var(外),即 b 的方差小于
6 的方差。

  1. 估计量的一致性。随着样本量的增大,估计量的值如果稳定于总体参数的真值 ,这个估

计量就有一致性,可称为一致估计量。

( 二 )抽样误差的估计

抽样误差虽然无法避免,但它是可计算的。调查人员可以计算抽样误差有多大,并采用适
当的方式( 如增大样本量 ) 对其进行控制。下面以不放回简单随机抽样下均值估计量为例 ,简

要介绍估计量方差的估计方法。

假设从 生体间上个旦于中入时不放四午间请机销杰方法掉取"人于下作为本,

用妃,克,: 天起休关于灾昌了的个再测全 用入, 力,…,六表示样本中的个

观测值。把样本均值 了=圭 二> 作为总体均值了=二 攻之 的估计量,则估计量了的方差

K刀=(1 -二上

式中,= 六> (也 - 芒? ,为总体方差。

由上面的估计量方差可以看出: 中抽样误差与总体分布有关,总体单位值之间差异越大,
即总体方差 $ 越大,抽样误差就越大; @抽样误差与样本量z 有关,在其他条件相同的情况
下 ,样本量越大,抽样误差就越小。此外,抽样误差与抽样方式和估计量的选择也有关系。例
如,分层抽样的估计量方差一般小于简单随机抽样。利用有效辅助信息也可以有效地减小抽

( 三 )样本量的计算

通常情况下 ,样本中所包含的样本单位数量(样本量,m )增大,相应样本佑计量的抽样误
差会减小; 反之,样本中所包含的样本单位数量( 样本量,m ) 减少,相应样本估计量的抽样误
差会增大。在实际应用中 ,样本量的确定主要应考虑以下几方面因素。

  1. 调查的精度。调查的精度是指用样本数据对总体进行估计时可以接受的误差水平。要

求的调查精度越高( 误差水平越小 ) 所需要的样本量就越大。

  1. 总体的离散程度。在其他条件相同的情况下 ,总体方差越大,所需要的样本量也越大。

' 228 经济基础知识 (中级)

3.总体的规模。对于大规模的总体,总体规模对样本量的需求几乎没有影响。但是对
小规模的总体,总体规模越大,为保证相同估计精度,样本量也要随之增大( 但不是同比例
的)。

  1. 无回答情况。无回答减少了有效样本量。在无回答率较高的调查项目中,样本量要大

一些,以减少无回答带来的影响。

  1. 经费的制约。调查经费是影响样本量的一个十分重要的因素。事实上,样本量是调查

经费与调查精度之间的某种折中和平衡。

此外,调查的限定时间 ,实施调查的人力资源也是影响样本量的客观因素。

不考虑费用限制,无回答情况及其他影响因素时 ,简单随机抽样的样本量计算公式为:

其中, N 为总体规模, 当总体规模很大(大于 10000 )时,总体规模N对样本量” 的
影响较小,样本量 接近于 m。us 为标准正态分布的双侧 a 分位数,在置信度(1-a )为
95% 时 us 值为1.96。d 为绝对允许误差,用于表示一定的置信度(1-a )下样本估计值 6
与总体参数 0 之间的误差不超过某一给定的最大可能范围户(|6 -6|和4)=1-a ,多
许误差越小,表明人们就越相信抽样结果接近于“真实*。$S 为总体方差,总体方差 ?未知
时,一般用样本方差 替代。在比例估计中,若己为总体比例,则总体方差$ 计算公式为
P(1-P)。

假定待估计的总体比例在 0.5 附近,总体规模(N ) 为 1000 万,当绝对允许误差分别为
0.01.0.03 .0.05 时,简单随机抽样所需要的样本量分别为 9604、1068、385。随着样本量的增
大,增加同等样本量所增加的精度幅度呈下降趋势。


零基础复习卡(两版教材核验)

来源核验:主教材《2026经济基础知识中级原书有色差(371)》PDF 第232-239页;《经济基础知识(中级)-292》PDF 第186-191页(书内第178-183页)。

一句话先懂

抽样调查不是“随便找几个人问”,而是用可说明的抽样程序取得样本,再用样本统计量估计总体参数。

零基础解释

  1. 四个基本名词:总体是全部研究对象,样本是被抽中的部分;总体参数是未知但固定的总体数字特征,样本统计量随抽到谁而变化。
  2. 抽样框:实际供抽样使用的全部抽样单元名单。名单漏人、重复或含不属于总体的单位,会产生抽样框误差。
  3. 概率抽样:每个单位被抽中的概率已知或可计算,因而能估计抽样误差。常见有简单随机、分层、系统、整群和多阶段抽样。
  4. 非概率抽样:被抽中概率未知,如判断、方便、自愿、配额、滚雪球抽样,速度快但总体推断能力弱。
  5. 误差:抽样误差来自只调查部分单位;非抽样误差包括抽样框、无回答、计量等误差,普查也会有非抽样误差。
  6. 好估计量:无偏性看长期平均是否等于真值;有效性看同为无偏时谁方差更小;一致性看样本量增大后是否趋近真值。

必背清单

  • 简单随机:每个单位等概率,分有放回和不放回。
  • 分层抽样:“层内相似、层间差异”,每层都抽,适合总体差异明显且有分层信息。
  • 系统抽样:先随机起点,再按固定间隔抽取;总体名单不能有与间隔重合的周期性。
  • 整群抽样:抽中群后调查群内全部单位;“群内尽量杂、群间尽量像”。
  • 多阶段抽样:分阶段逐级抽,例如省-市-县-家庭。
  • 样本量通常随精度要求提高、总体离散程度增大、预计无回答率上升而增大;对很大总体,总体规模继续增大影响很小。

易混点

  • 分层和整群正相反:分层每层抽一部分;整群抽若干群并调查群内全部单位。
  • 抽样误差不是调查错误,是概率抽样只观察部分总体产生的随机差异。
  • 普查没有抽样误差,但有非抽样误差。
  • 样本统计量是随机变量,总体参数是未知常数。

记忆口诀

  • “层内同、层间异;群内杂、群间似”。
  • 估计量三性:“均值对真叫无偏,方差更小叫有效,样本越大越靠近叫一致”。

自测题

  1. 判断:总体均值会随本次抽到的样本不同而变化。

答案:错。 总体参数是未知常数,变化的是样本统计量。

  1. 单选:先把学生按年级分组,再从每个年级随机抽人,属于( )。A整群 B分层 C系统 D判断

答案:B。 每一层都抽取部分单位。

  1. 单选:随机抽取若干班级,调查被抽班级的全部学生,属于( )。A整群 B分层 C配额 D方便

答案:A。 抽中的是群,群内全部调查。

  1. 判断:普查不会产生任何调查误差。

答案:错。 普查没有抽样误差,但仍可能有无回答、计量等非抽样误差。

  1. 单选:两个无偏估计量中,方差较小者具有更好的( )。A一致性 B有效性 C代表性 D完整性

答案:B。 有效性用估计量方差比较。

  1. 多选:其他条件不变,会使所需样本量增加的有( )。A允许误差缩小 B总体离散程度增大 C预计无回答率上升 D精度要求降低

答案:ABC。 精度要求降低通常可减少样本量。

6刷题(章节配套练习,含校订与教学改编)

先做后看答案。单选点一下就判,多选选完点「核对答案」。错题自动进错题本,二轮会回来重做。

1. 单项选择题
某市旅游管理部门要调查了解2025年本市常住居民出境旅游总消费金 额,随机抽取3000位常住居民进行调查,该抽样调查的样本统计量为()。
A. 随机抽取3000位常住居民出境旅游总消费金额B. 所有常住居民出境旅游总消费金额C. 被调查的3000位常住居民D. 被调查的每一位常住居民出境旅游消费金额
答案 A A由样本内3000人的消费额计算,属于样本统计量;B是总体参数,C是样本集合,D是单个观测值。若用样本估计全市消费总额,还须结合总体人数和抽样权重,不能直接用3000人的合计替代全市总额。
2. 单项选择题
某公司从所有在职员工中随机抽取200人,通过对这200人的调查估计 所有在职员工的平均薪酬满意度,该抽样调查的总体是()。
A. 该公司所有在职员工B. 随机抽取的这200名员工C. 该公司所有在职员工的平均薪酬满意度D. 随机抽取的这200名员工的平均薪酬满意度
答案 A 总体即调查对象的全体,可参考上题解答。
3. 单项选择题
在研究某城市居民的家庭消费结构时,从全部50万户家庭中随机抽取 3000户进行入户调查,这项抽样调查中的样本是()。
A. 抽取出来的3000户家庭B. 50万户家庭C. 每一户家庭D. 抽取出来的每一户家庭
答案 A 本题考查抽样调查的基本概念。样本是总体的一部分,由从总体中按一定原则或 程序抽出的部分个体所组成。
4. 单项选择题
国家统计局通过对住户的抽样调查估计我国常住居民的平均收入和消 费结构,该调查中的样本是( )。
A. 我国境内所有常住住户B. 被抽中调查的所有住户C. 我国境内每一个住户的收支数据D. 采集到的住户收支数据
答案 B 样本由总体中按规定程序抽中的部分个体构成。本调查样本是被抽中调查的所有住户,选B。
5. 单项选择题
( )是供抽样所用的所有抽样单元的名单,是抽样总体的具体表现。
A. 样本B. 总体C. 抽样框D. 入样单位
答案 C 抽样框是供抽样所用的所有抽样单元的名单,是抽样总体的具体表现。
6. 单项选择题
在进行概率抽样调查时,应选择的调查单位是()。
A. 就调查标志值来说在总体中占绝大比重的单位B. 有典型意义的单位C. 主动参与调查的单位D. 依据随机原则抽取的单位
答案 D 概率抽样的特点之一是按一定的概率以随机原则抽取样本。所谓随机原则,就是 在抽取样本时排除主观上有意识地抽取调查单元的情况,使每个单元都有一定的机会被抽中。
7. 单项选择题
在街区或居民小区拦住行人进行调查的抽样方法属于()。
A. 判断抽样B. 方便抽样C. 自愿抽样D. 配额抽样
答案 B 根据抽取样本的方法不同,抽样分为概率抽样和非概率抽样。非概率抽样包括:判 断抽样、方便抽样、自愿抽样、配额抽样。其中,方便抽样是指在抽取样本时,依据方便原则,以 达到最大限度降低调查成本的目的,如“拦截式”调查。
8. 单项选择题
在抽取样本时,调查人员依据调查目的和对调查对象的了解,人为确定 样本单元,这种方法称为( )。
A. 判断抽样B. 方便抽样C. 自愿抽样D. 配额抽样
答案 A 本题考查非概率抽样的方法。判断抽样是指调查者依据调查目的和对调查对象的 了解,人为确定样本单元。
9. 单项选择题
下列抽样方法中,属于非概率抽样的是()。
A. 分层抽样B. 整群抽样C. 自愿抽样D. 等距抽样
答案 C 非概率抽样包括判断抽样、方便抽样、自愿抽样和配额抽样,故选C。
10. 单项选择题
下列抽样方法中,属于概率抽样的是()。
A. 方便抽样B. 系统抽样C. 判断抽样D. 配额抽样
答案 B 概率抽样的抽样方法包括简单随机抽样、分层抽样、系统抽样、整群抽样、多阶段 抽样等。
11. 单项选择题
在某企业网站上发布调查问卷,开展该企业员工满意度调查,采用有奖 答卷的形式吸引该企业员工接受调查。这种抽样方法是()。
A. 配额抽样B. 分层抽样C. 自愿抽样D. 判断抽样
答案 C 自愿样本是指不是经过抽取而是由自愿接受调查的单元所组成的样本。比较典型 的是网上调查。
12. 单项选择题
某公司有100名男员工和100名女员工,为了解员工对改革的态度,计划调查20人并限定男女各10人,调查员按就近方便原则自行选择各性别受访者。该方法称为()。
A. 分层抽样B. 配额抽样C. 系统抽样D. 整群抽样
答案 B 配额抽样是指将总体中的各单元按一定标准划分为若干类型,将样本数额分配到 各类型中,从各类型中抽取样本的方法则没有严格限制,一般采用方便抽样的方法抽取样本 单元。

校勘说明:为明确抽样程序、统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

13. 单项选择题
在抽样调查一般步骤中,需要回答“要做什么样的调查研究”,是在 ()阶段。
A. 确定调查问题B. 调查方案设计C. 实施调查过程D. 撰写调查报告
答案 A 本题考查抽样调查的步骤。第一步确定调查问题是回答“要做什么样的调查研究” 和“为什么要做这项调查研究”。
14. 多项选择题
以下属于概率抽样特点的有()。
A. 按一定的概率以随机原则抽取样本B. 抽取样本并不是依据随机原则C. 总体中每个单元被抽中的概率是未知的D. 总体中每个单元被抽中的概率是可以计算出来的E. 当采用样本对总体参数进行估计时,要考虑到每个样本单元被抽中的概率
答案 ADE 概率抽样的特点之一是按一定概率以随机原则抽取样本,选项B错误。另一个 特点是,总体中每个单元被抽中的概率是已知的或者可以计算出来,选项C错误。
15. 多项选择题
关于概率抽样的说法,正确的有()。
A. 每个单元都有一定的机会被抽中B. 总体中每个单元被抽中的概率是已知的或可计算的C. 每个总体单元被抽入样本的概率都相等D. 调查人员可以根据方便原则抽取样本E. 调查人员可以根据主观判断抽取样本
答案 AB 概率抽样具有以下特点:①按一定的概率以随机原则抽取样本。所谓随机原则, 就是在抽取样本时排除主观上有意识地抽取调查单元的情况,使每个单元都有一定的机会被 抽中。②总体中每个单元被抽中的概率是已知的,或者是可以计算出来的。③当采用样本对 总体参数进行估计时,要考虑到每个样本单元被抽中的概率。
16. 多项选择题
下列抽样方法中,属于概率抽样的有()。
A. 判断抽样B. 配额抽样C. 分层抽样D. 整群抽样E. 系统抽样
答案 CDE 本题考查概率抽样的方法类型。选项A、B属于非概率抽样的方法。
17. 多项选择题
下列统计活动中,一般在抽样调查方案设计阶段完成的有()。
A. 数据预处理B. 确定抽样方法C. 将调研问题细化为问卷中的具体问题D. 数据录入E. 撰写报告
答案 BC 调查方案设计包括抽样方案和问卷设计,B及修订后的C属于该阶段;A、D为数据处理,E为成果报告。

校勘说明:为明确抽样程序、统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

18. 单项选择题
下列误差来源中,会导致抽样误差的是()。
A. 调查人员作弊B. 受访者拒绝接受调查C. 抽样框遗漏部分总体单元D. 抽样的随机性
答案 D 本题考查抽样误差。抽样误差是由抽样的随机性造成的,是用样本统计量估计总 体参数时出现的误差。
19. 单项选择题
下列误差中,属于抽样误差的是()。
A. 抽样随机性造成的用样本统计量估计总体参数时出现的误差B. 抽样框误差C. 无回答误差D. 计量误差
答案 A 抽样误差是由抽样的随机性造成的,是用样本统计量估计总体参数时出现的误 差。
20. 单项选择题
在调查时,被调查者恰巧不在家,这种调查减少了有效样本量,会造成估 计量方差增大,这种情况属于()。
A. 抽样框误差B. 计量误差C. 系统误差D. 无回答误差
答案 D 本题考查抽样调查中的误差。被调查者恰巧不在家,属于无回答误差。
21. 单项选择题
以下情况中,不属于计量误差的是()。
A. 调查员在调查中有意无意地诱导被调查者B. 被调查者不愿意告诉实情而拒绝回答C. 调查人员有意作弊D. 受访者提供虚假信息
答案 B 选项B属于无回答误差。
22. 单项选择题
由于受访者记忆模糊,导致调查数据与其真值之间不一致,这种误差属 于()。
A. 抽样误差B. 抽样框误差C. 无回答误差D. 计量误差
答案 D 本题考查计量误差。抽样误差是由抽样的随机性造成的,是用样本统计量估计总 体参数时出现的误差。选项B、C、D三项均属于非抽样误差,是指由其他原因引起的样本统 计量与总体真值之间的差异。其中,计量误差是由于调查所获得的数据与其真值之间不一致 造成的误差,包括调查人员有意作弊、记录答案错误、受访者提供虚假数字及受访者记忆模 糊等。
23. 多项选择题
下列关于抽样误差的表述,正确的有()。
A. 抽样误差无法避免,但可计算B. 抽样误差与总体分布有关,总体方差越大,抽样误差越大C. 其他条件相同,样本量越大,抽样误差越小D. 抽样误差与抽样方式和估计量的选择也有关E. 分层抽样的估计量方差一般大于简单随机抽样
答案 ABCD 分层抽样的估计量方差一般小于简单随机抽样,即分层抽样的误差小于简单随 机抽样,选项E错误。
24. 多项选择题
非抽样误差产生的原因主要有()。
A. 抽样框误差B. 参数误差C. 无回答误差D. 系统误差E. 计量误差
答案 ACE 非抽样误差产生的原因包括:①抽样框误差;②无回答误差;③计量误差。
25. 多项选择题
在城乡住户收支调查中,非抽样误差的可能来源有()。
A. 抽样框遗漏掉部分城乡住户B. 部分高收入住户拒绝接受调查C. 调查人员有意作弊D. 被调查住户提供虚假数据E. 抽样的随机性
答案 ABCD 由抽样的随机性造成的是抽样误差,选项E不符合题意。选项A属于抽样框 误差,选项B属于无回答误差,选项C、D属于计量误差。
26. 多项选择题
下列误差来源中,可能导致计量误差的有()。
A. 抽样框不完善B. 调查中的提问错误C. 调查中记录答案错误D. 被调查者记忆不清E. 被调查者提供虚假数据
答案 BCDE 计量误差是指由于调查所获得的数据与其真值之间不一致造成的误差。例如, 调查员在调查中有意无意地诱导被调查者,调查中的提问错误或记录答案错误,调查人员有意 作弊,由于问卷的原因导致受访者对调查问题的理解上有偏误,受访者记忆不清,受访者提供 虚假数据等。
27. 多项选择题
下列关于简单随机抽样的表述,错误的有()。
A. 有放回抽样具有更低的抽样误差B. 是最基本的随机抽样方法C. 总体的每个单位入样概率不同D. 抽样框没有更多可利用的辅助信息E. 适用个体之间差异较大的调查
答案 ACE 不放回简单随机抽样,每个单位最多只能被抽中一次,所以比有放回随机抽样 具有更低的抽样误差,选项A符合题意。简单随机抽样是最基本的随机抽样方法,操作简单, 且每个单位的入样率相同,选项C符合题意。简单随机抽样适用于个体间差异不是很大的情 况,选项E符合题意。
28. 单项选择题
某研究机构通过抽样调查了解某市餐饮行业的营业收入情况,将该市所 有餐饮企业按照经营规模分为10层,在每个层内随机抽取样本企业,对所有样本企业进行调 查。该调查采用的抽样方法是()。
A. 简单随机抽样B. 分层抽样C. 整群抽样D. 系统抽样
答案 B 分层抽样是指先按照某种规则把总体分为不同的层,然后在不同的层内独立、随机 地抽取样本。
29. 单项选择题
某单位有1500名职工,其中管理人员300人,其余为普通员工。按各层人数比例进行分层随机抽样,抽取200人,则管理人员和普通员工应各抽取()。
A. 50人,150人B. 40人,160人C. 100人,100人D. 60人,140人
答案 B 按比例分配:管理人员200×300÷1500=40人;普通员工200×1200÷1500=160人,选B。分层抽样也可采取其他分配方式,本题特指比例分配。

校勘说明:为明确抽样程序、统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

30. 单项选择题
在分层抽样中,层的划分原则是()。
A. 层内单位差异小,层间单位差异大B. 层内单位差异大,层间单位差异小C. 层内单位差异小,层间单位差异小D. 层内单位差异大,层间单位差异大
答案 A 分层抽样的应用条件是:抽样框中有足够的辅助信息,能够将总体单位按某种标准 划分到各层之中,实现在同一层内各单位之间的差异尽可能地小,不同层之间各单位的差异尽 可能地大。
31. 单项选择题
某工厂连续生产产品,随机确定首个抽检时刻后,每隔1小时抽取一个产品检验。这种抽样方法是()。
A. 简单随机抽样B. 系统抽样C. 分层抽样D. 整群抽样
答案 B 系统抽样指先将总体中的所有单元按一定顺序排列,在规定范围内随机抽取一个初 始单元,然后按事先规定的规则抽取其他样本单元。最简单的系统抽样是等距抽样。题目描 述的情况为等距抽样。

校勘说明:为明确抽样程序、统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

32. 单项选择题
系统抽样的缺点是()。
A. 操作复杂B. 对抽样框要求较高C. 方差估计比较复杂D. 需要增大样本量
答案 C 系统抽样的缺点是方差估计比较复杂,这就给计算抽样误差带来一定困难。
33. 多项选择题
以下关于概率抽样方法的说法,正确的有()
A. 简单随机抽样中每个单位的入样概率相同B. 分层抽样适用于层内差异小、层间差异大的情形C. 整群抽样调查抽中群的全部基本单位D. 系统抽样对抽样框的要求比较复杂E. 大范围调查中缺乏完整最终单位抽样框时,采用多阶段抽样通常更可行
答案 ABCE 本题考查几种基本概率抽样方法的特点,比较综合。系统抽样的优点之一是对 抽样框的要求比较简单,选项D错误。

校勘说明:为明确抽样程序、统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

34. 单项选择题
在调查某城市小学教师亚健康状况时,从该城市的200所小学中随机抽 取40所,每个被抽取小学中的所有教师都参与调查,这样的抽样方法属于()。
A. 简单随机抽样B. 整群抽样C. 分层抽样D. 等距抽样
答案 B 整群抽样是将总体中所有的基本单位按照一定规则划分为互不重叠的群,抽样时直 接抽取群,对抽中的群调查其全部的基本单位,对没有抽中的群则不进行调查。题目中,每所 小学就是一个群。
35. 单项选择题
组间差异较小,组内差异较大,适用于()方法。
A. 简单随机抽样B. 整群抽样C. 系统抽样D. 分层抽样
答案 B 整群抽样适用情况是,如果群内各单位之间存在较大差异,群与群的结果相似,整群 抽样会降低估计误差。
36. 单项选择题
某企业部门内员工对工作环境的评价较相似、部门间差异较大,员工编号不存在与调查指标一致的周期。在最终员工样本量相同且其他设计合理的情况下,通常抽样误差较大的是()。
A. 以企业部门为群的整群抽样B. 按员工岗位分层的分层抽样C. 简单随机抽样D. 按照员工编号等距抽样
答案 A 同部门员工较同质、部门间差异较大时,按部门整群抽样的信息重复较多,通常比合理分层或简单随机抽样误差大,故选A。这一判断依赖给定的群内相似性,不能适用于所有总体结构。

校勘说明:为明确抽样程序、统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

37. 单项选择题
整群抽样的主要缺点是()。
A. 调查实施效率低B. 抽样框编制复杂C. 群内样本单位可能同质性高,从而导致抽样误差比较大D. 调查成本高
答案 C 整群抽样的主要缺点是:由于抽取的样本单位比较集中,群内各单位之间存在相似 性,差异比较小,而群与群之间的差别往往比较大,使得整群抽样的抽样误差比较大。
38. 单项选择题
某市为调查居民对市政建设的满意度,先从该市所有居委会中随机抽取 20个居委会,再从每个被抽中的居委会中随机抽取30个居民家庭进行入户调查。该项调查 采用的抽样方法是()。
A. 分层抽样B. 整群抽样C. 系统抽样D. 多阶段抽样
答案 D 多阶段抽样是对经过两个及两个以上抽样阶段抽样方法的统称。
39. 单项选择题
某省先随机抽取n个县,再从每个样本县随机抽取m个村,最后从每个样本村随机抽取k户农户。该调查采用()。
A. 多阶段抽样B. 分层抽样C. 系统抽样D. 整群抽样
答案 A 县、村、农户依次构成三个抽样阶段,属于多阶段抽样,选A。

校勘说明:为明确统计定义、经验标准或教学条件所作的校订后教学题设,不冒充原题原文。

40. 单项选择题
某全国性的居民入户抽样调查中,首先把所有区县按照东、中、西部分 层,然后在各层内分别按照简单随机原则抽选区县,再在选中的区县中抽选居委会(村委会), 最后在选中的居委会(村委会)中按照简单随机原则抽选居民户。该抽样调查的多阶段抽样 设计的阶段数量是( )。
A. 1B. 2C. 3D. 4
答案 C 先按东、中、西部分层是第一阶段抽样前的分层设计,不增加抽样阶段。实际随机抽选依次为区县、居委会或村委会、居民户,共3个阶段,选C。
41. 多项选择题
为调查某城市小学教师的身体健康状况,分别从该城市所有区县中随机 抽取8个区县,然后在被抽中的每个区县随机抽取5所小学,对被抽中小学的所有在职教师发 放问卷进行调查。该调查中,用到的抽样方法有()。
A. 分层抽样B. 配额抽样C. 整群抽样D. 多阶段抽样E. 系统抽样
答案 CD 先抽区县,再抽小学,属于多阶段抽样;对入选小学全部教师调查体现整群抽样。题干没有将总体分层后从每一层分别抽样,因此不含分层抽样,选CD。
42. 多项选择题
某省将调查小区分为城镇和农村两层,各层独立随机抽取100个小区;再在每个样本小区内将住户排序,随机确定起点后按固定间隔抽取20户。该调查采用的抽样方法有()。
A. 判断抽样B. 多阶段抽样C. 系统抽样D. 分层抽样E. 整群抽样
答案 BCD 分层抽样是指先按照某种规则把总体分为不同的层,然后在不同的层内独立随 机地抽取样本。系统抽样是指先将总体中的所有单元按一定顺序排列,在规定范围内随机抽 取一个初始单元,然后按事先规定的规则抽取其他样本单元,最简单的系统抽样是等距抽样。 在大规模抽样调查中,很难一次抽取到最终样本单位,往往需要经过两个或两个以上阶段才能 抽到最终样本单位,这就是多阶段抽样方法。

校勘说明:为明确抽样程序、统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

43. 多项选择题
某医药企业为评估新药疗效,从全球随机抽取15个国家,每个国家随机 抽取10家医院,每家医院随机抽取10名轻度患者和10名重度患者,每名患者记录用药后的 疗效数据。该研究使用的抽样方法有()。
A. 多阶段抽样B. 配额抽样C. 滚雪球抽样D. 分层抽样E. 判断抽样
答案 AD 抽样依次在国家、医院和患者三个层级进行,属于多阶段抽样;患者按轻度、重度分层,各层随机抽取10人,属于分层抽样,故选AD。全程采用随机程序,不属于配额、判断或滚雪球抽样。
44. 单项选择题
对于不放回简单随机抽样,所有可能的样本均值取值的平均值总是等于 总体均值,这就是样本估计量的( )。
A. 无偏性B. 有效性C. 一致性D. 渐进性
答案 A 对于不放回简单随机抽样,所有可能的样本均值取值的平均值总是等于总体均值, 这就是样本均值估计量的无偏性。
45. 单项选择题
在不放回简单随机抽样中,估计量的无偏性是指()。
A. 所有可能的样本均值取值的平均值等于总体均值B. 所有可能的样本估计值都等于总体参数的真值C. 随着样本量的增大,样本估计值趋向总体参数的真值D. 所有可能的样本取值集中在总体参数真值附近
答案 A 对于不放回简单随机抽样,所有可能的样本均值取值的平均值总是等于总体均值, 这就是样本均值估计量的无偏性。
46. 单项选择题
在抽样估计中,用方差大小比较同一参数的无偏估计量优劣,所考察的性质是()。
A. 一致性B. 无偏性C. 有效性D. 确定性
答案 C 同一参数的无偏估计量中,方差越小,有效性越高;方差越大,有效性越低。因此考察的是有效性,选C。

校勘说明:为明确抽样程序、统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

47. 单项选择题
假设对某总体参数θ有两个无偏估计量θ̂₁和θ̂₂,θ̂₁比θ̂₂更有效,则这两个估计量的关系是( )。
A. V(θ̂₁)>V(θ̂₂)B. V(θ̂₁)<V(θ̂₂)C. θ̂₁>θ̂₂D. θ̂₁<θ̂₂
答案 B 本题考查估计量的有效性。θ̂₁比θ̂₂更有效,必然有V(θ̂₁)<V(θ̂₂),即θ̂₁的方差小于θ̂₂的方差,所以选B。

校勘说明:按《经济基础知识(中级)章节同步习题集-304.pdf》原PDF第201页题面、第205页答案复核修正;保留原题答案。

48. 单项选择题
假设某总体参数θ有两个无偏估计量θ̂₁和θ̂₂,已知V(θ̂₁)>V(θ̂₂),则这两个估计量的关系是( )。
A. θ̂₁比θ̂₂更有效B. θ̂₂比θ̂₁更有效C. θ̂₁比θ̂₂更一致D. θ̂₂比θ̂₁更一致
答案 B 方差是度量分布密集或离散状况的重要指标,估计量方差常用于描述抽样误差。在无偏估计量之间,方差越小,有效性越高。本题V(θ̂₁)>V(θ̂₂),所以θ̂₂比θ̂₁更有效,选B。

校勘说明:按《经济基础知识(中级)章节同步习题集-304.pdf》原PDF第201页题面、第205页答案复核修正;保留原题答案。

49. 多项选择题
抽样统计中,估计量的性质包括()。
A. 一致性B. 相关性C. 无偏性D. 有效性E. 密集性
答案 ACD 估计量的性质包括:无偏性、一致性、有效性。
50. 多项选择题
下列影响因素中,属于抽样误差来源的有()。
A. 总体单位值之间的差异大小B. 样本量大小C. 访问人员的选择D. 抽样方式的选择E. 估计量的选择
答案 ABDE 抽样误差大小与以下因素有关:①抽样误差与总体分布有关,总体单位值之间 差异越大,即总体方差越大,抽样误差越大。②抽样误差与样本量n有关,其他条件相同,样本 量越大,抽样误差越小。③抽样误差与抽样方式和估计量的选择也有关。例如,分层抽样的 估计量方差一般小于简单随机抽样。④利用有效辅助信息的估计量也可以有效地减小抽样 误差。
51. 单项选择题
关于样本量的影响因素,下列说法正确的是()。
A. 其他条件相同,调查精度要求越高,所需样本量越小B. 其他条件相同,总体离散程度越大,所需样本量也越大C. 其他条件相同,所需样本量必定随总体规模成正比例增加D. 其他条件相同,无回答率越高,所需样本量越小
答案 B 精度更高、总体差异更大、无回答率更高通常要求更多初始样本。总体规模的影响有有限总体校正,且大总体时趋弱,并非成比例增长;修订后只有B正确。

校勘说明:为明确抽样程序、统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

52. 多项选择题
确定抽样调查样本量时,应考虑的因素包括()。
A. 调查的精度要求B. 总体的离散程度C. 所研究变量的总体分布特征D. 经费的制约E. 调查覆盖范围及需分别满足精度的分析子群
答案 ABCDE 样本量取决于精度、总体差异、预算等,也需结合研究变量的分布及需单独发布可靠结果的分析子群。分布特征与离散程度可能重叠,但重叠不使选项错误;调查范围扩大不意味着样本量必按总体人数同比例增长。选ABCDE。

校勘说明:为明确抽样程序、统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

53. 多项选择题
抽样调查中,确定样本量应考虑的因素主要有()。
A. 调查的限定时间B. 总体的离散程度C. 无回答情况D. 调查经费E. 需要同时满足精度要求的调查指标及其数量
答案 ABCDE 限定时间、总体差异、无回答和经费会影响样本量。多指标调查还要确定各关键指标及同时满足的精度约束;增加指标不必然增加样本量,但新增更严格约束时可能需要增样,因此E也是应考虑的因素,选ABCDE。

校勘说明:为明确抽样程序、统计定义或适用条件所作的校订后教学题设,不冒充原题原文。

7本章打卡

做完一项勾一项,当天页会自动更新整体进度。

学完这章就是往前走了一步。记不住的,明天再来看必背,不用今天全记住。

↑ 回到今日顶部

1重点一览

先花 2 分钟看清这章有几个考点、哪几个是必考,心里有数再读书。

6页教材0个 ★★★0个 ★★1个 ★26道章节题约 48 分钟教材印刷页 229-234
考点 回归分析★

2教材标色 + 三色笔记

左边是教材原文,彩色句子就是《考点速记》收了的内容,颜色是星级。右边是速记的考点表,和左边的小节对齐。读一节,看一眼右边的表,再往下走。

一、回归模型

教材 P229

(一)回归分析的概念

回归分析是指根据相关关系的具体形态,选择一个合适的数学模型,来近似地表达变量间的依赖关系。

回归分析和相关分析有着密切的联系,它们不仅具有共同的研究对象,而且在具体应用时,常常必须互相补充。相关分析需要依靠回归分析来表明现象数量相关的具体形式,而回归分析则需要依靠相关分析来表明现象数量变化的相关程度。只有当变量之间存在着高度相关时,进行回归分析寻求其相关的具体形式才有意义。

应当指出,相关分析与回归分析之间在研究目的和方法上是有明显区别的。相关分析研究变量之间相关的方向和相关的程度,但是相关分析不能指出变量间相互关系的具体形式,也无法从一个变量的变化来推测另一个变量的变化情况。回归分析则是研究变量之间相互关系的具体形式,它对具有相关关系的变量之间的数量联系进行测定,确定一个相关的数学方程式,根据这个数学方程式可以从已知量来推测未知量,从而为估算和预测提供了一个重要的方法。

进行回归分析时,首先需要确定因变量和自变量。在回归分析中,被预测或被解释的变量称为因变量,一般用 Y 表示;用来预测或解释因变量的变量称为自变量,一般用 X 表示。例如,在研究边际消费倾向时,目的是预测一定人均收入条件下的人均消费金额。因此,人均消费金额是被预测的变量,称为因变量,而用来预测人均消费金额的人均收入就是自变量。

(二)一元线性回归模型

根据自变量的多少,回归模型可以分为一元回归模型和多元回归模型。根据是否是线性,回归模型可以分为线性回归模型和非线性回归模型。一元线性回归模型是描述两个变量之间相关关系的最简单的回归模型。回归模型可以用描述因变量 Y 如何依赖自变量 X 和误差项 ε 的方程来表示。只涉及一个自变量的一元线性回归模型可以表示为:

Y = β0 + β1X + ε

式中,β0 和 β1 为模型的参数。

模型中,因变量 Y 是自变量 X 的线性函数(β0 + β1X)加上误差项 ε。β0 + β1X 反映了由于自变量 X 的变化而引起的因变量 Y 的线性变化。误差项 ε 是个随机变量,表示除 X 和 Y 的线性关系之外的随机因素对 Y 的影响,是不能由 X 和 Y 的线性关系所解释的 Y 的变异性。

描述因变量 Y 的期望 E(Y) 如何依赖自变量 X 的方程称为回归方程。一元线性回归方程的形式为:

E(Y) = β0 + β1X

一元线性回归方程的图示是一条直线,β0 是回归直线的截距,β1 是回归直线的斜率,表示 X 每变动一个单位时,E(Y) 的变动量。

二、最小二乘法

教材 P230

现实中,模型的参数 β0 和 β1 都是未知的,必须利用样本数据去估计。假设可得到 X 和 Y 的 n 组观测值,即 (xi, yi),i = 1, 2, …, n,根据样本统计量 β̂0 和 β̂1 估计模型中的参数 β0 和 β1 之后,就得到了估计的回归方程:

ŷi = β̂0 + β̂1 xi(i = 1, 2, …, n)

式中,β̂0 表示估计的回归直线在 Y 轴上的截距;β̂1 为估计的回归直线的斜率,它表示自变量 X 每变动一个单位时,因变量 Y 的平均变动量。

上式中的 β̂0 和 β̂1 确定了回归直线的位置,β̂0 和 β̂1 一旦确定,这条直线也就唯一确定了。但对于给定的 n 组观测值,可用于描述数据的直线有很多条,究竟用哪条直线来代表两个变量之间的关系,需要有一个明确的原则。我们自然会想到距离各观测点最近的一条直线,即实际观测点和直线间的距离最小。根据这一思想对回归模型进行估计的方法称为最小二乘法。最小二乘法就是使因变量的观测值 yi 与估计值 ŷi 之间的离差(又称残差)平方和最小来估计参数 β0 和 β1 的方法,如图 26-1 所示。

(图 26-1 最小二乘法示意图:散点图上画一条「估计的回归线」,各观测点到直线的竖直距离就是残差,见教材扫描件)

根据最小二乘法,使得 Σ(yi − ŷi)² = Σ(yi − β̂0 − β̂1 xi)² 最小。

设 Q = Σ(yi − ŷi)²,在给定了样本数据后,Q 是 β̂0 和 β̂1 的函数,且最小值总是存在。根据微积分的极值定理,对 Q 求相应于 β̂0 和 β̂1 的偏导数,并令其等于 0,即可求出 β̂0 和 β̂1 的估计量:

β̂1 = Σ(xi − x̄)(yi − ȳ) ÷ Σ(xi − x̄)²

β̂0 = Σyi ÷ n − β̂1 × Σxi ÷ n = ȳ − β̂1 x̄

教材 P231

根据表 26-1 中的数据,拟合城镇居民人均可支配收入和人均消费支出的直线回归方程。根据上面的公式可得:

β̂1 = Σ(xi − x̄)(yi − ȳ) ÷ Σ(xi − x̄)² = 0.546

β̂0 = ȳ − β̂1 x̄ = 4276.984

估计的城镇居民人均可支配收入和人均消费支出的一元线性直线回归方程为:

ŷ = 4276.984 + 0.546X

估计的回归系数显示,城镇居民家庭人均可支配收入每增加 1 元,城镇居民人均消费支出将增加 0.546 元。

表 26-1 预测值和预测残差

年份城镇居民人均可支配收入 xi(元)城镇居民人均消费支出 yi(元)城镇居民人均消费预测值 ŷi(元)预测值与观测值之间的残差 yi − ŷi
2012241271710717440.5-333.5
2013264671848818717.2-229.2
2014288441996820014.1-46.1
2015311952139221296.795.3
2016336162307922617.6461.4
2017363962444524134.4310.6
2018392512611225692.0420.0
2019423592806327387.7675.3
2020438342700728192.5-1185.5
2021474123030730144.6162.4
2022492833039131165.4-774.4
2023518213299432550.1443.9

三、模型的检验和预测

(一)回归模型的拟合效果分析

一般情况下,在使用估计的回归方程之前,需要对模型进行检验:①结合经济理论和经验分析回归系数的经济含义是否合理;②分析估计的模型对数据的拟合效果如何;③对模型进

教材 P232

行假设检验。

1. 决定系数 R²。决定系数 R²,也称为拟合优度或判定系数,可以测度回归模型对样本数据的拟合程度,其计算公式如下:

R² = Σ(ŷi − ȳ)² ÷ Σ(yi − ȳ)² = 1 − Σ(yi − ŷi)² ÷ Σ(yi − ȳ)²

决定系数是回归模型所能解释的因变量变化占因变量总变化的比例,取值范围在 0 到 1 之间。决定系数越高,模型的拟合效果就越好,即模型解释因变量的能力越强。如果所有观测点都落在回归直线上,R² = 1,说明回归直线可以解释因变量的所有变化。R² = 0,说明回归直线无法解释因变量的变化,因变量的变化与自变量无关。现实应用中 R² 大多落在 0 和 1 之间,R² 越接近于 1,回归模型的拟合效果越好;R² 越接近于 0,回归模型的拟合效果越差。

根据上面估计的回归方程,利用表 26-1 的计算结果,计算决定系数:

R² = 1 − Σ(yi − ŷi)² ÷ Σ(yi − ȳ)² ≈ 0.988

R² 为 0.988,说明回归模型的拟合效果很好,即城镇居民人均可支配收入可以很好地解释城镇居民人均消费支出的变化,从图 26-2 中可以看出模型预测值和观测值非常接近。

(图 26-2 城镇居民人均消费性支出及其预测值:横轴为城镇居民人均可支配收入(元),纵轴为人均消费性支出(元),实际值与预测值两条线几乎重合,见教材扫描件)

2. 回归系数的显著性检验。在大样本假定的条件下,回归系数的最小二乘估计量 β̂0 和 β̂1 渐进服从正态分布,可以用 t 检验方法验证自变量 X 对因变量 Y 是否有显著影响。t 检验的原理是反证法,在原假设 β1 = 0(自变量 X 对因变量 Y 没有影响)正确的假定下,基于 β̂1 的抽样分布计算一次抽样情况下得到该样本或更极端样本的概率(P 值),如果 P < 0.05,则可以在 0.05 的显著性水平下拒绝原假设,认为自变量 X 对因变量 Y 有显著影响,即 β1 ≠ 0。常见的统计分析软件拟合回归模型时都会给出 t 检验的 P 值,可直接比较 P 值和显著性水平(经常取 0.05),来判断回归模型的自变量对因变量是否有显著影响。

根据表 26-1 中的城镇居民人均可支配收入和人均消费性支出数据,Excel 软件的回归

教材 P233

函数给出线性回归模型拟合结果见表 26-2,“系数”列给出 β̂0 和 β̂1 的最小二乘估计值分别为 4276.984 和 0.546,“P 值”列给出自变量城镇居民人均可支配收入的 t 检验 P 值 = 5.728 × 10⁻¹¹,因此可以在 0.05 的显著性水平下拒绝 β1 = 0 的原假设,认为城镇居民人均可支配收入对城镇居民人均消费性支出有显著影响。

表 26-2 线性回归模型拟合结果

项目系数标准误差tP 值
截距4276.984734.360215.82411.674 × 10⁻⁴
城镇居民人均可支配收入0.5460.0188828.90265.728 × 10⁻¹¹

(二)模型预测

回归分析的一个重要应用就是预测,即利用估计的回归模型预估因变量数值。例如,根据上面估计的回归方程,当城镇居民家庭人均可支配收入 X = 40000 元时,人均消费性支出是多少?

将 X = 40000 代入回归方程,得:

ŷ = 4276.984 + 0.546X = 4276.984 + 0.546 × 40000 = 26116.984(元)

(三)二元回归模型案例

利用某公司的 30 位员工数据,以年薪为因变量 Y,以受教育年限(edu)和职位(position)为自变量,用 Excel 拟合二元线性回归模型,年薪回归估计结果见表 26-3。其中,年薪(元)和受教育年限(年)为定量变量;职位为定性变量,0 表示一般职员,1 表示管理者。

表 26-3 年薪回归估计结果

回归统计数值
R Square0.632538
Adjusted R Square0.605318
观测值30
项目系数标准误差tP 值
截距-18716.216600.7096-1.127430.26948
受教育年限(edu)3669.0021209.4214473.0336840.00529
职位(position)27144.478197.9765383.3111180.00265

由表 26-3 可以得到估计的二元线性回归方程:

ŷ = −18716.2 + 3669edu + 27144.47position

多元回归模型在实际应用中,随着自变量个数的增加,即使在有些自变量与因变量完全不相关的情况下,决定系数 R² 也会增大。为避免因增加自变量个数而高估拟合效果的情况,多元回归模型一般使用修正了自由度的调整后 R²(Adjusted R Square)。调整后 R² 考虑了自变量个数增加带来的影响,在数值上小于 R²。表 26-3 中二元线性回归模型的调整后 R²(Adjusted R Square)= 0.605,表示受教育年限和职位的二元回归模型对年薪的变化可解释程

教材 P234

度为 60.5%。自变量受教育年限和职位的 t 检验 P 值 0.00529 和 0.00265 都小于 0.05,表明 2 个自变量都通过了 t 检验,对年薪有显著的线性影响。在多元线性回归方程中,偏回归系数可以衡量在其他自变量保持不变的情况下,某一个自变量变化一个单位时,因变量的平均变化量。本例中,受教育年限(edu)的偏回归系数为 3669,即在相同职位上,受教育年限每增长 1 年,年薪平均增加 3669 元;管理者职位(position)的偏回归系数为 27144.47,即在相同受教育年限的条件下,管理者(position = 1)的年薪比一般职员(position = 0)的年薪平均高 27144.47 元。

已知员工甲受教育年限为 10 年,在该公司为一般职员,可利用该模型预测其年薪大约为 ŷ = −18716.2 + 3669 × 10 = 17973.8(元)。

3必背

这些是必须背下来的。先遮住右边一列,看左边考点名,自己说出内容,说不出来的做记号。

经济基础 第26章 回归分析 必背

红 ★★★ 必考

本章速记没有 ★★★ 考点。

黄 ★★ 重点

本章速记没有 ★★ 考点。

绿 ★ 中会考数字、公式、分类的点

考点必背内容
回归分析含义根据相关关系的具体形态,选一个合适的数学模型,近似表达变量间的依赖关系
回归与相关的区别相关分析看「方向和程度」,回归分析看「具体形式」并能用已知量推未知量(预测)
因变量 / 自变量被预测、被解释的叫因变量 Y;用来预测、解释的叫自变量 X
回归模型分类按自变量个数:一元 / 多元;按是否线性:线性 / 非线性;一元线性回归是最简单的回归模型
一元线性回归模型Y = β0 + β1X + ε;β0、β1 是参数,ε 是误差项(随机变量,X 与 Y 线性关系解释不了的那部分)
一元线性回归方程E(Y) = β0 + β1X;图形是一条直线,β0 = 截距,β1 = 斜率(X 每变 1 单位,E(Y) 变 β1)
最小二乘法思想让观测值 yi 与估计值 ŷi 的离差(残差)平方和最小,来估计 β0、β1
最小二乘估计公式β̂1 = Σ(xi − x̄)(yi − ȳ) ÷ Σ(xi − x̄)²;β̂0 = ȳ − β̂1 x̄
决定系数 R² 名字又叫拟合优度、判定系数,测度回归模型对样本数据的拟合程度
决定系数 R² 公式R² = Σ(ŷi − ȳ)² ÷ Σ(yi − ȳ)² = 1 − Σ(ŷi − yi)² ÷ Σ(yi − ȳ)²(能解释的变化 ÷ 总变化)
R² 取值与判断取值 0 到 1;越接近 1 拟合越好;R² = 1 所有点都在直线上;R² = 0 因变量变化与自变量无关
回归系数显著性检验用 t 检验,原理是反证法;原假设 β1 = 0(X 对 Y 没影响);P < 0.05 就拒绝原假设,认为 X 对 Y 有显著影响
调整后 R²自变量越多 R² 会虚高,多元回归用调整后 R²(Adjusted R Square),数值上小于 R²
偏回归系数其他自变量不变时,某一自变量变 1 单位,因变量的平均变化量

数字与公式清单

  • 一元线性回归模型:Y = β0 + β1X + ε(带 ε)
  • 一元线性回归方程:E(Y) = β0 + β1X(不带 ε)
  • 估计的回归方程:ŷi = β̂0 + β̂1 xi
  • 斜率估计:β̂1 = Σ(xi − x̄)(yi − ȳ) ÷ Σ(xi − x̄)²
  • 截距估计:β̂0 = ȳ − β̂1 x̄
  • 决定系数:R² = 1 − 残差平方和 ÷ 总离差平方和,取值 0 到 1
  • 显著性水平常取 0.05,P < 0.05 拒绝原假设 β1 = 0
  • 教材例题:ŷ = 4276.984 + 0.546X,收入每增 1 元消费增 0.546 元;R² = 0.988;X = 40000 时 ŷ = 26116.984 元
  • 二元例题:ŷ = −18716.2 + 3669edu + 27144.47position,调整后 R² = 0.605(可解释 60.5%)
  • 检验模型三步:①回归系数经济含义合不合理 ②拟合效果如何 ③假设检验

4总结

一页纸看完整章。二轮快刷和考前只看这里和必背。

经济基础 第26章 回归分析 一页纸总结

本章一句话

第 24 章的相关分析只告诉你「两个变量有没有关系、关系多强」,这一章回归分析往前走一步:给这个关系配一条直线 Y = β0 + β1X,用最小二乘法把直线画出来,用 R² 看直线画得准不准,用 t 检验看 X 到底管不管用,最后拿这条直线做预测。

章末总览表

考点星级一句话要点考法
考点 回归分析★含义:按相关关系形态选数学模型表达依赖关系;模型 Y = β0 + β1X + ε,方程 E(Y) = β0 + β1X,β0 截距 β1 斜率;最小二乘估计 β̂1 = Σ(xi − x̄)(yi − ȳ) ÷ Σ(xi − x̄)²,β̂0 = ȳ − β̂1 x̄;决定系数 R² 在 0 到 1 之间,越接近 1 拟合越好单选(概念辨析、β1 含义、R² 取值判断)、多选(回归与相关的区别、模型的组成)、偶有代数据算 ŷ 的简单计算

易错坑

  1. 「模型」带误差项 ε,「方程」不带 ε(方程是期望 E(Y))。题目问一元线性回归方程,答 E(Y) = β0 + β1X。
  2. β1 是斜率,说的是 X 每变 1 单位时 Y 的「平均」变动量,不是每个观测值都刚好变这么多。
  3. R² 取值 0 到 1,没有负数;越接近 1 越好。相关系数 r 才有正负,别混。
  4. 最小二乘法的「最小」指的是残差「平方和」最小,不是残差之和最小,也不是距离之和最小。
  5. 回归系数显著性用 t 检验,原假设是 β1 = 0;P 值小于 0.05 才「拒绝原假设」,说明 X 有显著影响。方向别反。

和前后章的关系

第 24 章相关分析算相关系数 r 看关系强弱,本章在它基础上给出具体方程,两章是一套:先相关后回归,相关程度高才值得做回归。第 25 章说明样本数据如何取得及抽样误差如何控制;第 27 章时间序列分析换一个角度,看同一个指标随时间怎么变,也会用到「拟合直线、做预测」的思路。

5解读(读透版讲义)

哪里没看懂,来这里看大白话讲解。生活例子、考法、坑都在这。可以先读这个再回去读教材。

回归分析(教材原文·OCR)

文字为主,公式/图表以教材扫描为准。配套精华看复习网页。

第二十六章 回归分本

( 一)回归分析的概念

回归分析是指根据相关关系的具体形态,选择一个合适的数学模型 ,来近似地表达变量间

回归分析和相关分析有着密切的联系,它们不仅具有共同的研究对象,而且在具体应用
时,常常必须互相补充。相关分析需要依靠回归分析来表明现象数量相关的具体形式,而回归
分析则需要依靠相关分析来表明现象数量变化的相关程度。只有当变量之间存在着高度相关
时,进行回归分析寻求其相关的具体形式才有意义。

应当指出,相关分析与回归分析之间在研究目的和方法上是有明显区别的。相关分析研
究变量之间相关的方向和相关的程度,但是相关分析不能指出变量间相互关系的具体形式,也
无法从一个变量的变化来推测另一个变量的变化情况。回归分析则是研究变量之间相互关系
的具体形式,它对具有相关关系的变量之间的数量联系进行测定,确定一个相关的数学方程
式,根据这个数学方程式可以从已知量来推测未知量,从而为估算和预测提供了一个重要的方

进行回归分析时,首先需要确定因变量和自变量。在回归分析中,被预测或被解释的变
量称为因变量,一般用了表示; 用来预测或解释因变量的变量称为自变量 ,一般用不表示。例
如,在研究边际消费倾向时,目的是预测一定人均收入条件下的人均消费金额。因此,人均消
费金额是被预测的变量,称为因变量,而用来预测人均消费金额的人均收入就是自变量。

( 二 )一元线性回归模型

根据自变量的多少,回归模型可以分为一元回归模型和多元回归模型。根据是否是线性,
回归模型可以分为线性回归模型和非线性回归模型。一元线性回归模型是描述两个变量之间
相关关系的最简单的回归模型。回归模型可以用描述因变量了如何依赖自变量和和误差项
s 的方程来表示。只涉及一个自变量的一元线性回归模型可以表示为:

了Y=BuHBX+s

式中,B。和局 为模型的参数。

模型中,因变量了Y是自变量X的线性函数(Br8X)加上误差项 s 。Bu+r8工反映了由
于自变量已的变化而引起的因变量了的线性变化。误差项 s 是个随机变量,表示除式和
了的线性关系之外的随机因素对了的影响,是不能由式和了的线性关系所解释的了的变异

描述因变量了的期望天(了) 如何依赖自变量蕊的方程称为回归方程。一元线性回归方
程的形式为:

玖(了)=BoHBX

一元线性回归方程的图示是一条直线,6B。 是回归直线的截距,B, 是回归直线的斜率,表示

和每变动一个单位时,已(了) 的变动量。

230 ”经济基础知识(中级)

二最小二乘法

现实中,模型的参数B 和 都是未知的,必须利用样本数据去估计。假设可得到和和了
的于组观测值,即 ,yz=1,2,…,m,根据样本统计量 B, 和 局 估计模型中的参数B, 和局 之
后,就得到了估计的回归方程:

六=BrBin (i=1,2,.…,m)

式中,有,表示估计的回归直线在了轴上的截距;局, 为估计的回归直线的斜率,它表示自变量式
每变动一个单位时,因变量了的平均变动量。

上式中的语 和局, 确定了回归直线的位置,B, 和局, 一旦确定,这条直线也就唯一确定了。
但对于给定的m”组观测值,可用于描述数据的直线有很多条 ,究竟用哪条直线来代表两个变量
之间的关系,需要有一个明确的原则。我们自然会想到距离各观测点最近的一条直线,即实际
观测点和直线间的距离最小。根据这一思想对回归模型进行估计的方法称为最小二乘法。最
小二乘法就是使因变量的观测值 x 与估计值?, 之间的离差( 又称残差 )平方和最小来估计参
数Bu 和 的方法,如图 26-1 所示。

估计的回归线

26-1 最小二乘法示意图
根据最小二乘法,使得 (7 -)2 = > (7 -房-所x) ?最小。
ie=1

设0= > (一疙) ,在给定了样本数据后, O 是 B, 和 局, 的函数,且最小值总是存在。根
据微积 ,分的极值定理, 对0求相应于语, 和房, 的偏导数,并令其等于0 即可求出 ,和局, 的估
计量:

六人-0

第二让六章,回“归*分"析 .231,

根据表 26-1 中的数据,拟合城镇居民人均可支配收入和人均消费支出的直线回归方程。
根据上面的公式可得:

袜(s-习(人
, 上EE 回
站 (和一无)
忆,=了-局元一4276.984
估计的城镇居民人均可支配收入和人均消费支出的一元线性直线回归方程为;
售=4276.98440.546X

估计的回归系数显示 ,城镇居民家庭人均可支配收入每增加 1 元,城镇居民人均消费支出
将增加 0.546 元。

二0.546

表 26-1 预测值和预测残差

年份 城镇居民人均可 城镇居民人均消费 城镇居 民人均消费 预测值与观测值之间的
支配收入xi(元) 支出%(元) 预测值六(元 ) 残差记-广

2012 24127 17107 17440.5 -333.5
2013 26467 18488 18717.2 -229.2
2014 28844 19968 20014.1 -46.1
2015 31195 21392 21296.7 95.3
2016 33616 23079 22617.6 461.4
2017 36396 24445 24134.4 310.6
2018 39251 26112 25692.0 420.0
2019 42359 28063 27387.7 675.3
2020 43834 27007 28192.5 -1185.5
2021 47412 30307 30144.6 162.4
2022 49283 30391 31165.4 -774.4
2023 51821 32994 32550.1 443.9

三\模型的检验和预测

( 一)回归模型的拟合效果分析
一般情况下 ,在使用估计的回归方程之前,需要对模型进行检验: @D结合经济理论和经验
分析回归系数的经济含义是否合理; @分析估计的模型对数据的拟合效果如何; @对模型进

232,经济基础知识(中级)

行假设检验。
1.决定系数尼。决定系数下,也称为拟合优度或判定系数,可以测度回归模型对样本数
据的拟合程度,其计算公式如下:

(六-帮” (7人)
到= 他 二 1 和
立 57) 密0

决定系数是回归模型所能解释的因变量变化占因变量总变化的比例,取值范围在 0到
1之间。决定系数越高,模型的拟合效果就越好,即模型解释因变量的能力越强。如果所有
观测点都落在回归直线上, 已=1,说明回归直线可以解释因变量的所有变化。尼=0,说明回
归直线无法解释因变量的变化,因变量的变化与自变量无关。现实应用中六 大多落在 0 和
1之间,尼越接近于1,回归模型的拟合效果越好; 尼越接近于0,回归模型的拟合效果越

差。
根据上面估计的回归方程,利用表 26-1 的计算结果 ,计算决定系数:

(7 一7

尼=1 - 一一一~0.988
立 0站

尼为 0.988,说明回归模型的拟合效果很好,即城镇居民人均可支配收入可以很好地解释
城镇居民人均消费支出的变化,从图 26-2 中可以看出模型预测值和观测值非常接近。

一35000

人

一30000

25000

和 20000

壮 15000

< 1000t

或 -全 城什居民人均消费性支出

熏 S000 -量-预测城镇居民人均消费性支出

餐 ” 0 10000 20000 30000 40000 5S0000, 60000
城镇居民人均可支配收入(元)

图 26-2 城镇居民人均消费性支出及其预测值

  1. 回归系数的显著性检验。在大样本假定的条件下,回归系数的最小二乘估计量记和局

渐进服从正态分布,可以用:检验方法验证自变量X对因变量了是否有显著影响。: 检验的原
理是反证法,在原假设B,=0( 自变量X对因变量了没有影响 ) 正确的假定下,基于 记, 的抽样
分布计算一次抽样情况下得到该样本或更极端样本的概率(P值),如果P < 0.05,则可以在
0.05 的显著性水平下拒绝原假设,认为自变量届对因变量了上有显著影响,即 Bi,关0。常见的统
计分析软件拟合回归模型时都会给出;检验的P值,可直接比较P值和显著性水平( 经常取
0.05 ),来判断回归模型的自变量对因变量是否有显著影响。

根据表 26-1 中的城镇居民人均可支配收入和人均消费性支出数据,Excel 软件的回归

第二让六章…,回“明*分"析 237,

函数给出线性回归模型拟合结果见表 26-2,“系数" 列给出 6, 和局, 的最小二乘估计值分别为
4276.984 和0546,'"值” 列给出自变量城镇居民人均可支配收入的:检验P值 =5.728 x 10⁷,
因此可以在 0.05 的显著性水平下拒绝 B,=0 的原假设,认为城镇居民人均可支配收入对城镇
居民人均消费性支出有显著影响。

表 26-2 线性回归模型拟合结果
系数 标准误差 P值
截距 4276.984 734.36021 5.8241 1.674x 10⁷
城镇居民人均可支配收入 0.546 0.01888 28.9026 5.728 x 10

( 二 )模型预测

回归分析的一个重要应用就是预测,即利用估计的回归模型预估因变量数值。例如,根
据上面估计的回归方程, 当城镇居民家庭人均可支配收入 和=40000 元时,人均消费性支出是
多少?

将X=40000 代入回归方程,得:

站 =4276.984+0.546X= 4276.984+0.546 x 40000=26116.984(元)

( 三)二元回归模型案例

利用某公司的 30 位员工数据,以年薪为因变量 了, 以受教育年限(edu ) 和职位(posizion )
为自变量,用 Excel 拟合二元线性回归模型,年薪回归估计结果见表 26-3。其中,年薪(元 )和
受教育年限( 年 )为定量变量; 职位为定性变量, 0 表示一般职员, 1 表示管理者。

表 26-3 年薪回归估计结果
回归统计
R Square 0.632538
AdjustedR Square 和富、,“守 0.605318
观测值 30
系数 标准误差 1 P值
截距 -18716.2 16600.7096 -1.12743 0.26948
受教育年限(edu ) 3669.002 1209.421447 3.033684 0.00529
职位(Position ) 27144.47 8197.976538 3.311118 0.00265

由表 26-3 可以得到估计的二元线性回归方程;
放= -18716.2+3669eduw+27144.47positiom
多元回归模型在实际应用中,随着自变量个数的增加,即使在有些自变量与因变量完
全不相关的情况下 ,决定系数尼 也会增大。为避免因增加自变量个数而高估拟合效果的情
况,多元回归模型一般使用修正了自由度的调整后 庆( Adjusted R Square )。调整后 尼 考虑
了自变量个数增加带来的影响,在数值上小于 尼。表 26-3 中二元线性回归模型的调整后
尼(Adjusted R Square )=0.605 ,表示受教育年限和职位的二元回归模型对年薪的变化可解释程

.234 .经济基础知识(中级)

度为 60.5%。自变量受教育年限和职位的:检验P值 0.00529 和 0.00265 都小于 0.05 ,表明
2个自变量都通过了/+ 检验,对年薪有显著的线性影响。在多元线性回归方程中,偏回归系数
可以衡量在其他自变量保持不变的情况下 ,某一个自变量变化一个单位时,因变量的平均变
化量。本例中,受教育年限( edu ) 的偏回归系数为 3669,即在相同职位上,受教育年限每增长
1年,年薪平均增加 3669 元; 管理者职位 (position ) 的偏回归系数为 27144.47,即在相同受教
育年限的条件下 ,管理者(position=1l ) 的年薪比一般职员 ( position=0 ) 的年薪平均高 27144.47
元。

已知员工甲受教育年限为 10 年,在该公司为一般职员 ,可利用该模型预测其年薪大约为
立=-18716.24+3669 x 10=17973.8(元 )。


零基础复习卡(两版教材核验)

来源核验:主教材《2026经济基础知识中级原书有色差(371)》PDF 第240-245页;《经济基础知识(中级)-292》PDF 第192-193页(书内第184-185页)。

一句话先懂

相关分析告诉你“两者一起变化得多紧”,回归分析进一步写出方程,用已知的自变量去解释或预测因变量。

零基础解释

  1. 角色分工:被解释、被预测的是因变量 `Y`;用于解释、预测的是自变量 `X`。
  2. 总体模型:`Y=β0+β1X+ε`。`β0`是截距,`β1`表示X每增加1单位,Y的条件均值平均变化多少,`ε`装入未被X解释的随机因素。
  3. 样本回归线:`Ŷ=b0+b1X`。最小二乘法选择 `b0、b1`,使残差平方和最小。
  4. 拟合优度:决定系数 `R²` 表示模型解释的总变差比例,范围通常在0到1之间;越接近1,样本拟合越好,但不自动证明因果或模型一定正确。
  5. 显著性检验:常检验 `H0:β1=0`。若P值小于显著性水平(如0.05),拒绝原假设,认为X对Y的线性影响显著。

必背清单

  • 相关分析不区分自变量、因变量;回归分析必须区分。
  • 回归分析研究具体数量关系并可预测;相关分析研究方向和程度。
  • `SST=SSR+SSE`:总变差=回归解释变差+残差变差。
  • `R²=SSR/SST=1-SSE/SST`。
  • 一元线性回归中,斜率 `b1` 与相关系数 `r` 符号相同。
  • P值小于显著性水平:拒绝 `β1=0`;P值大:证据不足,不是“证明β1一定等于0”。

易混点

  • 相关不等于因果:共同趋势、遗漏变量或反向作用都可能造成相关。
  • 残差不是误差项本身:误差项是总体模型中不可观测的随机项,残差是样本中 `e=Y-Ŷ`。
  • R²高不等于预测必准,也不说明变量选择合理。
  • 截距若不在样本X的合理范围内,机械解释可能没有经济意义。

记忆口诀

  • “相关看方向强弱,回归定角色写方程”。
  • “P小拒零,R方看解释”。

自测题

  1. 单选:研究收入对消费的影响,消费应作为( )。A自变量 B因变量 C误差项 D常数

答案:B。 消费是被解释、被预测的变量。

  1. 判断:相关分析必须先指定自变量和因变量。

答案:错。 相关分析对两个变量地位对称,回归分析才区分角色。

  1. 计算:`Ŷ=100+3X`,当X增加2单位时,预测Y平均增加多少?

答案:6。 斜率3乘以2。

  1. 单选:某模型 `R²=0.72`,正确解释是( )。A模型必然正确 B72%的Y总变差被模型解释 C相关系数为0.72 D存在因果

答案:B。 R²衡量样本拟合优度。

  1. 判断:P值0.01,小于0.05,通常拒绝“回归系数等于0”的原假设。

答案:对。 说明样本证据支持线性影响显著。

  1. 判断:残差平方和越小,R²通常越小。

答案:错。 在总变差不变时,SSE越小,`R²=1-SSE/SST`越大。

6刷题(章节配套练习,含校订与教学改编)

先做后看答案。单选点一下就判,多选选完点「核对答案」。错题自动进错题本,二轮会回来重做。

1. 单项选择题
根据相关关系的具体形态,选择一个合适的数学模型,来近似地表达变 量间的平均变化关系,这指的是()。
A. 相关分析B. 回归分析C. 定量分析D. 定性分析
答案 B 回归分析就是根据相关关系的具体形态,选择一个合适的数学模型,来近似地表达 变量间的平均变化关系。回归分析研究变量之间相互关系的具体形式。
2. 单项选择题
研究变量之间相互关系的具体形式,应采用的统计方法是()。
A. 回归分析B. 相关分析C. 集中趋势分析D. 分布形态测度
答案 A 回归分析通过数学模型描述变量之间的平均变化关系及其具体形式,选A。
3. 单项选择题
下列关于回归分析和相关分析之间关系的说法,正确的是()。
A. 具有共同的研究方法B. 具有共同的研究对象C. 相关分析需要依靠回归分析来表明现象数量变化的相关程度D. 回归分析需要依靠相关分析来表明现象数量相关的具体形式
答案 B 本题考查回归分析和相关分析的联系和区别。相关分析和回归分析在研究目的和 方法上是有明显区别的,选项A错误。回归分析需要依靠相关分析来表明现象数量变化的相 关程度,选项C错误。相关分析需要依靠回归分析来表明现象数量相关的具体形式,选项D 错误。
4. 单项选择题
进行回归分析时,首先需要确定()。
A. 函数形式B. 变量之间的表达式C. 因变量和自变量D. 研究范围
答案 C 进行回归分析时,首先需要确定因变量和自变量。回归分析中,被预测或被解释的 变量称为因变量,一般用Y表示;用来预测或解释因变量的变量称为自变量,一般用X表示。
5. 单项选择题
在回归分析中,被预测或被解释的变量称为()。
A. 因变量B. 自变量C. 控制变量D. 调节变量
答案 A 回归分析中,被预测或被解释的变量称为因变量。
6. 单项选择题
在进行回归分析时,用来预测和解释因变量的变量称为()。
A. 随机变量B. 自变量C. 误差项D. 模型参数
答案 B 在回归分析中,用来预测或解释因变量的变量称为自变量。
7. 多项选择题
关于相关分析和回归分析的说法,正确的有()。
A. 相关分析研究变量间相关的方向和相关程度B. 相关分析可以从一个变量的变化来推测另一个变量的变化C. 回归分析研究变量间相互关系的具体形式D. 相关分析和回归分析在研究方法和研究目的上有明显区别E. 相关分析中需要明确自变量和因变量
答案 ACD 回归分析与相关分析的联系:①它们具有共同的研究对象;②在具体应用时,常 常必须互相补充。相关分析与回归分析在研究目的和方法上具有明显的区别:①相关分析研 究变量之间相关的方向和相关的程度;②回归分析是研究变量之间相关关系的具体形式,它对 具有相关关系的变量之间的数量联系进行测定,确定相关的数学方程式,根据这个数学方程式 可以从已知量来推测未知量,从而为估算和预测提供了一个重要方法。
8. 单项选择题
一元线性回归模型的数学表达式是()。
A. Y=β+β₁B. Y=β+β₁XC. Y=β₀+β₁X+εD. Y=β₀+β₁X
答案 C 理论一元线性回归模型为Y=β₀+β₁X+ε,含随机误差项,故选C。其条件期望方程和样本估计方程应分别与理论模型区分。

校勘说明:为区分理论模型与拟合方程、消除残缺选项或明确统计条件所作的校订后教学题设,不冒充原题原文。

9. 单项选择题
在一元线性回归模型Y=β₀+β₁X+ε且E(ε|X)=0的条件下,β₀表示()。
A. X每增加1个单位时Y的平均增加量B. 回归直线的斜率C. X=0时Y的条件期望值D. 随机误差项的方差
答案 C β₀是截距,E(Y|X=0)=β₀;β₁为斜率。故选C。

校勘说明:为区分理论模型与拟合方程、消除残缺选项或明确统计条件所作的校订后教学题设,不冒充原题原文。

10. 单项选择题
一元线性回归模型Y=β₀+β₁X+ε中,误差项ε表示()。
A. 回归直线的截距B. 除X 和Y线性关系外的随机因素对Y的影响C. 回归直线的斜率D. 观测值和估计值之间的残差
答案 B ε是随机变量,表示未由模型中X与Y的线性关系解释的Y的变异。样本残差是观测值与拟合值之差,与理论误差项不同。
11. 单项选择题
在一元线性回归模型中,回归系数β₁的实际意义是()。
A. 当自变量X=0时,因变量Y的期望值B. 当自变量X变动1个单位时,因变量Y的平均变动量C. 当自变量X=0时,自变量X的期望值D. 当因变量Y变动1个单位时,自变量X的平均变动量
答案 B β₁是回归直线斜率,表示X每变动1个单位时Y的平均变动量,选B。
12. 单项选择题
从估计的回归方程ŷ=6.2−0.8X可以得出()。
A. X 每增加1个单位,Y增加0.8个单位B. X 每增加1个单位,Y减少0.8个单位C. X 每增加1个单位,Y平均增加0.8个单位D. X 每增加1个单位,Y平均减少0.8个单位
答案 D 斜率为−0.8,表示X每增加1个单位,Y的预测平均值减少0.8个单位,选D。

校勘说明:为明确统计定义、经验标准或教学条件所作的校订后教学题设,不冒充原题原文。

13. 多项选择题
对商品价格X和销售收入Y进行回归分析,得到估计方程ŷ=1200−10X(X、Y单位均为元)。下列说法正确的有()。
A. 商品价格每减少1元,模型预测的销售收入平均增加10元B. 商品价格每增加1元,销售收入平均增加10元C. 商品价格每增加1%,销售收入平均增加10%D. 当商品价格为20元时,销售收入的模型预测值为1000元E. 商品价格每减少1%,销售收入平均减少10%
答案 AD 斜率−10表示X减少1元时预测均值增加10元;X=20时ŷ=1200−10×20=1000元。百分比变化不能由线性斜率直接推出,故修订后选AD。

校勘说明:为区分理论模型与拟合方程、消除残缺选项或明确统计条件所作的校订后教学题设,不冒充原题原文。

14. 多项选择题
关于估计的回归方程ŷ=6000+0.7X,下列说法正确的有()。
A. X每增加1个单位,Y的预测均值增长0.7个单位B. X每减少1个单位,Y的预测均值增长0.7个单位C. X每增加1%,Y平均增长7%D. X每减少1%,Y平均增长7%E. 当X为20000时,Y的预测值为20000
答案 AE 斜率为0.7,X增加1单位对应预测均值增加0.7单位;X=20000时ŷ=6000+0.7×20000=20000,选AE。

校勘说明:为区分理论模型与拟合方程、消除残缺选项或明确统计条件所作的校订后教学题设,不冒充原题原文。

15. 多项选择题
在一元线性回归模型Y=β₀+β₁X+ε且E(ε|X)=0时,下列说法正确的有()。
A. β₀+β₁X描述给定X时Y的线性条件均值B. ε表示除X和Y的线性关系之外的随机因素对X的影响C. ε表示除X和Y的线性关系之外的随机因素对Y的影响D. ε可以由X和Y的线性关系解释E. 误差项ε是一个确定变量
答案 AC 在给定模型假设下,β₀+β₁X描述Y随X变化的线性均值关系;ε表示未被该线性关系解释的Y的随机变异,故AC正确。这里的解释是模型中的统计解释,不能单凭回归式认定因果。

校勘说明:为区分理论模型与拟合方程、消除残缺选项或明确统计条件所作的校订后教学题设,不冒充原题原文。

16. 单项选择题
用样本估计一元线性回归模型参数β₀、β₁的常用方法是()。
A. 二次平均B. 加权平均C. 斯特基方法D. 最小二乘法
答案 D 最小二乘法选择使因变量观测值与拟合值之差的平方和最小的参数估计,故选D。

校勘说明:为明确统计定义、经验标准或教学条件所作的校订后教学题设,不冒充原题原文。

17. 单项选择题
在回归分析中,估计回归系数的最小二乘法的原理是使得()之间 的离差平方和最小。
A. 自变量观测值与均值B. 因变量估计值与均值C. 自变量观测值与估计值D. 因变量观测值与估计值
答案 D 最小二乘法以残差平方和Σ(yi−ŷi)²最小为准则,即因变量观测值与拟合值之间的离差平方和最小,选D。
18. 单项选择题
线性回归模型常用的参数估计方法是()。
A. 最大二乘法B. 最小二乘法C. 最小残差和法D. 最大残差和法
答案 B 线性回归模型常用的估计方法是最小二乘法。
19. 单项选择题
在含截距的普通最小二乘线性回归中,因变量有非零样本方差时,关于样本内普通决定系数R²的说法,正确的是()。
A. 可以为负数B. 可以为正数C. 可以大于1D. 可以等于-1
答案 B 该条件下普通R²=1−SSE/SST,取值在0到1之间,可以为正数,选B。

校勘说明:为区分理论模型与拟合方程、消除残缺选项或明确统计条件所作的校订后教学题设,不冒充原题原文。

20. 单项选择题
测度回归直线对样本数据拟合程度的是()。
A. 相关系数B. 样本估计量C. 决定系数D. 回归系数
答案 C 决定系数记为R²,用于衡量回归模型对样本数据的拟合程度,选C。
21. 单项选择题
下列统计量中,可以测度回归模型对样本数据拟合程度的是()。
A. 决定系数B. 回归截距C. 回归斜率D. 预测值
答案 A 决定系数R²用于衡量模型对样本数据的拟合程度。含截距普通最小二乘回归且因变量样本方差非零时,它等于模型解释平方和占总平方和的比例,选A。
22. 单项选择题
在含截距的普通最小二乘线性回归中,因变量样本方差非零时,样本内普通决定系数R²是指()的比例。
A. 模型能解释的因变量变化占因变量总变化B. 因变量总变化占模型能解释的因变量变化C. 模型能解释的因变量变化占自变量总变化D. 自变量的变化占因变量变化
答案 A 含截距普通最小二乘回归中,R²=解释平方和/总平方和=1−残差平方和/总平方和,表示模型解释的因变量变异占其总变异的比例。

校勘说明:为区分理论模型与拟合方程、消除残缺选项或明确统计条件所作的校订后教学题设,不冒充原题原文。

23. 单项选择题
某机构拟合康复率与药物剂量的回归模型,剂量系数双侧t检验(H₀:β₁=0)的P值为0.08。在0.05显著性水平下,下列说法正确的是()。
A. 可以认为药物剂量的回归系数显著不为0B. 药物剂量每增加1个单位,康复率提高8%C. 尚无足够统计证据认为药物剂量的回归系数不为0D. 已证明药物剂量与康复率没有任何关系
答案 C P=0.08>0.05,不能拒绝H₀:β₁=0,选C。不拒绝不等于证明原假设为真,P值也不是效应大小或因果关系的证明。

校勘说明:为区分理论模型与拟合方程、消除残缺选项或明确统计条件所作的校订后教学题设,不冒充原题原文。

24. 多项选择题
在含截距的普通最小二乘线性回归中,因变量样本方差非零,且各模型使用相同因变量和相同样本。关于样本内普通决定系数R²,下列说法正确的有()。
A. R²是回归模型所能解释的因变量变化占因变量总变化的比例B. R²的取值范围是大于0C. R²数值越大,回归模型的拟合效果越好D. R²越接近于0,回归模型的拟合效果越差E. 自变量个数对未经调整的R²没有影响
答案 ACD 决定系数是回归模型所能解释的因变量变化占因变量总变化的比例,R²的取值范围为0到1。R²越大,模型的拟合效果越好;越接近于0,拟合效果越差,所以A、C、D正确。B错误,因为R²可以等于0。在含截距的普通最小二乘回归中,增加自变量不会使未经调整的R²减小,并可能使其增大,因此E所说“没有影响”错误。E项为网站针对原书未定义符号S作出的明确化改编,原答案A、C、D不变。

校勘说明:《经济基础知识(中级)章节同步习题集-304.pdf》原PDF第209页题面、第211页答案。原书E项写“自变量个数对S没有影响”,但S未在本题定义。网站透明校订为“自变量个数对未经调整的R²没有影响”,这是网站明确化改编的选项,不声称是原书原文;保留原答案。本次另补含截距、非零方差及相同样本等适用条件,属于校订后的教学题设,不冒充原题原文。

25. 多项选择题
一般情况下,使用估计的回归方程之前,需要对模型进行的检验有 ()。
A. 分析回归系数的经济含义是否合理B. 分析变量之间相关的方向C. 分析估计的模型对数据的拟合效果如何D. 分析变量之间相关的程度E. 对模型进行假设检验
答案 ACE 一般情况下,使用估计的回归方程之前,需要对模型进行的检验有:①结合经济 理论和经验分析回归系数的经济含义是否合理;②分析估计的模型对数据的拟合效果如何; ③对模型进行假设检验。
26. 多项选择题
在含截距的普通最小二乘线性回归中,因变量样本方差非零时,下列关于样本内普通决定系数R²的说法正确的有()。
A. 决定系数可以测度回归直线对样本数据的拟合程度B. 决定系数可以取负值C. 决定系数等于1,说明回归直线可以解释样本中因变量的所有变异D. 决定系数等于0,说明该线性回归无法解释因变量的样本变异,但不能排除非线性关系E. 决定系数越接近0,回归直线的拟合效果越好
答案 ACD 普通样本内R²在0到1之间;1表示样本点完全落在拟合线上,0表示该线性模型没有解释样本变异,但不能证明变量毫无关系。修订后ACD正确。

校勘说明:为区分理论模型与拟合方程、消除残缺选项或明确统计条件所作的校订后教学题设,不冒充原题原文。

7本章打卡

做完一项勾一项,当天页会自动更新整体进度。

学完这章就是往前走了一步。记不住的,明天再来看必背,不用今天全记住。

↑ 回到今日顶部

1重点一览

先花 2 分钟看清这章有几个考点、哪几个是必考,心里有数再读书。

12页教材0个 ★★★1个 ★★4个 ★41道章节题约 96 分钟教材印刷页 235-246
考点一 时间序列★
考点二 时间序列的水平分析★
考点三 时间序列的速度分析★★
考点四 时间序列的分解和预测程序★
考点五 平滑预测法★

2教材标色 + 三色笔记

左边是教材原文,彩色句子就是《考点速记》收了的内容,颜色是星级。右边是速记的考点表,和左边的小节对齐。读一节,看一眼右边的表,再往下走。

一、时间序列及其分类

教材 P235

社会经济现象总是随着时间的推移而变化,呈现动态性。统计对社会经济现象的研究,不仅要从静态上揭示研究对象在具体时间、地点、条件下的数量特征和数量关系,而且要从动态上反映其发展变化过程及规律性。统计对事物进行动态研究的基本方法是编制时间序列。

时间序列也称动态数列,是将某一统计指标在各个不同时间上的数值按时间先后顺序编制形成的序列。表 27-1 列举了我国 2017 到 2023 年若干国民经济指标资料。

表 27-1 我国 2017 到 2023 年若干国民经济指标

指标2017201820192020202120222023
国内生产总值(亿元)847382.9936010.11005872.41034867.61173823.01234029.41294271.7
年底总人口数(万人)140011140541141008141212141260141175140967
人均国内生产总值(元/人)60691667267145373338831118738591746
城镇人口比重(%)60.261.562.763.964.765.266.2

资料来源:《中国统计年鉴》

从表 27-1 中可以看出,时间序列由两个基本因素构成:一个是被研究现象所属时间,另一个是反映该现象在一定时间条件下数量特征的指标值。时间构成要素反映时间单位的不同,如年、季、月、日等。表中四个指标以年的顺序进行排列,称为年份时间序列;若以季、月、日为序排列,则称为季、月、日时间序列。同一时间序列中,各指标值的时间单位一般要求相等,这样在分析研究中无须考虑时间单位不同所造成的差异。时间序列中所排列指标值是具有某种性质特征的指标的具体数量表现,表中的四个时间序列代表四种不同的指标,它们是划分时间序列类型的依据。

时间序列按照其构成要素中统计指标值的表现形式,分为绝对数时间序列、相对数时间序列和平均数时间序列三种类型。绝对数时间序列是由绝对数指标值按时间先后顺序排列后形成的序列。依据指标值的时间特点,绝对数时间序列又分为时期序列和时点序列。时期序列中,每一指标值都反映现象在一段时期内发展的结果,即“过程总量”,如表 27-1 中的国内生产总值是当年各月国内生产总值相加的结果。时点序列中,每一指标值都反映现象在一定时点上的瞬间水平,如年底总人口数表明在各年年末时点上的人口数。由绝对数时间序列可以派生出相对数时间序列和平均数时间序列。它们是由同类相对数或平均数指标值按时间先后

教材 P236

顺序排列后形成的序列。表 27-1 中,城镇人口比重是相对数时间序列,人均国内生产总值则是平均数时间序列。

二、时间序列的水平分析

(一)发展水平

发展水平是时间序列中对应于具体时间的指标数值。也就是说,在绝对数时间序列中,发展水平就是绝对数;在相对数和平均数时间序列中,发展水平表现为相对数或平均数。

设时间序列以 y0,y1,y2,…,yn 表示,序列中第一项的指标值 y0 为最初水平,最末项的指标值 yn 为最末水平,处于两者之间的各期指标值(y1,y2,…,yn-1)则为中间水平。根据各期指标值在计算动态分析指标时的作用来划分,又可以分为基期水平和报告期水平。基期水平是作为对比的基础时期的水平,报告期水平则是所要反映与研究的那一时期的水平。

(二)平均发展水平

平均发展水平也称序时平均数或动态平均数,是根据时间序列中各时期发展水平计算的平均数,它可以概括性描述现象在一段时期内所达到的一般水平。时间序列类型不同,计算方法也不同。

1. 绝对数时间序列序时平均数的计算。

(1)由时期序列计算序时平均数。对于时期序列,序时平均数计算公式为

ȳ = (y1 + y2 + … + yn) ÷ n = Σyi ÷ n

式中,yi 为各时期的发展水平(i = 1,2,…,n),n 为时期序列的项数,ȳ 为序时平均数。

例如,根据表 27-1 中的国内生产总值时间序列,计算各年度的平均国内生产总值。

ȳ = (y1 + y2 + … + y7) ÷ 7 = (847382.9 + 936010.1 + … + 1294271.7) ÷ 7 = 7526257.1 ÷ 7 ≈ 1075179.6(亿元)

我国 2017 到 2023 年平均国内生产总值为 1075179.6 亿元。

(2)由时点序列计算序时平均数。时点序列的指标值反映现象在某一时点上的瞬间水平,要正确计算其平均数,从理论上说,应当掌握每一时点上的指标值,然后计算平均单位时点的指标数值。在社会经济统计中一般是将一天看作一个时点,即以“天”作为最小时间单位。这样便有连续时点序列和间断时点序列的区分。资料逐日登记的是连续时点序列;资料不是逐日登记,而是间隔较长一段时间(月、季或年)后再登记一次,然后依序排列的是间断时点序列。这两种时点序列的类型不同,计算序时平均数的方法也有所不同。

第一种情况,由连续时点计算,又分为两种情形。

一种情形是资料逐日登记且逐日排列,即已掌握了整段考察时期内连续性的时点数据,可采用简单算术平均数方法计算,计算公式同样为:

ȳ = (y1 + y2 + … + yn) ÷ n = Σyi ÷ n

式中,yi 为各时点的指标值(i = 1,2,…,n),n 为时点个数,ȳ 为序时平均数。

教材 P237

另一种情形是资料登记的时间单位仍然是 1 天,但实际上只在指标值发生变动时才记录一次。此时需采用加权算术平均数的方法计算序时平均数,权数是每一指标值的持续天数,计算公式为

ȳ = (y1f1 + y2f2 + … + ynfn) ÷ (f1 + f2 + … + fn) = Σyifi ÷ Σfi

式中,yi 为各时点的指标值(i = 1,2,…,n),fi(i = 1,2,…,n)为指标值的持续天数。

例:某种商品 6 月份的库存量记录见表 27-2。

表 27-2 某种商品 6 月份的库存量记录

日期1 到 45 到 78 到 1314 到 2021 到 2324 到 2829 到 30
库存量(台)49523929433851

该商品 6 月份的平均日库存量为:

ȳ = (49×4 + 52×3 + 39×6 + 29×7 + 43×3 + 38×5 + 51×2) ÷ (4 + 3 + 6 + 7 + 3 + 5 + 2) ≈ 40(台)

第二种情况,由间断时点计算,又分为两种情形。

一种情形是每隔一定的时间登记一次,每次登记的间隔相等。间隔相等的间断时点序列序时平均数的计算公式为:

ȳ = [(y1 + y2) ÷ 2 + (y2 + y3) ÷ 2 + … + (yn-1 + yn) ÷ 2] ÷ (n − 1)

式中,yi 为各时点的指标值(i = 1,2,…,n),n 为时点个数,ȳ 为序时平均数。

由上式可见,间隔相等的间断时点序列序时平均数的计算思路是“两次平均”:先求各个时间间隔内的平均数,再对这些平均数进行简单算术平均。

另一种情形是每隔一定的时间登记一次,每次登记的间隔不相等。间隔不相等的间断时点序列序时平均数的计算公式为:

ȳ = [(y1 + y2) ÷ 2 × f1 + (y2 + y3) ÷ 2 × f2 + … + (yn-1 + yn) ÷ 2 × fn-1] ÷ (f1 + f2 + … + fn-1)

间隔不相等的间断时点序列序时平均数的计算也采用“两次平均”的思路,且第一次的平均计算与间隔相等的间断序列相同;进行第二次平均时,由于各间隔不相等,所以应当用间隔长度作为权数,计算加权算术平均数。

例:根据表 27-3 计算某国 2011 到 2023 年平均每年第三产业从业人员数。

表 27-3 某国 2011 到 2023 年第三产业从业人员数(年底数)

年份201120142016201920212023
第三产业从业人员数(万人)271853092033042355613586835639
教材 P238

ȳ = [(27185 + 30920) ÷ 2 × 3 + (30920 + 33042) ÷ 2 × 2 + (33042 + 35561) ÷ 2 × 3 + (35561 + 35868) ÷ 2 × 2 + (35868 + 35639) ÷ 2 × 2] ÷ (3 + 2 + 3 + 2 + 2) = 33080(万人)

2. 相对数或平均数时间序列序时平均数的计算。相对数或平均数时间序列是派生数列,相对数或平均数通常是由两个绝对数对比形成的。要计算相对数或平均数时间序列的序时平均数,不能就序列中的相对数或平均数直接进行平均计算;而必须分别求出分子指标和分母指标时间序列的序时平均数,然后再进行对比。用公式表示:

ȳ = ā ÷ b̄

式中,ȳ 为相对数或平均数时间序列的序时平均数,ā 为分子指标时间序列的序时平均数,b̄ 为分母指标时间序列的序时平均数。

例:根据表 27-4 计算某国 2018 到 2023 年第三产业从业人员数占总从业人员数比重的年平均数。

表 27-4 某国 2018 到 2023 年从业人员数(年底数)

年份201820192020202120222023
总从业人员数(万人)757827544775064746527335174041
第三产业从业人员数(万人)349113556135806358683458335639
第三产业从业人员数占总从业人员数比重(%)46.0747.1347.7048.0547.1548.13

ā = [(34911 + 35561) ÷ 2 + (35561 + 35806) ÷ 2 + (35806 + 35868) ÷ 2 + (35868 + 34583) ÷ 2 + (34583 + 35639) ÷ 2] ÷ 5 = 35418.6(万人)

b̄ = [(75782 + 75447) ÷ 2 + (75447 + 75064) ÷ 2 + (75064 + 74652) ÷ 2 + (74652 + 73351) ÷ 2 + (73351 + 74041) ÷ 2] ÷ 5 = 74685.1(万人)

ȳ = ā ÷ b̄ = 35418.6 ÷ 74685.1 × 100% ≈ 47.4%

该国 2018 到 2023 年第三产业从业人员数占总从业人员数比重的年平均数为 47.4%。

(三)增长量与平均增长量

1. 增长量。增长量是报告期发展水平与基期发展水平之差,反映报告期比基期增加(减少)的绝对数量。计算公式为:

增长量 = 报告期水平 − 基期水平

根据基期的不同确定方法,增长量可分为逐期增长量和累计增长量。

(1)逐期增长量。逐期增长量是报告期水平与前一期水平之差,用公式表示为:

Δi = yi − yi-1(i = 1,2,…,n)

它表明现象逐期增加(减少)的绝对数量。当 i = 1 时,y0 表示时间序列的最初水平;y1 是

教材 P239

研究范围的起始期水平。

(2)累计增长量。累计增长量是报告期水平与某一固定时期水平(通常是时间序列最初水平)之差,用公式表示为:

Δi' = yi − y0(i = 1,2,…,n)

它表明报告期比该固定时期增加(减少)的绝对数量。

易于看出,同一时间序列中,累计增长量等于相应时期逐期增长量之和,即:

Δi' = yi − y0 = Σ(yi − yi-1)(i = 1,2,…,n)

2. 平均增长量。平均增长量是时间序列中逐期增长量的序时平均数,它表明现象在一定时段内平均每期增加(减少)的数量。计算公式为:

Δ̄ = Σ(yi − yi-1) ÷ n(i = 1,2,…,n)

式中,n 表示逐期增长量个数。

根据逐期增长量与累计增长量之间的数量关系,平均增长量还可以用下式表示:

Δ̄ = (yn − y0) ÷ (N − 1)

式中,N 表示时间序列项数。

三、时间序列的速度分析

(一)发展速度与增长速度

1. 发展速度。发展速度是以相对数形式表示的两个不同时期发展水平的比值,表明报告期水平已发展到基期水平的几分之几或若干倍。计算公式为:

发展速度 = 报告期水平 ÷ 基期水平

由于基期选择的不同,发展速度有定基与环比之分。定基发展速度是报告期水平与某一固定时期水平(通常是最初水平)的比值,用 ai 表示,则有:

ai = yi ÷ y0(i = 1,2,…,n)

它说明社会经济现象相对于某个基础水平,在一定时期内总的发展速度。

环比发展速度是报告期水平与其前一期水平的比值,用 bi 表示,则有:

bi = yi ÷ yi-1(i = 1,2,…,n)

它说明所研究现象相邻两个时期(逐期)发展变化的程度。

由上式可知,定基发展速度时间序列中,各时期比较的基础固定在一个共同的水平(y0)上;环比发展速度时间序列则呈现各时期发展水平交替作为报告期与基期使用的循环对比状态。两者虽有区别,但也存在着一定的数量依存关系。

第一,定基发展速度等于相应时期内各环比发展速度的连乘积。

yn ÷ y0 = (y1 ÷ y0) × (y2 ÷ y1) × … × (yn ÷ yn-1)

教材 P240

第二,两个相邻时期定基发展速度的比率等于相应时期的环比发展速度。

(yi ÷ y0) ÷ (yi-1 ÷ y0) = yi ÷ yi-1

实际工作中,经常利用上述关系式对发展速度指标进行推算或换算。

2. 增长速度。增长速度是报告期增长量与基期水平的比值,表明报告期水平比基期增长(或降低)了若干倍(或百分之几)。计算公式为:

增长速度 = 增长量 ÷ 基期水平

由于基期选择的不同,增长速度也有定基与环比之分。上述计算公式中,若增长量为累计增长量,则计算的是定基增长速度,用 Ai 表示,就有:

Ai = (yi − y0) ÷ y0 = ai − 1(i = 1,2,…,n)

若增长量为逐期增长量,则计算的是环比增长速度,用 Bi 表示,就有:

Bi = (yi − yi-1) ÷ yi-1 = bi − 1(i = 1,2,…,n)

发展速度与增长速度是对社会经济现象进行动态分析的基本指标,应用中要注意的问题是:定基增长速度与环比增长速度不能像定基发展速度与环比发展速度那样互相推算,因为定基增长速度不等于相应时期内各环比增长速度的连乘积;两个相邻时期定基增长速度的比率也不等于相应时期的环比增长速度。定基增长速度与环比增长速度之间的推算,必须通过定基发展速度和环比发展速度才能进行。

(二)平均发展速度与平均增长速度

平均发展速度和平均增长速度是两个非常重要的平均速度指标。前者反映现象在一定时期内逐期发展变化的一般程度,后者则反映现象在一定时期内逐期增长(降低)变化的一般程度。因此,这两个指标在国民经济管理和统计分析中有广泛的应用,是编制和检查计划的重要依据,还可以用于一个国家或地区不同阶段发展状况的比较,以及同一时期不同国家或地区发展状况的比较。

就计算方法来说,重点是平均发展速度指标。因为平均增长速度既不能由各期的环比增长速度求得,也不能根据一定时期的总增长速度计算,平均增长速度是通过它与平均发展速度之间的数量关系求得的:

平均增长速度 = 平均发展速度 − 1

由于平均发展速度是一定时期内各期环比发展速度的序时平均数,各时期对比的基础不同,所以不能采用一般序时平均数的计算方法。目前,计算平均发展速度通常采用几何平均法,几何平均法也称水平法。采用这一方法的原理是,一定时期内现象发展的总速度等于各期环比发展速度的连乘积。根据平均数的计算原理,应当按连乘法,即几何平均数公式计算各指标值的平均数。

yn ÷ y0 = (y1 ÷ y0) × (y2 ÷ y1) × … × (yn ÷ yn-1) = b1 × b2 × … × bn = Π bi

式中,Π 为连乘号,bi 为环比发展速度,n 为环比发展速度的时期数,则:

教材 P241

b̄ = ⁿ√(Π bi) = ⁿ√(yn ÷ y0)

式中,b̄ 为平均发展速度。

上述两式都是平均发展速度几何平均法的计算公式,可以根据资料的掌握情况选择应用。

(三)速度的分析与应用

在应用速度分析实际问题时,须防止误用乃至滥用的现象,应注意:

1. 当时间序列中的指标值出现 0 或负数时,不宜计算速度。例如,假定某企业连续 5 年的利润额分别为 5 万元、2 万元、0、−3 万元、2 万元,对这一序列计算速度,要么不符合数学公理,要么无法解释其实际意义。在这种情况下,适宜直接用绝对数进行分析。

2. 速度指标的数值与基数的大小有密切关系。在环比增长速度时间序列中,各期的基数不同,因此,运用这一指标反映现象增长的快慢时,往往要结合水平指标的分析才能得出正确结论,“增长 1% 的绝对值”是进行这一分析的指标。它反映同样的增长速度,在不同时间条件下所包含的绝对水平。计算公式为:

增长 1% 的绝对值 = 逐期增长量 ÷ 环比增长速度

用符号表示为:

增长 1% 的绝对值 = (yi − yi-1) ÷ [(yi − yi-1) ÷ yi-1 × 100] = yi-1 ÷ 100

环比增长速度是相对数,一般用百分数表示。上式推导中分母指标乘以 100,就将它还原为绝对数,这样才能与分子指标对比计算。

例如,某市 2018 到 2024 年能源生产量列于表 27-5,根据这些资料计算的发展速度、增长速度及增长 1% 的绝对值也列于该表中。

表 27-5 某市 2018 到 2024 年能源生产量及速度指标

年份2018201920202021202220232024
发展水平(万吨标准煤)99.38152.31160149.79190.77187.57191.3
定基发展速度(%)100153.26161.00150.72191.96188.74192.49
环比发展速度(%)无153.26105.0593.62127.3698.32101.99
定基增长速度(%)无53.2661.0050.7291.9688.7492.49
环比增长速度(%)无53.265.05−6.3827.36−1.681.99
增长 1% 的绝对值(万吨标准煤)无0.991.521.601.501.911.88

(1)由表中资料可以验证定基发展速度与环比发展速度之间的数量依存关系。

192.49% = 153.26% × 105.05% × 93.62% × 127.36% × 98.32% × 101.99%

教材 P242

即 2024 年与 2018 年的定基发展速度等于这一时期各年环比发展速度的乘积。又如:

101.99% = 192.49% ÷ 188.74%

即 2024 年与 2023 年的环比发展速度等于这两年定基发展速度的比率。

(2)由表中资料可以看到,2022 年能源生产量的环比增长速度是 27.36%,大于 2024 年的 1.99%,但是 2022 年能源生产量每增加 1% 的生产绝对量为 1.50 万吨标准煤,却低于 2024 年的 1.88 万吨标准煤,可见,2024 年该市的能源发展水平并不比 2022 年差,反而更好。

(3)用几何平均法计算该市 2018 到 2024 年能源生产量平均发展速度和平均增长速度。

b̄ = ⁶√(Π bi) = ⁶√(153.26% × 105.05% × 93.62% × 127.36% × 98.32% × 101.99%) = ⁶√192.50% ≈ 111.53%

或 b̄ = ⁶√(y6 ÷ y0) = ⁶√(191.3 ÷ 99.38) = ⁶√1.9249 ≈ 111.53%

平均增长速度 = b̄ − 1 = 111.53% − 1 = 11.53%

四、时间序列的分解和预测程序

时间序列的变化可能受一种或几种因素的影响,这种因素称为时间序列的成分。时间序列的成分通常有长期趋势(T)、季节变动(S)、循环波动(C)和不规则波动(I)等四种。

长期趋势(T)是时间序列在较长一段时间内呈现的持续上升或持续下降的变动。这种趋势可能是线性的,也可能是非线性的。

季节变动(S)是时间序列在一年内重复出现的周期性波动。例如,旅游、商品销售、农业生产、交通运输等行业的生产经营中都有明显的季节变动特征。

循环波动(C)是时间序列呈现出的非固定长度的周期性变动。例如,经济周期有涨落相间的交替波动,周期长短不一,无固定规律。

不规则波动(I)是时间序列中除去长期趋势、季节变动和循环波动之后的随机波动。不规则波动往往是由一些偶然因素引起的,难以预测和控制,因此在时间序列预测中通常不予单独考虑。

一个时间序列可能只包含一种成分,也可能是由几种成分混合而成的(见图 27-1)。时间序列分析时经常在一定的模型假定下把这些成分从时间序列里分离出来,对各成分分别进行分析。不同的模型中对四种成分之间的关系假定不同,如加法模型中假定 Yt = Tt + St + Ct + It,乘法模型中假定 Yt = Tt × St × Ct × It。

时间序列分析的一个主要目的就是根据历史数据对未来进行预测。时间序列的预测通常包括以下几个步骤:

第一步:确定时间序列所包含的成分;

第二步:找出适合该时间序列的预测方法;

第三步:对可能的预测方法进行评估,以确定最佳预测方案;

第四步:利用最佳预测方案进行预测。

教材 P243

图 27-1 含有不同成分的时间序列(四幅折线图,此处略)

a)有趋势的时间序列图 b)有趋势和季节性的时间序列图 c)有周期变动的时间序列图 d)不规则波动的时间序列图

五、平滑预测法

平滑法的目的就是“消除”时间序列的不规则成分所引起的随机波动,所以被称为平滑法,包括移动平均法和指数平滑法等。平滑法适用于平稳时间序列的预测,即没有明显的趋势、循环和季节波动的时间序列。平滑法简单易用,对数据的要求最低,通常对于近期(如下一期)的预测具有较高的精度。

(一)移动平均法

移动平均法使用时间数列中最近 k 期数据值的平均数作为下一期的预测值,其计算公式为:

Ȳt = (Yt-k+1 + Yt-k+2 + … + Yt-1 + Yt) ÷ k

式中,Ȳt 为对时间序列的 Yt 预测结果,k 为移动间隔(1 < k < t)。

对于 t + 1 期的简单移动平均预测值为:

Ft+1 = Ȳt = (Yt-k+1 + Yt-k+2 + … + Yt-1 + Yt) ÷ k

例如,根据表 27-6 中 2007 到 2025 年某国居民消费价格指数数据,应用移动平均法,选取

教材 P244

移动间隔 k = 3,计算各期居民消费价格指数的预测值,并对 2026 年居民消费价格指数进行预测。

表 27-6 应用移动平均法预测居民消费价格指数

年份居民消费价格指数3 期移动平均预测值预测误差
2007101.8无无
2008101.5无无
2009104.8无无
2010105.9102.7−3.2
201199.3104.14.8
2012103.3103.30.0
2013105.4102.8−2.6
2014102.6102.70.1
2015102.6103.81.2
2016102103.51.5
2017101.4102.41.0
2018102102.00.0
2019101.6101.80.2
2020102.1101.7−0.4
2021102.9101.9−1.0
2022102.5102.2−0.3
2023100.9102.51.6
2024102102.10.1
2025100.2101.81.6
2026无101.0无

以 3 项移动平均(k = 3)为例,表 27-6 中的 102.7 就是 2007 年、2008 年和 2009 年 3 年的平均值,用来作为 2010 年的预测值。同样地,101.0 就是 2023 年、2024 年和 2025 年 3 年的平均值,用来作为 2026 年的预测值。

(二)指数平滑法

指数平滑法是利用过去时间序列值的加权平均数作为预测值,即使得第 t + 1 期的预测值等于第 t 期的实际观察值与第 t 期预测值的加权平均值。这种方法的特点是,观测值离预测时期越久远,其权重也变得越小,呈现出指数下降,因而称为指数平滑。其基本计算公式为:

教材 P245

Ft+1 = αYt + (1 − α)Ft

式中,Ft+1 和 Ft 分别为第 t + 1 期和第 t 期的指数平滑预测值;Yt 为第 t 期的实际观察值;α 为平滑系数(即权重),取值范围为 0 < α < 1。

由于在开始计算时,没有第 1 期的预测值 F1,一般可以设 F1 为第 1 期的实际观察值,即 F1 = Y1,则第 2 期的预测值为:

F2 = αY1 + (1 − α)F1 = αY1 + (1 − α)Y1 = Y1

第 3 期的预测值为:

F3 = αY2 + (1 − α)F2 = αY2 + (1 − α)Y1

第 4 期的预测值为:

F4 = αY3 + (1 − α)F3 = αY3 + (1 − α)αY2 + (1 − α)²Y1

以此类推。

表 27-7 还是利用 2007 到 2025 年某国居民消费价格指数数据,应用指数平滑法,选取平滑系数 α = 0.8,计算各期居民消费价格指数的预测值,并对 2026 年居民消费价格指数进行预测。

表 27-7 应用指数平滑法预测居民消费价格指数

年份居民消费价格指数指数平滑预测值 α = 0.8预测误差
2007101.8无无
2008101.5101.80.3
2009104.8101.6−3.2
2010105.9104.2−1.7
201199.3105.66.3
2012103.3100.6−2.7
2013105.4102.8−2.6
2014102.6104.92.3
2015102.6103.10.5
2016102102.70.7
2017101.4102.10.7
2018102101.5−0.5
2019101.6101.90.3
2020102.1101.7−0.4
2021102.9102.0−0.9
2022102.5102.70.2
2023100.9102.51.6
教材 P246
年份居民消费价格指数指数平滑预测值 α = 0.8预测误差
2024102101.2−0.8
2025100.2101.81.6
2026无100.5无

表 27-7 是用 α = 0.8 对各期居民消费价格指数进行指数平滑预测的结果,并给出了预测误差和 2026 年的预测值:

F2026 = 0.8 × Y2025 + 0.2 × F2025 = 0.8 × 100.2 + 0.2 × 101.8 = 100.5

3必背

这些是必须背下来的。先遮住右边一列,看左边考点名,自己说出内容,说不出来的做记号。

经济基础 第27章 时间序列分析 必背

红 ★★★ 必考

本章没有 ★★★ 考点。重心全在 ★★ 的速度分析,计算题基本从那里出。

黄 ★★ 重点

考点必背内容
发展速度报告期水平 ÷ 基期水平,表明报告期发展到基期的几分之几或若干倍
定基发展速度ai = yi ÷ y0,基期固定为最初水平
环比发展速度bi = yi ÷ yi-1,基期是前一期
定基与环比的关系定基发展速度 = 各环比发展速度连乘;相邻两期定基发展速度之比 = 环比发展速度
增长速度增长量 ÷ 基期水平 = 发展速度 − 1
定基增长速度Ai = (yi − y0) ÷ y0 = ai − 1,用累计增长量
环比增长速度Bi = (yi − yi-1) ÷ yi-1 = bi − 1,用逐期增长量
增长速度不能互推定基增长速度不等于环比增长速度连乘,相邻定基增长速度之比也不等于环比增长速度;要推算必须先加 1 变成发展速度
平均发展速度反映一定时期内逐期发展变化的一般程度;用几何平均法(又叫水平法),原理是总速度 = 各期环比发展速度连乘积
平均发展速度公式b̄ = ⁿ√(b1 × b2 × … × bn) = ⁿ√(yn ÷ y0),n 是环比发展速度的个数
平均增长速度反映一定时期内逐期增长(降低)的一般程度;平均增长速度 = 平均发展速度 − 1,不能直接由环比增长速度算
速度分析注意一指标值出现 0 或负数时,不宜计算速度,直接用绝对数分析
速度分析注意二速度数值与基数大小关系密切,要结合水平指标看
增长 1% 的绝对值逐期增长量 ÷ 环比增长速度 = 前一期水平 ÷ 100

绿 ★ 里会考数字、公式、分类的点

考点必背内容
时间序列含义又叫动态数列,某一统计指标在不同时间上的数值按时间先后排成的序列
时间序列两要素现象所属时间 + 该时间条件下的指标值
时间序列三类型绝对数、相对数、平均数;绝对数序列再分时期序列(过程总量,如 GDP)和时点序列(瞬间水平,如年底人口)
发展水平序列里对应具体时间的指标数值;y0 最初水平,yn 最末水平,中间的是中间水平;按作用分基期水平、报告期水平
平均发展水平又叫序时平均数、动态平均数
时期序列序时平均数ȳ = Σyi ÷ n,简单算术平均
连续时点,逐日登记ȳ = Σyi ÷ n,同时期序列
连续时点,变动才登记ȳ = Σyifi ÷ Σfi,持续天数 fi 作权数
间断时点,间隔相等ȳ = [(y1 + y2) ÷ 2 + (y2 + y3) ÷ 2 + … + (yn-1 + yn) ÷ 2] ÷ (n − 1),「首尾折半,两次平均」,分母是 n − 1
间断时点,间隔不等先首尾折半,再用间隔长度 fi 作权数加权平均
相对数或平均数序列序时平均数ȳ = ā ÷ b̄,分子分母各自算序时平均再相除,绝不能拿相对数直接平均
增长量报告期水平 − 基期水平;逐期增长量 = yi − yi-1,累计增长量 = yi − y0
增长量关系累计增长量 = 相应各逐期增长量之和
平均增长量逐期增长量的序时平均数 = 逐期增长量之和 ÷ 逐期增长量个数 = (yn − y0) ÷ (项数 − 1)
时间序列四成分T 长期趋势(持续上升或下降)、S 季节变动(一年内重复的周期波动)、C 循环波动(非固定长度的周期变动)、I 不规则波动(剩下的随机波动)
分解模型加法模型 Y = T + S + C + I;乘法模型 Y = T × S × C × I
预测四步确定成分、找预测方法、评估方法定最佳方案、用最佳方案预测
平滑法目的:消除不规则成分引起的随机波动;适用:平稳序列(无明显趋势、循环、季节波动);特点:简单易用、对数据要求最低、近期(下一期)预测精度高
移动平均法最近 k 期的平均数当下一期预测值:Ft+1 = (Yt-k+1 + … + Yt) ÷ k,1 < k < t
指数平滑法Ft+1 = αYt + (1 − α)Ft,0 < α < 1;越久远的观测值权重越小,呈指数下降;F1 = Y1

数字与公式清单

  • 发展速度 = 报告期 ÷ 基期;增长速度 = 发展速度 − 1
  • 定基发展速度 = 环比发展速度连乘;相邻定基发展速度之比 = 环比发展速度
  • 平均发展速度 b̄ = ⁿ√(yn ÷ y0),n = 环比速度个数 = 数据个数 − 1
  • 平均增长速度 = 平均发展速度 − 1
  • 增长 1% 的绝对值 = 前一期水平 ÷ 100
  • 间隔相等间断时点序时平均:首尾折半,分母 n − 1
  • 平均增长量 = (yn − y0) ÷ (项数 − 1)
  • 相对数序列序时平均 = ā ÷ b̄
  • 移动平均 k 期:1 < k < t
  • 指数平滑 α:0 < α < 1,Ft+1 = αYt + (1 − α)Ft
  • 教材例题:α = 0.8,F2026 = 0.8 × 100.2 + 0.2 × 101.8 = 100.5
  • 教材例题:2018 到 2024 年能源生产量平均发展速度 = ⁶√(191.3 ÷ 99.38) ≈ 111.53%,平均增长速度 11.53%

4总结

一页纸看完整章。二轮快刷和考前只看这里和必背。

经济基础 第27章 时间序列分析 一页纸总结

本章一句话

把一个指标按时间排成一串(时间序列),然后从三个角度看它:水平怎么样(平均是多少、涨了多少)、速度怎么样(涨了百分之几、平均每年涨多快)、以后会怎么样(拆成趋势季节循环随机四种成分,再用移动平均或指数平滑预测下一期)。全章就是「排、算、测」三个字。

章末总览表

考点星级一句话要点考法
考点一 时间序列★两要素(时间 + 指标值);三类型(绝对、相对、平均);绝对数再分时期序列(总量可加,如 GDP)和时点序列(瞬间存量,如年底人口)单选(判断某指标属于哪类序列)、多选
考点二 时间序列的水平分析★发展水平(最初、最末、中间;基期、报告期);序时平均数按序列类型分五种算法,间断时点「首尾折半」是重点;增长量分逐期、累计;平均增长量 = (yn − y0) ÷ (项数 − 1)单选、计算(间断时点序时平均数、平均增长量)
考点三 时间序列的速度分析★★发展速度 = 报告期 ÷ 基期,增长速度 = 发展速度 − 1;定基与环比发展速度可互推(连乘、相除),增长速度不能;平均发展速度用几何平均 ⁿ√(yn ÷ y0),平均增长速度 = 平均发展速度 − 1;指标有 0 或负数不算速度;增长 1% 的绝对值 = 前一期水平 ÷ 100单选、多选、计算(本章计算题的主战场)
考点四 时间序列的分解和预测程序★四成分 TSCI:趋势、季节(一年内固定周期)、循环(周期不固定)、不规则;预测四步:定成分、选方法、评方法、做预测单选、多选(成分辨认、步骤排序)
考点五 平滑预测法★目的消除随机波动,只适用于平稳序列,近期预测精度高;移动平均 = 最近 k 期平均;指数平滑 Ft+1 = αYt + (1 − α)Ft,0 < α < 1单选、计算(给 α 和两个数套公式)

易错坑

  1. 能互相推算的只有「发展速度」:定基 = 环比连乘,相邻定基之比 = 环比。「增长速度」之间既不能连乘也不能相除,要算先加 1 变成发展速度。
  2. 几何平均开几次方看环比发展速度有几个,即数据个数减 1。2018 到 2024 年 7 个数据,开 6 次方。
  3. 间隔相等的间断时点序列,分母是 n − 1(间隔个数),不是 n(时点个数)。平均增长量的分母也是「项数 − 1」。
  4. 相对数或平均数序列的序时平均数,不能把各期比重直接平均,要分子、分母各算序时平均再相除。
  5. 季节变动和循环波动的区别在周期是否固定:一年内重复的是季节变动,长短不一的(如经济周期)是循环波动。平滑法只能用于没有趋势、循环、季节的平稳序列。

和前后章的关系

本章是统计部分(第 23 到 27 章)的最后一章。第 24 章讲了平均数(算术平均、几何平均)和第 25 章的抽样、第 26 章的回归,都是在「一批数据」上做文章;本章把数据按时间排开,序时平均数就是算术平均和加权平均的变形,平均发展速度就是几何平均数的应用。学完本章统计部分结束,第 28 章起进入会计部分(会计概论),思路完全换轨,本章的公式记牢就能收官。

5解读(读透版讲义)

哪里没看懂,来这里看大白话讲解。生活例子、考法、坑都在这。可以先读这个再回去读教材。

时间序列分析(教材原文·OCR)

文字为主,公式/图表以教材扫描为准。配套精华看复习网页。

第二十七章 “时间序列分析

一时间序列及其分类

社会经济现象总是随着时间的推移而变化,呈现动态性。统计对社会经济现象的研究 ,不
仅要从静态上揭示研究对象在具体时间、地点,条件下的数量特征和数量关系,而且要从动态
上反映其发展变化过程及规律性。统计对事物进行动态研究的基本方法是编制时间序列。

时间序列也称动态数列,是将某一统计指标在各个不同时间上的数值按时间先后顺序纺
制形成的序列。表 27-1 列举了我国 2017一2023 年若干国民经济指标资料。

表 27-1 我国 2017一2023 年若干国民经济指标
_ 年份
指标
2017 2018 2019 2020 2021 2022 2023
下 847382.9 | 936010.1 | 1005872.4 | 1034867.6 | 1173823.0 | 1234029.4 | 1294271.7
年底总人口数 140011 140541 141008 141212 141260 141175 140967
(万人)
人 二 什 60691 66726 71453 73338 83111 87385 91746
(元/人)
口
拉人人 60.2 61.5 62.7 63.9 64.7 65.2 66.2
力

资料来源:《中国统计年鉴》

从表 27-1 中可以看出,时间序列由两个基本因素构成: 一个是被研究现象所属时间,另
一个是反映该现象在一定时间条件下数量特征的指标值。时间构成要素反映时间单位的不
同,如年.季\月日等。 生生 全 顺序进行排列 ,称为年份时间序列; 若以季 月 日
为序排列,则称为季 月 .日时间序列。同一时间序列中,各指标值的时间单位一般要求相等,
这样在分析研究中无项考虑时间单位不同所造成的差异 时间序列中所排列指标值是具有某
种性质特征的指标的具体数量表现,表中的四个时间序列代表四种不同的指标,它们是划分时
间序列类型的依据。

时间序列按照其构成要素中统计指标值的表现形式,分为绝对数时间序列`.相对数时间序
列和平均数时间序列三种类型。绝对数时间序列是由绝对数指标值按时间先后顺序排列后形
成的序列。依据指标值的时间特点,绝对数时间序列又分为时期序列和时点序列。时期序列
中,每一指标值都反映现象在一段时期内发展的结果,即 “过程总量",如表 27-1 中的国内生
产总值是当年各月国内生产总值相加的结果。时点序列中,每一指标值都反映现象在一定时
点上的瞬间水平,如年底总人口数表明在各年年末时点上的人口数。由绝对数时间序列可以
派生出相对数时间序列和平均数时间序列。它们是由同类相对数或平均数指标值按时间先后

236 , 经济基础知识《中级)

顺序排列后形成的序列。表 27-1 中 ,城镇人口比重是相对数时间序列,人均国内生产总值则
是平均数时间序列。

二时间序列的水平分析

( 一)发展水平
发展水平是时间序列中对应于具体时间的指标数值。也就是说,在绝对数时间序列中,发
展水平就是绝对数; 在相对数和平均数时间序列中 ,发展水平表现为相对数或平均数。
设时间序列以m, 和,7,…,思表示,序列中第一项的指标值 y% 为最初水平,最末项的
指标值y 为最末水平,处于两者之间的各期指标值(y,入,…,》- )则为中间水平。根据
各期指标值在计算动态分析指标时的作用来划分,又可以分为基期水平和报告期水平。基
期水平是作为对比的基础时期的水平,报告期水平则是所要反映与研究的那一时期的水
平。
( 二 )平均发展水平
平均发展水平也称序时平均数或动态平均数,是根据时间序列中各时期发展水平计算的
平均数,它可以概括性描述现象在一段时期内所达到的一般水平。时间序列类型不同 ,计算方
法也不同。

  1. 绝对数时间序列序时平均数的计算。

(1 ) 由时期序列计算序时平均数。对于时期序列,序时平均数计算公式为
yi +ya二十 2
用 刀
式中, y, 为各时期的发展水平(六1,2,…,m),m 为时期序列的项数,7为序时平均数。
例如,根据表 27-1 中的国内生产总值时间序列,计算各年度的平均国内生产总值。
密

加 人
=于 ]2 十yn 一 本 一 7526257.1 ~ 1075179.6(亿元)

用

我国 2017一2023 年平均国内生产总值为 1075179.6 亿元。

(2 )由时点序列计算序时平均数。时点序列的指标值反映现象在某一时点上的瞬间水
平,要正确计算其平均数,从理论上说,应当掌握每一时点上的指标值,然后计算平均单位时点
的指标数值。在社会经济统计中一般是将一天看作一个时点,即以“天”作为最小时间单位。
这样便有连续时点序列和间断时点序列的区分。资料逐日登记的是连续时点序列; 资料不是
逐日登记,而是间隔较长一段时间 ( 月 、.季或年 )后再登记一次,然后依序排列的是间断时点序
列。这两种时点序列的类型不同 ,计算序时平均数的方法也有所不同。

第一种情况,由连续时点计算,又分为两种情形。

一种情形是资料逐日登记且逐日排列,即已掌握了整段考察时期内连续性的时点数据,可

7y=

力二因+ 二 妆2
也 也

式中, y; 为各时点的指标值 (二1,2,.…,m ),m 为时点个数,7为序时平均数。

7 =

第二十毛章“时间序列分析 ,237,
另一种情形是资料登记的时间单位仍然是 1 天,但实际上只在指标值发生变动时才记录
一次。此时需采用加权算术平均数的方法计算序时平均数,权数是每一指标值的持续天数,计

过yi

了-=站 +入户+人十为大 _ ial
AP
之/
21

式中,y 为各时点的指标值 (=1,2,…,m),太(=1,2, … ,7 ) 为指标值的持续天数。
例: 某种商品 6 月份的库存量记录见表 27-2。

表 27-2 某种商品 6 月份的库存量记录
日期 1一4 5一7 8一13 14一20 21一23 24一28 29一30
库存量(台 ) 49 52 39 29 43 38 51

该商品 6 月份的平均日库存量为:
-_ 49x4+52x3+39x6+29x7+43x3+38x5+5lx2
4+3+6+7+3+5+2

第二种情况,由间晰时点计算,又分为两种情形。
一种情形是每隔一定的时间登记一次,每次登记的间隔相等。间隔相等的间断时点序列
序时平均数的计算公式为:

=40(台)

yi +y ya +]3 加-1 十和
2 2 7
了一 刀.一1
式中,y 为各时点的指标值( 过1,2,'…,),m 为时点个数,7为序时平均数。
由上式可见,间隔相等的间断时点序列序时平均数的计算思路是“两次平均”: 先求各个
时间间隔内的平均数,再对这些平均数进行简单算术平均。
另一种情形是每隔一定的时间登记一次,每次登记的间隔不相等。间隔不相等的间断时
点序列序时平均数的计算公式为:
1 二2 》2 十 3 -1 十yn
+
之
间隔不相等的间断时点序列序时平均数的计算也采用“两次平均”的思路,且第一次的平
均计算与间隔相等的间断序列相同; 进行第二次平均时,由于各间隔不相等,所以应当用间隔
长度作为权数,计算加权算术平均数。
例: 根据表 27-3 计算某国 2011一2023 年平均每年第三产业从业人员数。

7=

表 27-3 某国 2011一2023 年第三产业从业人员数( 年底数 )
年份 2011 2014 2016 2019 2021 2023
第三产业
从业人员数 27185 30920 33042 35561 35868 35639
(万人) 、

,238 , 经济基础知识(中级)

27185+30920 30920+33042 33042+35561 35561+35868 35868+35639
阅 X3+ 7 X2+ 7 X3+ 2 X2+ 2 X

3+2+3+2+2

2

7=

=33080(万人)

  1. 相对数或平均数时间序列序时平均数的计算。相对数或平均数时间序列是派生数列,

相对数或平均数通常是由两个绝对数对比形成的。要计算相对数或平均数时间序列的序时平
均数,不能就序列中的相对数或平均数直接进行平均计算; 而必须分别求出分子指标和分母指
标时间序列的序时平均数,然后再进行对比。用公式表示:

7=三
站
式中,7为相对数或平均数时间序列的序时平均数,z 为分子指标时间序列的序时平均数,2 为
分母指标时间序列的序时平均数。
例: 根据表 27-4 计算某国 2018一2023 年第三产业从业人员数占总从业人员数比重的年

表 27-4 某国 2018一2023 年从业人员数( 年底数 )
年份 2018 2019 2020 2021 2022 2023
总从业人员数(万人) 75782 75447 75064 74652 73351 74041
第三产业从业人员数 34911 3556lzf|l。 35806 35868 34583 35639
(万人)
第三产业从业人员数占总
46.07 47.13 47.70 48.05 47.15 48.13
从业人员数比重(%)
34911+35561 35561+35806 ,35806+35868 |, 35868+34583 ,34583+35639
和 2 2 2 2 2
帮 5
=35418.6(万人)
75782+75447 , 75447+75064 , 75064+74652 ,74652+73351 | 73351+74041
三 - 2 2 2 包 2
5
= 74685.1(万人)

35418.6 关
5685了X 100% 一 47.4%

了
该国 2018一2023 年第三产业从业人员数占总从业人员数比重的年平均数为 47.4%。

( 三 )增长量与平均增长量

1.增长量。增长量是报告期发展水平与基期发展水平之差,反映报告期比基期增加(减
少 )的绝对数量。计算公式为:

增长量 = 报告期水平 - 基期水平
根据基期的不同确定方法,增长量可分为逐期增长量和累计增长量。
(1 )逐期增长量。逐期增长量是报告期水平与前一期水平之差,用公式表示为:
4=yryj (ti=12,…,)
它表明现象逐期增加(减少 ) 的绝对数量。当 i=1 时,yo 表示时间序列的最初水平;7 是

第二十毛章“时间序列分析 “239,

研究范围的起始期水平。
(2 ) 累计增长量。累计增长量是报告期水平与某一固定时期水平( 通常是时间序列最初
水平 )之差,用公式表示为:
4=和名 GE=1,2,)
它表明报告期比该固定时期增加( 减少 ) 的绝对数量。
易于看出,同一时间序列中,累计增长量等于相应时期逐期增长量之和,即;

44=和一 nm (7 一yi)
2.平均增长量。平均增长量是时间序列中逐期增长量的序时平均数,它表明现象在一定
时段内平均每期增加(减少 ) 的数量。计算公式为:
Or
4= 一 GE=12和1)
式中,m 表示逐期增长量个数。
根据逐期增长量与累计增长量之间的数量关系,平均增长量还可以用下式表示:

本和二加
4= Ni

式中, 表示时间序列项数。

三时间序列的速度分析

( 一')发展速度与增长速度
1 发展速度。发展速度是以相对数形式表示的两个不同时期发展水平的比值,表明报告
期水平已发展到基期水平的几分之几或若干倍。计算公式为:
、,, 报告期水平
发展速度 = 基期水平
由于基期选择的不同,发展速度有定基与环比之分。定基发展速度是报告期水平与某-
男定时期水平( 通常是最初水平 )的比值,用w 表示,则有:
和
yo
它说明社会经济现象相对于革个基础水平,在一定时期内总的发展速度。
环比发展速度是报告期水平与其前一期水平的比值,用到表示,则有;

= (12,)

昌

(=1)2,…))

Qi

它说明所研究现象相邻两个时期( 逐期 ) 发展变化的程度。
由上式可知,定基发展速度时间序列中,各时期比较的基础固定在一个共同的水平(加 )
上; 环比发展速度时间序列则呈现各时期发展水平交替作为报告期与基期使用的循环对比状
态。两者虽有区别,但也存在着一定的数量依存关系。
第一,定基发展速度等于相应时期内各环比发展速度的连乘积。
思-禾、筷 入

X ,… X
yo yo 入 Jn-1

240 经济基础知误 (中级)

第二,两个相邻时期定基发展速度的比率等于相应时期的环比发展速度。
思

Jo
实际工作中,经常利用上述关系式对发展速度指标进行推算或换算。

  1. 增长速度。增长速度是报告期增长量与基期水平的比值,表明报告期水平比基期增长

(或降低 )了若干倍( 或百分之几 )。 计算公式为:
增长量
境长速度= 全有水下
由于基期选择的不同 ,增长速度也有定基与环比之分。上述计算公式中,若增长量为累计
增长量, 生生 用4表示,就有:
二yo

Jo0
若增长量为逐期增长量,则计算的是环比增长速度,用肪表示,就有:

有=一Ji -5 -1 (012
Ji-1

发展速度与增长速度是对社会经济现象进行动态分析的基本指标,应用中要注意的问题
是:定基增长速度与环比增长速度不能像定基发展速度与环比发展速度那样互相推算 ,因为定
基增长速度不等于相应时期内各环比增长速度的连乘积; 两个相邻时期定基增长速度的比率
也不等于相应时期的环比增长速度。定基增长速度与环比增长速度之间的推算 ,必须通过定
基发展速度和环比发展速度才能进行。

( 二 )平均发展速度与平均增长速度

平均发展速度和平均增长速度是两个非常重要的平均速度指标。前者反映现象在一定时
期内逐期发展变化的一般程度,后者则反映现象在一定时期内逐期增长( 降低 )变化的一般程
度。因此,这两个指标在国民经济管理和统计分析中有广泛的应用,是编制和检查计划的重要
依据,还可以用于一个国家或地区不同阶段发展状况的比较,以及同一时期不同国家或地区发

就计算方法来说,重点是平均发展速度指标。因为平均增长速度既不能由各期的环比增
长速度求得,也不能根据一定时期的总增长速度计算 ,平均增长速度是通过它与平均发展速度
之间的数量关系求得的:

二= =a -1 (=12

平均增长速度 = 平均发展速度 -1
由于平均发展速度是一定时期内各期环比发展速度的序时平均数,各时期对比的基础不
同,所以不能采用一般序时平均数的计算方法。目前,计算平均发展速度通常采用几何平均
法,几何平均法也称水平法。采用这一方法的原理是,一定时期内现象发展的总速度等于各期
环比发展速度的连乘积。根据平均数的计算原理,应当按连乘法,即几何平均数公式计算各指
标值的平均数。

卫=半x卫xx二xx太x: “xb=了5

yo Jo 妨 Jn-1 =1
式中,IT为连乘号,上 为环比发展速度,m 为环比发展速度的时期数,则:

第二十毛章“时间序列分析 “2471,

5- JI 考 天
式中,5为平均发展吉度。

上述两式都是平均发展速度几何平均法的计算公式,可以根据资料的掌握情况选择应用。

( 三 )速度的分析与应用

在应用速度分析实际问题时 ,须防止误用乃至滥用的现象,应注意:

  1. 当时间序列中的指标值出现 0 或负数时,不宜计算速度。例如,假定某企业连续 5 年的

利润额分别为 5 万元,2 万元,0, -3 万元,2 万元,对这一序列计算速度,要么不符合数学公理,
要么无法解释其实际意义。在这种情况下 ,适宜直接用绝对数进行分析。

  1. 速度指标的数值与基数的大小有密切关系。在环比增长速度时间序列中,各期的基数

不同,因此,运用这一指标反映现象增长的快慢时,往往要结合水平指标的分析才能得出正确
结论-“增长 19 的绝对值” 是进行这一分析的指标。它反映同样的增长速度 ,在不同时间条
件下所包含的绝对水平。计算公式为:

增长 1% 的绝对值 =

逐期增长量

环比增长速度

用符号表示为:

曙 yo Ia
增长 1% 的绝对值 = FE =100

100

环比增长速度是相对数,一般用百分数表示。上式推导中分母指标乘以 100,就将它还原
为绝对数,这样才能与分子指标对比计算。

例如,某市 2018一2024 年能源生产量列于表 27-5 ,根据这些资料计算的发展速度.增长

速度及增长 19 的绝对值也列于该表中。

表 27-5 某市 2018一2024 年能源生产量及速度指标
年份 2018 2019 2020 2021 2022 2023 2024
发展水平
的 99.38 152.31 160 149.79 | 19077 | 187.57 191.3
(万吨标准煤 )
、 定 100 153.26 150.72 | 191.96 | 188.74 | 192.49
发展速度
(% )
环比 一 153.26 127.36 | 98.32 | 101.99
一 53.26 61.00 50.72 91.96 88.74 92.49
增长速度 人
人 环比 一 53.26 5.05 -6.38 27.36 -1.68 1.99
增长 19 的绝对值
_ 一 0.99 1.52 1.60 1.50 1.91 1.88
(万吨标准煤 )

(1 ) 由表中资料可以验证定基发展速度与环比发展速度之间的数量依存关系。
192.499%6=153.2696 x 105.0596 x 93.6295 x 127.3695 x 98.3296 x 101.9996

“242 , 经济基础知识 (中级)

即 2024 年与 2018 年的定基发展速度等于这一时期各年环比发展速度的乘积。又如;
101.9996=192.49% 188.74%
即 2024 年与 2023 年的环比发展速度等于这两年定基发展速度的比率。

(2 )由表中资料可以看到, 2022 年能源生产量的环比增长速度是 27.36% ,大于 2024 年的
1.999% ,但是 2022 年能源生产量每增加 1% 的生产绝对量为 1.50 万吨标准煤,却低于 2024 年
的 1.88 万吨标准煤,可见, 2024 年该市的能源发展水平并不比 2022 年差,反而更好。

〈3 )用几何平均法计算该市 2018一2024 年能源生产量平均发展速度和平均增长速度。

5= | II 六 = V153.26%X105.05驳X93.6795X177.36% 又98.37%X1019970 = 192.509%6
=1

一111.33%

严 6
或 万= 鱼=- /213 -9T9545 ~ 111.53%
太一/9938

平均增长速度 =5 -1=111.53% - 1 = 11.53%

山

四,时间序列的分解和预测程序

时间序列的变化可能受一种或几种因素的影响,这种因素称为时间序列的成分。时间序
列的成分通常有长期趋势(T入季节变动( S)循环波动( C ) 和不规则波动( IT)等四种。

长期趋势CT )是时间序列在较长一段时间内呈现的持续上升或持续下降的变动。这种趋
势可能是线性的,也可能是非线性的。

季节变动($ )是时间序列在一年内重复出现的周期性波动。例如,旅游.商品销售 .农业
生产 ,交通运输等行业的生产经营中都有明显的季节变动特征。

循环波动( C )是时间序列呈现出的非固定长度的周期性变动。例如,经济周期有涨落相
间的交替波动,周期长短不一,无固定规律。

不规则波动(I)是时间序列中除去长期趋势.季节变动和循环波动之后的随机波动。不
规则波动往往是由一些偶然因素引起的,难以预测和控制,因此在时间序列预测中通常不子单

一个时间序列可能只包含一种成分,也可能是由几种成分混合而成的( 见图 27-1 )。时间
序列分析时经常在一定的模型假定下把这些成分从时间序列里分离出来,对各成分分别进行
分析。不同的模型中对四种成分之间的关系假定不同 ,如加法模型中假定也=T+S+CA+H1,乘法
模型中假定忒=T, x 3 x C,x1s

时间序列分析的一个主要目的就是根据历史数据对未来进行预测。时间序列的预测通常
包括以下几个步又:

第一步: 确定时间序列所包含的成分;

第二步: 找出适合该时间序列的预测方法;

第三步: 对可能的预测方法进行评估,以确定最佳预测方案;

第四步: 利用最佳预测方案进行预测 。

第二十毛章 “时间序列分析 ,243

700 600
600] 500]
500]
|
油 400]| 钢
关 300]j
300
200
200
100
INRRRRNRSRNTPY SNKRRRSRNRSRNRDPY
SRSRSRSRSRSRSNYSRSDSYCSSY SENRYSRSRSRSYSRSYSRSSSY
个人人个个下个个个个个 人人个个个个
a) b)
1.4 1.06
1.3]] 1.04]
1.2] 10
中 11] 同
四 才 加
当 10 倒 L00
号
四 0.9 必 098
0.8] 0.96
0.7]
0.94
天生生二下下下SR NOkaeASSavdpay
NANANANRNRNANANRSRDSYAAAS NAN
个个信人人人下个个个个下个个个 少个个人人个人个个个人个个个少
C

图 27-1 含有不同成分的时间序列
a ) 有趋势的时间序列图 b )有趋势和季节性的时间序列图
c )有周期变动的时间序列图 d )不规则波动的时间序列图

五、平滑预测法

平滑法的目的就是“消除”时间序列的不规则成分所引起的随机波动,所以被称为平滑
法,包括移动平均法和指数平滑法等。平滑法适用于平稳时间序列的预测,即没有明显的趋
势.循环和季节波动的时间序列。平滑法简单易用,对数据的要求最低,通常对于近期(如下
一期 ) 的预测具有较高的精度。

( 一 )移动平均法

移动平均法使用时间数列中最近上期数据值的平均数作为下一期的预测值,其计算公式

了 =- 也-hi二+也-taT 十闷十了
天

式中, 为对时间序列的也预测结果 ,为移动间隔(1 一大一上)。

对于 i+1!1 期的简单移动平均预测值为:
了 卫-i+了-ta+ 十世 +了
RE二 和

例如,根据表 27-6 中 2007一2025 年某国居民消费价格指数数据,应用移动平均法,选取

244 , 经济基础知识(中级)

移动间隔 i=3,计算各期居民消费价格指数的预测值,并对 2026 年居民消费价格指数进行预

测。
表 27-6 应用移动平均法预测居民消费价格指数
年份 居民消费价格指数 3 期移动平均预测值 预测误差
2007 101.8 一 至
2008 101.5 一 一
2009 104.8 一 一
2010 105.9 -3.2
2011 99.3 104.1 4.8
2012 103.3 10343 0.0
2013 105.4 102.8 -2.6
2014 102.6 102.7 041
2015 102.6 103.8 1.2
2016 102 103.5 1.5
2017 101.4 102.4 1.0
2018 102 102.0 0.0
2019 101.6 101.8 02
2020 102.1 101.7 -04
2021 102.9 101.9 -10
2022 102.5 102.2 -03
2023 100.9 102.5 1.6
2024 102 102.1 041
2025 100.2 101.8 1.6
2026 一 到

以3 项移动平均(ji=3 )为例,表 27-6 中的 102.7 就是2007年.2008年和2009年3年的
平均值,用来作为 2010 年的预测值。同样地, 101.0 就是 2023 年.2024 年和 2025 年 3 年的平
均值,用来作为 2026 年的预测值。

( 二 )指数平滑法

指数平滑法是利用过去时间序列值的加权平均数作为预测值,即使得第 t+l 期的预测
值等于第:期的实际观察值与第;期预测值的加权平均值。这种方法的特点是,观测值离
预测时期越久远,其权重也变得越小,呈现出指数下降,因而称为指数平滑。其基本计算公

第二十毛章“时间序列分析 245,

玉=ay+(1-a )忆

式中, Pi 和瓦分别为第 1 期和第:期的指数平滑预测值;也 为第 : 期的实际观察值; w 为平
滑系数( 即权重 ),取值范围为0< ac < 1。

由于在开始计算时,没有第 1 期的预测值 玉,一般可以设 太 为第 1 期的实际观察值,即
局=闷,则第 2 期的预测值为:

矶=a8+(1-a)有=a+(C1-a )态=蕊

第 3 期的预测值为:

下=aJD+(1-a )忆=awJ+(C1-a )蕊

第 4 期的预测值为:

尺=ayJ+(1-a)太=aZ+(l-a )aJ+(1-a ) 了

表 27-7 还是利用 2007一2025 年某国居民消费价格指数数据,应用指数平滑法 ,选取平
滑系数 w“=0.8,计算各期居民消费价格指数的预测值,并对 2026 年居民消费价格指数进行预

测。
表27_7 应用指数平滑法预测居民消费价格指数
年从 居民消费价格指数 消烙消枯和人 预测误差
2007 101.8 Po Se
2008 101.5 101.8 0.3
2009 104.8 101.6 -3.2
2010 105.9 104.2 一1.7
2011 99.3 105.6 6.3
2012 103.3 100.6 一2.7
2013 105.4 102.8 -2.6
2014 102.6 104.9 2.3
2015 102.6 103.1 0.5
2016 102 102.7 0.7
2017 101.4 102.1 0.7
2018 102 101.5 -0.5
2019 101.6 101.9 0.3
2020 102.1 101.7 -0.4
2021 102.9 102.0 -0.9
2022 102.5 102.7 0.2
2023 100.9 102.5 1.6

246 ”经济基础知误 (中级)
年从 居民消费价格指数 于 兴扣人 预测误差
2024 102 101.2 -0.8
2025 100.2 101.8 1.6
2026 一 100.5 一

表 27-7 是用w“=0.8 对各期居民消费价格指数进行指数平滑预测的结果,并给出了预测
误差和 2026 年的预测值:
Po6=08xZos+02xPos=08x1002+02x101.8=100.5


零基础复习卡(两版教材核验)

来源核验:主教材《2026经济基础知识中级原书有色差(371)》PDF 第247-257页;《经济基础知识(中级)-292》PDF 第194-199页(书内第186-191页)。

一句话先懂

时间序列就是把同一指标按时间排队:先看水平,再看增长,再识别趋势、季节、循环和随机波动,最后做短期预测。

零基础解释

  1. 三类序列:绝对数序列记录规模,又分时期序列和时点序列;相对数序列记录比率;平均数序列记录平均水平。
  2. 时期与时点:时期指标可累加,如全年产量;时点指标是某一瞬间存量,通常不能直接累加,如年末人口、月末存款。
  3. 增长量:逐期增长量=`报告期-前一期`;累计增长量=`报告期-固定基期`;相应累计增长量等于各逐期增长量之和。
  4. 速度:发展速度=`报告期水平/基期水平`;增长速度=`发展速度-1`。定基速度以固定期为基期,环比速度以前一期为基期。
  5. 平均速度:平均发展速度采用几何平均;平均增长速度=`平均发展速度-1`,不能直接把各期增长速度算术平均。
  6. 序列成分:长期趋势T、季节变动S、循环波动C、不规则波动I。
  7. 平滑预测:移动平均用最近若干期的平均预测下一期;指数平滑给近期数据更大权重,`α`越大越重视最新实际值。

必背清单

  • 时期序列各期数值可相加,大小受时期长短影响。
  • 时点序列各期数值通常不可相加,大小与时间间隔长短无直接关系。
  • 定基发展速度等于相应环比发展速度连乘积。
  • 平均增长量=`累计增长量/逐期增长量个数`。
  • 增长1%的绝对值=`前期水平/100`,用来防止“速度快但增量小”的错觉。
  • 指标值出现0或负数时,不宜计算速度。
  • 平滑法适合没有明显趋势、循环和季节波动的平稳序列,通常用于近期预测。

易混点

  • 发展速度与增长速度差1:发展速度120%,增长速度20%。
  • 平均增长速度不能平均各增长率,先算几何平均发展速度再减1。
  • 季节变动是一年内重复;循环波动周期长度不固定,常跨多年。
  • α越大越灵敏,预测更追随最新数据;α越小越平滑。

记忆口诀

  • “时期开一段能相加,时点截一刻不相加”。
  • “定比固、环比前;发展除,增长减;平均速度几何连”。
  • 四成分:“趋季循随”(趋势、季节、循环、随机)。

自测题

  1. 单选:年末银行存款余额形成的时间序列属于( )。A时期绝对数 B时点绝对数 C相对数 D平均数

答案:B。 余额反映特定时点的存量。

  1. 计算:某指标由100增至120,发展速度和增长速度分别是多少?

答案:120%、20%。 `120/100=120%`,再减1得20%。

  1. 判断:三年增长速度分别10%、20%、30%,平均增长速度一定等于20%。

答案:错。 应计算几何平均发展速度后减1。

  1. 单选:每年春节前后重复出现的客运高峰属于( )。A长期趋势 B季节变动 C循环波动 D完全随机

答案:B。 在一年内按季节或日历重复。

  1. 判断:指数平滑系数α越大,最新实际值对下一期预测的影响越大。

答案:对。 α表示本期实际值的权重。

  1. 简答:为什么还要看“增长1%的绝对值”?

答案: 增长速度受基数影响,同样1%的增长在不同基数下对应的绝对增量不同;该指标把速度与规模联系起来。

6刷题(章节配套练习,含校订与教学改编)

先做后看答案。单选点一下就判,多选选完点「核对答案」。错题自动进错题本,二轮会回来重做。

1. 单项选择题
将某一统计指标在各个不同时间上的数值按时间先后顺序编制形成的 序列是()。
A. 指数序列B. 静态序列C. 时间序列D. 发展水平
答案 C 本题考查时间序列的概念。时间序列也称动态数列,是将某一统计指标在各个不同 时间上的数值按时间先后顺序编制形成的序列。
2. 单项选择题
以下关于时间序列的说法,错误的是()。
A. 对存在周期变化的数据,采用时间序列模型进行描述是比较合适的B. 对随时间推移而逐渐增长或衰减的数据,采用时间序列模型进行描述比较合适C. 时间序列分析可在一定模型假设下分离趋势、季节等成分D. 无法利用时间序列模型进行预测
答案 D 时间序列模型的一个重要应用就是对时序数据进行预测。

校勘说明:为明确期间、计算口径或预测方法适用条件所作的校订后教学题设,不冒充原题原文。

3. 单项选择题
“年底总人口数”指标的时间序列属于()。
A. 时点序列B. 平均数时间序列C. 相对数时间序列D. 时期序列
答案 A 时间序列按照其构成要素中统计指标值的表现形式,分绝对数时间序列、相对数 时间序列、平均数时间序列三种类型。依据指标值的时间特点,绝对数时间序列又分为时期序 列和时点序列。其中,时点序列是指每一指标值反映现象在一定时点上的瞬间水平,如年底总 人口数是说明在各年年末这一时点上的人口数。
4. 单项选择题
每一个指标值反映经济现象在一段时间内发展的结果,指的是()。
A. 时点序列B. 平均数时间序列C. 相对数时间序列D. 时期序列
答案 D 时期序列是指每一个指标值反映现象在一段时间内发展的结果,即“过程总量”。
5. 单项选择题
将各年全年商品房销售面积按年份依次排列,该时间序列属于()。
A. 平均数时间序列B. 相对数时间序列C. 时期序列D. 时点序列
答案 C 全年商品房销售面积反映一定时期成交面积的过程总量,属于时期序列,选C。

校勘说明:为明确期间、计算口径或预测方法适用条件所作的校订后教学题设,不冒充原题原文。

6. 单项选择题
将某国各年年末私营单位就业人数按年份依次排列,该序列属于()。
A. 平均数时间序列B. 相对数时间序列C. 时期序列D. 时点序列
答案 D 年末就业人数反映特定时点的存量水平,属于时点序列,故选D。

校勘说明:为明确期间、计算口径或预测方法适用条件所作的校订后教学题设,不冒充原题原文。

7. 单项选择题
“进出口总额”指标的时间序列属于()。
A. 平均数时间序列B. 相对数时间序列C. 时期序列D. 时点序列
答案 C 时间序列按照其构成要素中统计指标值的表现形式,分为绝对数时间序列、相对数 时间序列和平均数时间序列三种类型。绝对数时间序列是由绝对数指标值按时间先后顺序排 列后形成的序列。根据指标值的时间特点,绝对数时间序列又分为时期序列和时点序列。时 期序列中,每一指标值反映现象在一段时期内发展的结果,即“过程总量”
8. 单项选择题
“城镇人口比重”指标的时间序列属于()。
A. 时点序列B. 平均数时间序列C. 相对数时间序列D. 时期序列
答案 C 由绝对数时间序列可以派生出相对数和平均数时间序列。它们是由同类相对数或 平均数指标按时间先后顺序排列后形成的序列。城镇人口比重是相对数时间序列。
9. 单项选择题
2019—2025年期间,某国制造业城镇单位就业人员平均工资的时间序列 如下: 年份 2019年2020年2021年2022年2023年2024年2025年 制造业城镇单位就业人员平均工资(元) 36665 41650 46431 51369 55324 59470 64452 按照时间序列的分类,该时间序列属于()。
A. 时期序列B. 时点序列C. 相对数时间序列D. 平均数时间序列
答案 D 平均数时间序列是平均数指标值按时间先后顺序排列后形成的序列。
10. 多项选择题
按构成要素中统计指标值的表现形式,时间序列可以分为( )。
A. 平均数时间序列B. 发展水平C. 绝对数时间序列D. 相对数时间序列E. 发展速度
答案 ACD 时间序列按构成要素中统计指标值的表现形式分为:绝对数时间序列、相对数 时间序列、平均数时间序列。
11. 单项选择题
某超市2025年9月电视的库存量记录见下表。 日期 1-9日 10—15日 16-27日 28—30日 库存量(台) 50 60 40 50 该商品9月份的平均日库存量是()台。
A. 40B. 45C. 48D. 50
答案 C 按库存保持的天数加权,9月平均库存量=(50×9+60×6+40×12+50×3)/30=48,选C。
12. 单项选择题
某企业本年度前四个月的生产情况见下表。 月份 1月 2月 3月 4月 产值(万元) 44 50 58 64 该企业1月至4月的平均产值为()万元。
A. 44B. 54C. 59D. 66
答案 B 这是时期序列,平均值=(44+50+58+64)/4=54,选B。
13. 单项选择题
某企业3月31日、4月30日、5月31日、6月30日职工人数分别为1400、1500、1460、1420人。按月等间隔时点序列的两次平均法,第二季度平均职工人数约为()。
A. 1410B. 1445C. 1457D. 1460
答案 C 3月31日为第二季度期初时点。第二季度平均职工人数=(1400/2+1500+1460+1420/2)/3≈1457人,选C。

校勘说明:为明确期间、计算口径或预测方法适用条件所作的校订后教学题设,不冒充原题原文。

14. 单项选择题
某行业2017年末、2020年末、2022年末、2025年末职工人数依次为1000、1200、1600、1400万人。按不等间隔时点序列两次平均法,2017年末至2025年末这8年间的平均职工人数为()万人。
A. 1200B. 1300C. 1325D. 1400
答案 C 各段平均为1100、1400、1500,间隔为3、2、3年;加权平均=(1100×3+1400×2+1500×3)/8=1325,选C。

校勘说明:为明确期间、计算口径或预测方法适用条件所作的校订后教学题设,不冒充原题原文。

15. 单项选择题
某时点时间序列是每隔一定时间登记一次数据,且每次登记的间隔不相 等,计算其序时平均数应采用的方法是( )。
A. 简单算术平均数方法B. 加权算术平均数方法C. 先求各个时间间隔内的平均数,再对这些平均数进行加权算术平均D. 几何平均法
答案 C 间隔相等的间断时点序列序时平均数的计算思路是“两次平均”:先求各个时间间 隔内的平均数,再对这些平均数进行简单算术平均。间隔不相等的间断时点序列序时平均数 的计算也采用“两次平均”的思路,且第一次的平均计算与间隔相等的间断序列相同;进行第 二次平均时,由于各间隔不相等,所以应当用间隔长度作为权数,计算加权算术平均数。
16. 多项选择题
下列关于平均发展水平计算的说法,正确的有()。
A. 平均发展水平也称为序时平均数B. 时点序列和时期序列平均发展水平的计算方法不同C. 连续时点序列和间断时点序列平均发展水平计算方法相同D. 间断时点序列平均发展水平的计算采用“两次平均”的思路E. 相对数时间序列的平均发展水平可就序列中的相对数直接进行平均计算
答案 ABD 连续时点序列和间断时点序列的类型不同,计算序时平均数的方法也有所不同, 选项C错误。相对数或平均数时间序列的序时平均数,不能就序列中的相对数或平均数直接 进行平均计算,而必须分别求出分子指标和分母指标时间序列的序时平均数,然后再进行对 比,选项E错误。
17. 多项选择题
下列时间序列分析指标中,适用于水平分析的有()。
A. 增长量B. 平均发展水平C. 发展水平D. 平均增长速度E. 平均增长量
答案 ABCE 时间序列的水平分析指标包括:发展水平、平均发展水平、增长量与平均增长量。
18. 单项选择题
在同一时间序列中,累计增长量与相应时期逐期增长量之间的数量关系 是()。
A. 累计增长量等于相应时期逐期增长量的加权平均数B. 累计增长量等于相应时期逐期增长量之积C. 累计增长量等于相应时期逐期增长量之和除以逐期增长量个数D. 累计增长量等于相应时期逐期增长量之和
答案 D 根据基期的不同确定方法,增长量可以分为逐期增长量和累计增长量。累计增长 量等于相应时期逐期增长量之和。
19. 单项选择题
时间序列中逐期增长量的序时平均数是()。
A. 逐期增长量B. 累计增长量C. 平均增长量D. 平均增长速度
答案 C 平均增长量是逐期增长量的序时平均数。
20. 单项选择题
在对时间序列进行分析计算时,可将增长量分为逐期增长量与累计增长 量,两者的区别是()。
A. 适用的时间序列类型不同B. 计量单位不同C. 基期确定方法不同D. 报告期确定方法不同
答案 C 根据基期的不同确定方法,增长量分为逐期增长量与累计增长量。逐期增长量是报 告期水平与前一期水平之差;累计增长量是报告期水平与某一固定时期水平(通常是时间序 列最初水平)之差。
21. 多项选择题
根据基期的不同确定方法,增长量可分为()。
A. 逐期增长量B. 平均增长量C. 累计增长量D. 定基发展速度E. 环比发展速度
答案 AC 根据基期的不同确定方法,增长量可分为逐期增长量和累计增长量。
22. 多项选择题
下列关于增长量的说法,正确的有()。
A. 增长量是报告期发展水平与基期发展水平之差B. 累计增长量是报告期水平与某一固定时期水平之差C. 逐期增长量是报告期水平与前一期水平之差D. 同一时间序列中,累计增长量等于相应时期内逐期增长量的乘积E. 平均增长量是时间序列中逐期增长量的序时平均数
答案 ABCE 同一时间序列中,累计增长量等于相应时期逐期增长量之和,选项D错误。
23. 单项选择题
在时间序列分析中,两个相邻时期定基发展速度的比率等于相应时期的 ()。
A. 定基增长速度B. 逐期增长量C. 定基发展速度D. 环比发展速度
答案 D 两个相邻时期定基发展速度的比率等于相应时期的环比发展速度。
24. 单项选择题
在时间序列分析中,报告期水平与前一期水平的比值是( )。
A. 环比发展速度B. 累计增长量C. 逐期增长量D. 环比增长速度
答案 A 环比发展速度=报告期水平/前一期水平,故选A。
25. 单项选择题
某国2019—2025 年期间全国财政支出的时间序列如下: 年份 2019年 2020年 2021年 2022年 2023年 2024年 2025年 全国财政支出(亿元) 109247.8 125953 140212.1 151785.6 175877.8 187755.2 203085.5 则2025年与2024年的环比发展速度为()。
A. 108.17%B. 92.45%C. 8.17%D. 8.55%
答案 A 2025年环比发展速度=203085.5/187755.2×100%≈108.17%,选A。
26. 单项选择题
在时间序列的速度分析中,增长速度可以表示为( )。
A. 报告期增长量与基期水平的差B. 发展水平之比C. 报告期增长量与基期水平的比值D. 发展速度+1
答案 C 增长速度是报告期增长量与基期水平的比值。
27. 单项选择题
已知某地区近三年社会消费品零售总额的环比增长速度分别为4%、 6%、9%,则这一时期该地区社会消费品零售总额的定基增长速度为()。
A. 4%×6%×9%B. (4% ×6%×9%)+1C. (104% × 106% × 109%)-1D. 104% × 106% × 109%
答案 C 定基增长速度=(104%× 106% ×109%)-1。
28. 单项选择题
两个相邻时期定基发展速度的比率等于相应时期的()。
A. 环比发展速度B. 环比增长速度C. 定基发展速度D. 定基增长速度
答案 A 两个相邻时期定基发展速度的比率等于相应时期的环比发展速度。
29. 单项选择题
以2019年为基期,2024年和 2025年某国粮食总产量定基增长速度分别 为14.40%和14.85%。则2025年对2024年的环比发展速度为()。
A. 0.39%B. 14.63%C. 100.39%D. 114.63%
答案 C 2025年环比发展速度=(1+14.85%)/(1+14.40%)×100%≈100.39%,选C。
30. 单项选择题
某家庭在2017年的收入为10万元,2025年的收入为36万元,以2017 年为基期,则这个家庭收入的平均发展速度是()。
A. 102%B. 106%C. 115%D. 117%
答案 D 2017年至2025年共8个年度间隔。平均发展速度=(36/10)^(1/8)×100%≈117.36%,最接近117%,选D。
31. 单项选择题
某企业2019-2025年销售收入的年平均增长速度是27.6%,这期间相应 的年平均发展速度是( )。
A. 4.6%B. 17.6%C. 72.4%D. 127.6%
答案 D 本题考查平均发展速度与平均增长速度。平均发展速度=平均增长速度+1。
32. 多项选择题
时间序列的速度分析指标有()。
A. 发展速度B. 发展水平C. 平均增长速度D. 平均增长量E. 增长速度
答案 ACE 时间序列的速度分析指标有发展速度和增长速度,平均发展速度和平均增长速度。
33. 单项选择题
前期水平为正、环比增长速度非零且以小数表示时,“增长1%的绝对值”的计算公式为()。
A. 逐期增长量/(环比增长速度×100)B. 环比增长速度/逐期增长量C. 逐期增长量/环比发展速度-1D. 环比发展速度/逐期增长量-1
答案 A 环比增长速度以小数表示时,增长1%的绝对值=逐期增长量/(环比增长速度×100)=前期水平/100。也可写为逐期增长量除以环比增长速度百分数的分子,选A。

校勘说明:为明确期间、计算口径或预测方法适用条件所作的校订后教学题设,不冒充原题原文。

34. 单项选择题
某地城镇固定资产投资2024年为631684亿元,2025年为635636亿元, 则 2025年城镇固定资产投资的增长1%绝对值为()亿元。
A. 6316.84B. 6356.36C. 631684D. 635636
答案 A 增长1%的绝对值=前期水平/100=631684/100=6316.84亿元,选A。
35. 多项选择题
在对时间序列及发展速度分析时,应注意的事项有()。
A. 不宜采用几何平均法计算平均发展速度B. 不需要结合水平指标进行分析C. 速度指标数值与基数大小有密切关系D. 时间序列指标值出现负数时不宜计算速度E. 时间序列指标值出现0时不宜计算速度
答案 CDE 速度分析应注意的问题包括:①当时间序列中的指标值出现0或负数时,不宜计 算速度;②速度指标的数值与基数的大小有密切关系。
36. 多项选择题
关于时间序列速度分析的说法,正确的有()。
A. 发展速度有定基与环比之分B. 增长速度是报告期增长量与基期水平的比值C. 当时间序列的指标值出现0或负数时,不宜计算速度D. 平均发展速度的计算经常使用几何平均法E. 平均增长速度可以根据一定时期的总增长速度进行简单平均计算
答案 ABCD 平均增长速度=平均发展速度-1,选项E错误。
37. 单项选择题
时间序列在较长一段时间内呈现的持续上升或持续下降的变动,称为 ()。
A. 长期趋势B. 季节变动C. 循环波动D. 不规则波动
答案 A 时间序列的成分通常有四种:长期趋势(T)、季节变动(S)、循环波动(C)和不规则 波动(I)。其中,长期趋势是时间序列在较长一段时间内呈现的持续上升或持续下降的变动。 这种趋势可能是线性的,也可能是非线性的。
38. 多项选择题
时间序列的成分通常有()。
A. 长期趋势B. 季节变动C. 循环波动D. 不规则波动E. 均匀波动
答案 ABCD 时间序列的成分通常有长期趋势、季节变动、循环波动和不规则波动等四种。
39. 单项选择题
如果以Yₜ表示第t期实际观测值,Fₜ表示第t期指数平滑预测值,α表示平滑系数,则指数平滑预测值的计算公式是( )。
A. Fₜ₊₁=αFₜ+(1-α)Yₜ₊₁B. Fₜ₊₁=αYₜ+(1-α)FₜC. Fₜ₊₁=α(Fₜ+Yₜ)D. Fₜ₊₁=αFₜ
答案 B 指数平滑法将过去时间序列值的加权平均数作为预测值。t+1期的预测值等于第t期实际观测值与第t期预测值的加权平均数:Fₜ₊₁=αYₜ+(1-α)Fₜ,所以选B。

校勘说明:按《经济基础知识(中级)章节同步习题集-304.pdf》原PDF第216页题面、第219页答案复核修正;保留原题答案。

40. 单项选择题
某公司2020—2024年主要产品销售额(单位:百万元)分别为:114、 115、121、120和 116,选取移动间隔h=3,用移动平均法预测2025年该公司的主要产品销售 额,则预测值是()。
A. 117B. 118C. 119D. 115
答案 C 移动间隔h=3,取2022—2024年最近3项平均:(121+120+116)/3=119百万元,选C。
41. 多项选择题
关于用于无明显趋势、无明显季节性序列的简单平滑预测方法,下列说法正确的有()。
A. 目的是减弱不规则成分引起的随机波动B. 包括简单移动平均法和一次指数平滑法C. 不经扩展或处理即可充分刻画明显趋势和季节波动D. 操作必然复杂且数据要求高E. 常用于近期预测,实际精度仍需通过预测误差检验
答案 ABE 本题限定简单平滑方法:通过平均或递减权重减弱随机扰动,操作较简,常用于短期预测;存在趋势季节时需扩展模型或预先处理,任何方法均不保证短期一定高精度。选ABE。

校勘说明:为明确期间、计算口径或预测方法适用条件所作的校订后教学题设,不冒充原题原文。

7本章打卡

做完一项勾一项,当天页会自动更新整体进度。

学完这章就是往前走了一步。记不住的,明天再来看必背,不用今天全记住。

↑ 回到今日顶部

1重点一览

先花 2 分钟看清这章有几个考点、哪几个是必考,心里有数再读书。

14页教材3个 ★★★2个 ★★1个 ★68道章节题约 112 分钟教材印刷页 247-260
考点一 会计基本概念★★
考点二 会计要素★★★
考点三 会计要素确认和计量基本原则★★★
考点四 会计基本前提★★★
考点五 会计信息质量要求★★
考点六 会计法规★

2教材标色 + 三色笔记

左边是教材原文,彩色句子就是《考点速记》收了的内容,颜色是星级。右边是速记的考点表,和左边的小节对齐。读一节,看一眼右边的表,再往下走。

一、会计基本概念

教材 P247

(一)会计的概念

会计是以货币为主要计量单位,采用专门的技术方法,对单位的全部经济运动进行核算和监督的一种经济管理活动,它通过系统、客观、及时地对单位的经济活动进行确认、计量和报告来为管理者提供决策信息。

现代会计以企业会计为核心,按照对外提供还是对内提供决策所需的信息分成财务会计与管理会计两大分支。

财务会计是以会计准则为主要依据,通过一定的程序和方法,确认、计量企业资产、负债、所有者权益的增减变动,记录营业收入的取得、费用的发生和归属,以及收益的形成和分配,定期以财务报表的形式报告企业财务状况、经营成果和现金流量,并分析报表,评价企业偿债能力、营运能力和盈利能力等的一套信息处理系统。财务会计的目的主要是向投资者、债权人、政府及有关部门和与企业有利害关系的社会公众等外部会计信息使用者提供企业生产经营活动情况等信息,帮助使用者作出相关决策。财务会计主要是对企业已发生的经济业务进行事后记录和反映,提供的信息是对过去生产经营活动的客观反映。

管理会计是从财务会计中分离出来的,它利用财务会计、统计及其他有关资料并通过对这些资料进行整理、计算、对比和分析,产生一系列新的信息,用于满足企业内部管理人员编制计划、作出决策、控制经济活动等方面的信息需要,是服务于企业加强内部经营管理,加强决策控制、提高经济效益需要的一套信息处理系统。管理会计主要包括预测分析、决策分析、全面预算、成本控制和责任会计等内容。

(二)会计的基本职能

会计的职能是指会计在经济管理中所具有的功能,是会计本质的外在表现形式。会计具有核算和监督两项基本职能。

1. 会计的核算职能。会计的核算职能是指会计通过确认、计量、记录、报告,运用一定的方法或程序,利用货币形式,从价值量方面反映企业已经发生或完成的客观经济活动情况,为经济管理提供可靠的会计信息。核算职能是会计的最基本职能。会计不仅要记录已发生的经济业务,也要记录正在发生的经济业务,为各单位的经营决策和管理控制提供依据。会计核算具有完整性、连续性和系统性的特点。

2. 会计的监督职能。会计的监督职能是指在经济事项发生以前、经济事项进行当中和经济事项发生以后,会计利用预算、检查、考核、分析等手段,对单位的会计核算及其经济活动的真实性、完整性、合规性和有效性进行检查与控制。会计监督包括事前、事中和事后监督。

会计的核算职能和监督职能是不可分割的。两者的关系是辩证统一的。对经济活动进行

教材 P248

会计核算的过程,也是实行会计监督的过程,核算是基本的、首要的,核算是监督的前提,没有会计核算,会计监督就失去了存在的基础;同时,没有会计监督来保证会计核算的正确性,会计核算就失去了存在的意义。

(三)会计的对象

会计的对象即会计的客体,就是会计所核算和监督的内容。凡是特定对象能以货币表现的经济活动,都是会计核算和监督的内容。企业中以货币表现的经济活动一般又称为资金运动。

以工业企业为例,工业企业是从事工业产品生产和销售的营利性经济组织,其再生产过程是以生产过程为中心的供应、生产和销售过程的统一。为了从事生产经营活动,企业必须拥有一定数量的资金,用于建造厂房、购买机器设备、购买原材料、支付职工工资、支付经营管理过程中各种必要的开支等;生产出的产品经过销售后,收回的货款还要补偿生产经营过程中垫付的资金。

1. 资金的投入。资金的投入包括企业所有者投入的资金和债权人投入的资金两部分,前者属于企业所有者权益,后者属于企业债权人权益(企业的负债)。投入企业的资金一部分构成流动资产(如货币资金、原材料等),另一部分构成非流动资产(如厂房、机器设备等)。资金的投入是企业资金运动的起点。

2. 资金的循环与周转。企业将资金运用于生产经营过程,就形成了资金的循环与周转。它又分为供应过程、生产过程、销售过程三个阶段。

(1)供应过程。它是生产的准备过程。在这个阶段,为了保证生产的正常进行,企业需要与供应单位发生货款的结算关系。随着采购活动的进行,企业的资金从货币资金形态转化为储备资金形态。

(2)生产过程。它既是产品的制造过程,又是资产的耗费过程。在这个阶段,劳动者借助于劳动手段将劳动对象加工成特定的产品,企业要发生原材料等劳动对象的消耗、劳动力的消耗和固定资产等劳动手段的消耗等,构成了产品的使用价值与价值的统一体。同时,随着劳动对象的消耗,资金从储备资金形态转化为生产资金形态;随着劳动力的消耗,企业向劳动者支付工资、奖金等劳动报酬,资金从货币资金形态转化为生产资金形态;随着固定资产等劳动手段的消耗,固定资产和其他劳动手段的价值通过折旧或摊销的形式部分地转化为生产资金形态。

(3)销售过程。它是产品价值的实现过程。在这个阶段,企业将生产的产品销售出去,取得销售收入,发生货款结算等业务活动,资金从成品资金形态转化为货币资金形态。

由此可见,随着生产经营活动的进行,企业的资金从货币资金形态开始,依次经过供应过程、生产过程和销售过程三个阶段,分别表现为储备资金、生产资金、成品资金等不同的存在形态,最后又回到货币资金形态,这种运动过程称为资金的循环。资金周而复始地不断循环,称为资金的周转。

3. 资金的退出。企业在生产经营过程中,为社会创造了一部分新价值,因此,企业收回的货币资金一般要大于投入的资金,这部分增加额就是企业的利润。企业实现的利润,按规定应以税金的形式上缴一部分给国家,还要按照有关合同或协议偿还各项债务,另外,还要按照企业章程或董事会决议向投资者分配股利或利润。这样,企业收回的货币资金中,用于缴纳税金、偿还债务和向投资者分配股利或利润的这部分资金就退出了企业的资金循环与周转,剩余

教材 P249

的资金则留在企业,继续用于企业的再生产过程。

(四)会计核算的具体内容

凡是特定主体能够以货币表现的经济活动,都是会计核算的内容。以货币表现的经济活动通常又称为资金运动。资金运动是指以货币表现的一个单位所拥有的各项财产物资的形态变化和位置移动。

通常将单位在日常生产经营和业务活动中的资金运动称为经济业务事项。经济业务事项分为经济业务和经济事项。经济业务又称经济交易,是指单位与其他单位和个人之间发生的各种经济利益的交换,如购买固定资产、销售商品、上缴税收等。经济事项是指在单位内部发生的具有经济影响的各类事项,如支付职工工资、报销差旅费、计提折旧等。这些经济业务事项就是会计核算的具体内容。

根据《中华人民共和国会计法》(以下简称《会计法》)规定,应当办理会计手续,进行会计核算的经济业务事项主要有:①资产的增减和使用;②负债的增减;③净资产(所有者权益)的增减;④收入、支出、费用、成本的增减;⑤财务成果的计算和处理;⑥需要办理会计手续、进行会计核算的其他事项。

二、会计目标

(一)会计目标

会计目标是指会计工作预期达到的最终结果。企业经营者在企业经营管理活动中,经常需要对一些重大问题作出决策。例如,在资金筹集活动中,要对筹集多少资金、何时筹集资金、从何处筹集资金等作出决策;在内部投资活动中,要对企业进行何种类型投资、如何投资等进行决策;在生产经营活动中,要对生产什么产品、提供何种劳务、如何生产这些产品和如何提供这些劳务作出决策;在销售活动中,要对向谁销售产品和提供劳务、以何种价格销售、怎样销售作出决策;在利润分配活动中,要对确定何种股利政策、如何进行股利分配等进行决策。

在市场经济条件下,会计的一般目标是向企业内部管理部门和企业外部与企业有利害关系的主体提供决策所需要的会计信息及与之相关的其他财务信息。会计目标要解决的问题,首先是谁需要会计信息,其次是需要什么样的会计信息。

我国企业会计的目标,一是通过会计活动,向会计信息使用者提供对决策有用的、与企业财务状况、经营成果和现金流量等有关的会计信息,以帮助会计信息使用者作出经济决策;二是反映企业管理层受托责任履行情况,有助于会计信息使用者评价企业的经营管理责任以及资源使用的有效性。

(二)会计信息的内容

总体上说,企业会计信息的主要内容大致有以下三大类。

1. 有关企业财务状况的信息,主要通过企业编制的资产负债表来反映。这类信息包括某一时点资产的总额和结构,表明企业拥有或控制的资源及其分布情况;某一时点负债总额及其结构,表明企业未来需要多少资产或劳务来清偿债务以及清偿时间;某一时点的所有者权益,据以判断资本保值增值的情况以及对负债的保障程度。

2. 有关企业经营成果的信息,主要通过利润表来反映。这类信息包括企业一定会计期间的收入实现情况,一定会计期间的费用耗费情况和生产经营成果,据以判断企业实现总价值的增减情况。

教材 P250

3. 有关企业现金流量的信息,主要通过现金流量表来反映。这类信息包括一定会计期间的现金或现金等价物的流动情况,经营活动、投资活动和筹资活动产生的现金流量及其内部组成情况。

(三)会计信息的主要使用者

企业会计信息的主要使用者包括企业内部管理人员和外部利益关系人两大类,企业外部利益关系人主要有企业的投资者、债权人、政府及有关部门、社会公众等,他们基于不同的需求,需要不同的会计信息。

1. 企业内部管理人员。企业管理人员为了内部管理和经营目的需要了解企业有关的会计信息,如收入总额、利润情况、费用大小等,将其与同行业水平相比、与本企业历史相比、与先进水平相比,可以找出差距,提出改进的方向和目标。通过对会计信息的分析使用,便于内部管理人员根据实际情况及时作出相应决策,提高经营管理水平,提高经济效益。

2. 外部利益关系人。会计信息的外部使用者主要是指企业外部的与企业有直接或间接利害关系的单位和个人以及政府有关管理部门,包括:①投资者;②债权人;③政府及其有关部门;④社会公众;⑤其他使用者,如监管部门、企业职工。

三、会计要素

为了具体实施会计核算,需要对会计核算和监督的内容进行分类。会计要素是会计对象按照交易或事项的经济特征所作的基本分类,是会计核算和监督对象的具体化。合理划分会计要素,有利于清晰地反映产权关系和其他经济关系。会计要素分为反映企业财务状况的会计要素和反映企业经营成果的会计要素。会计要素是组成会计报表的基本单位。我国企业会计准则规定,企业会计要素包括资产、负债、所有者权益、收入、费用和利润。资产、负债、所有者权益是组成资产负债表的会计要素,也称资产负债表要素。其中资产是资金的占用形态,负债和所有者权益是与资产相对应的取得途径,它们是反映企业财务状况的会计要素。而收入、费用、利润则是组成利润表的会计要素,也称利润表要素。其中收入是经济活动中经济利益的总流入,费用是经济活动中经济利益的总流出,收入与费用相配比,即形成经济活动的利润,利润是资金运用的成果,它们是反映企业经营成果的会计要素。

(一)反映财务状况的会计要素

1. 资产。资产是指企业过去的交易或者事项形成的由企业拥有或者控制的,预期会给企业带来经济利益的资源。资产具有以下几个方面的特征:

(1)资产必须是企业拥有或控制的资源,指企业享有某项资源的所有权,或者虽然不享有某项资源的所有权,但该资源能被企业所控制。

(2)资产必须是预期能够直接或间接给企业带来经济利益的,只有能给企业带来现金流入和经济利益的资源才可以作为资产;如果某项资产不能为企业带来经济利益,即使是由企业拥有或者控制的,也不能作为企业的资产,而应确认为损失,如待处理的无价值的报废产品等不能作为企业的资产。

(3)形成资产的交易或事项必须已经发生,即资产必须是现实的资产,是由企业过去的交易或者事项,如购买、生产建造行为或其他交易或者事项形成的,而不是预期的资产,预期在未来发生的交易或者事项不形成资产。例如,企业购入的原材料、固定资产、委托加工材料、应收账款等都属于企业的资产,而计划购买的机器设备等尚未购置的则不能作为企业的资产。

教材 P251

将一项资源确认为资产,需要符合资产的定义,并同时满足以下两个条件:一是与该资源有关的经济利益很可能流入企业,二是该资源的成本或者价值能够可靠地计量。

资产按流动性分类可分为流动资产和非流动资产。流动资产是指预计在一个正常营业周期中变现、出售或耗用,或者主要为交易目的而持有,或者预计在资产负债表日起 1 年内(含 1 年)变现的资产,以及自资产负债表日起 1 年内交换其他资产或清偿负债的能力不受限制的现金或现金等价物。流动资产主要包括货币资金、交易性金融资产、应收票据及应收账款、预付款项、其他应收款、存货等。非流动资产是指流动资产以外的资产,主要包括长期股权投资、固定资产、在建工程、无形资产、开发支出等。

符合资产定义和资产确认条件的项目,应当列入资产负债表;符合资产定义,但不符合资产确认条件的项目,不应当列入资产负债表。

2. 负债。负债是指过去的交易、事项形成的,预期会导致经济利益流出企业的现时义务。它是企业所承担的能以货币计量,需以资产或劳务偿还的债务。负债具有以下特征:

(1)企业的负债只能由过去的交易活动或本期经济业务所形成,且必须于未来某一特定时期予以清偿的现时义务,不需要未来偿还的现时义务或企业在将来要发生的交易或者事项形成的义务不属于负债,如企业从银行借入贷款即形成企业的负债,企业与供应商签订的在未来可能形成负债的采购合同,在当前就不能作为负债。

(2)负债必须有其可用货币额反映的价值量,不能用货币计量的不能作为负债。

(3)负债的偿还不论是以资产偿还,还是以提供劳务偿还或是转让股权给债权人,必须是企业现行条件下已承担的预期都会造成经济利益流出企业的现时义务。

符合负债定义的义务,在同时满足以下两个条件时,确认为负债:一是与该义务有关的经济利益很可能流出企业,二是未来流出的经济利益的金额能够可靠计量。

负债按流动性分类可分为流动负债和非流动负债。流动负债是指预计在一个正常营业周期中清偿,或者主要为交易目的而持有,或者自资产负债表日起 1 年内(含 1 年)到期应予以清偿或者企业无权自主地将清偿推迟至资产负债表日后 1 年以上的负债。流动负债主要包括短期借款、应付票据及应付账款、预收款项、应付职工薪酬、应交税费、其他应付款等。非流动负债是指流动负债以外的负债,主要包括长期借款、应付债券等。

符合负债定义和负债确认条件的项目,应当列入资产负债表;符合负债定义,但不符合负债确认条件的项目,不应当列入资产负债表。

3. 所有者权益。所有者权益又称为股东权益,是指企业资产扣除负债后由所有者享有的剩余收益。所有者权益是投资人在企业中享有的经济利益,即投资人对企业净资产的所有权。所有者权益的来源包括所有者投入的资本,直接计入所有者权益的利得和损失、留存收益等。利得是指由企业非日常活动所发生的、会导致所有者权益增加的、与所有者投入资本无关的经济利益的流入。损失是指由企业非日常活动所发生的、会导致所有者权益减少的、与向所有者分配利润无关的经济利益的流出。

所有者权益的确认主要依赖于其他会计要素,尤其是资产和负债的确认;其金额的确定取决于资产和负债的计量。

所有者权益包括实收资本(或股本)、资本公积、盈余公积和未分配利润。其中资本公积包括企业收到投资者出资超过其在注册资本或股本中所占份额的部分,以及直接计入所有者权益的利得和损失等;盈余公积和未分配利润又合称为留存收益,是企业历年实现的净利润留存于企业的部分。

教材 P252

所有者权益项目应当列入资产负债表。

从会计要素的角度来看,负债和所有者权益同为企业资产的取得来源,两者都可以对企业资产提出索偿要求,但负债体现的是债权人对企业资产的索偿权,它是企业所承担的现时义务,企业需要按照约定条件支付利息,债权人不参与利润分配,在企业清算时需要优先清偿,净资产在清偿所有负债后才可以返还给投资人;而所有者权益则是投资人对总资产扣除负债后的剩余净资产的索偿权,投资人在一般情况下不需要企业归还其投资,也不需要支付利息,只是要参与企业利润分配,以利润分配作为回报。

(二)反映经营成果的会计要素

1. 收入。收入是指企业在日常活动中形成的,会导致所有者权益增加的、与所有者投入资本无关的经济利益的总流入。收入具有以下特征:①收入应当是企业在日常活动中形成的;②收入应当会导致企业经济利益的流入,该流入不包括所有者投入资本;③收入应当最终会导致所有者权益的增加。符合收入的定义,同时符合下列条件的经济利益的流入,可以确认为收入:一是与收入有关的经济利益很可能流入企业,二是经济利益流入企业会导致企业资产增加或者负债减少,三是经济利益的流入额能够可靠计量。

由于销售商品、提供劳务及让渡资产使用权等日常经营活动所发生的或即将发生的经济利益的流入,包括营业收入、投资收益和营业外收入,都属于企业的收入。收入是企业持续经营的基本条件,也是企业获得利润的前提条件。收入是企业的日常经营活动中产生的,而不是从偶发的交易或事项中产生的。收入可能表现为企业资产的增加,也可能表现为企业负债的减少,或者兼而有之。收入能导致企业所有者权益的增加。只有流入本企业的经济利益才属于本企业的收入,为第三方代收的款项不属于本企业的收入。

符合收入定义和收入确认条件的项目,应当列入利润表。

2. 费用。费用是指企业在日常活动中发生的、会导致所有者权益减少的、与向所有者分配利润无关的经济利益的总流出。费用具有以下特征:

(1)费用应当是企业在日常活动中发生的。

(2)费用应当会导致经济利益的流出,该流出不包括向所有者分配的利润。

(3)费用应当最终会导致所有者权益的减少。符合费用的定义,并符合以下条件的经济利益的流出,可以确认为费用:一是与费用有关的经济利益很可能流出企业,二是经济利益流出企业的结果会导致企业资产减少或者负债增加,三是经济利益的流出额能够可靠计量。

企业为生产产品、提供劳务等发生的可归属于产品成本、劳务成本的费用,应当在确认产品销售收入、劳务收入时,将已销售产品、已提供劳务的成本计入当期损益。企业发生的支出不产生经济利益的,或者即使能够产生经济利益但不符合或者不再符合资产确认条件的,应当在发生时确认为费用,计入当期损益。企业发生的交易或者事项导致其承担了一项负债而又不确认为一项资产的,应当在发生时确认为费用,计入当期损益。

企业要进行经营活动,在取得收入的同时必然要相应地发生一定的费用。狭义的费用是指为取得收入而发生的各种与提供商品和劳务有关的资产耗费,即营业费用;广义的费用还包括投资损失、营业外支出和所得税费用。

营业费用是企业费用的主体部分,按照是否构成产品成本,工业企业的营业费用可分为制造成本和期间费用。制造成本是指与生产产品直接有关的费用,应计入产品成本,从销售收入中得到补偿。期间费用是指与生产产品无直接关系,属于某一时期耗用的费用,包括管理费

教材 P253

用、研发费用、财务费用和销售费用等。期间费用不参与成本计算,而是直接计入当期损益。费用通常是为取得营业收入而发生的耗费,可以表现为资产减少或负债增加。费用是对耗费的计量,这种耗费并不一定表现为当期直接发生的支出,有些耗费是通过系统合理地分配而形成的,如固定资产折旧费用、长期待摊费用摊销等。费用与成本是相互联系又相互区别的两个概念,为生产某产品发生的生产费用是构成该产品成本的基础。两者的区别在于费用是按照时间归集的,而产品成本是按照产品对象归集的。

符合费用定义和费用确认条件的项目,应当列入利润表。

3. 利润。利润是指企业在一定会计期间内的经营成果,是企业在生产经营过程中各种收入扣除各种费用后的盈余,是反映经营成果的最终要素。利润反映的是企业的经营业绩情况,是业绩考核的重要指标。

利润包括收入减去费用后的净额,直接计入当期利润的利得和损失等。其中收入减去费用后的净额反映的是企业日常活动的业绩;直接计入当期利润的利得和损失,是指应当计入当期损益、最终会引起所有者权益发生增减变动的、与所有者投入资本或者向所有者分配利润无关的利得和损失,它反映的是企业非日常活动的业绩。

利润的确认主要依赖于收入和费用以及利得和损失的确认,其余额的确定取决于收入和费用、直接计入当期利润的利得和损失金额的计量。利润项目应当列入利润表。

(三)会计等式

以上六个会计要素相互之间存在着一定的数量关系。反映这种数量关系的恒等式,即为会计等式。

资产和负债、所有者权益是财产资源这个同一体的两个方面,因而客观上存在必然相等的关系。从数量上看,有一定数额的资产,必定有一定数额的负债和所有者权益;反之,有一定数额的负债和所有者权益,也必定有一定数额的资产,资产与负债和所有者权益之间在数量上必然相等。

资产 = 权益 = 债权人权益 + 所有者权益 = 负债 + 所有者权益

这一平衡公式反映了企业资产的归属关系。企业的资产来源于所有者的投入资本和债权人的借入资金,以及企业在生产经营中所产生效益的积累,分别归属于所有者和债权人,归属于所有者的部分形成所有者权益,归属于债权人的部分形成债权人权益,即企业的负债。资产来源于权益,包括所有者权益和债权人权益,资产与权益必然相等。在某个特定的时点,资产与负债和所有者权益三者之间所存在的平衡关系,是复式记账法的理论基础,也是编制资产负债表的基础。

与此相对应,企业收入是其日常活动中形成的经济效益的总流入,费用是企业在日常经营活动中发生的经济效益的总流出,企业一定时期的收入扣除所发生的各项费用后的净额,经过调整后等于利润。在不考虑调整因素,如直接计入当期利润的利得和损失等情况下,收入减去费用等于利润。

收入 − 费用 = 利润

这一平衡公式反映了企业利润的形成过程,收入、费用和利润之间的上述关系是编制利润表的基础。

企业在经营过程中不断发生各种经济业务,这些业务的发生会对有关会计要素产生影响。但无论发生什么经济业务,都不会破坏上述资产与负债和所有者权益各会计要素之间的平衡关系。

教材 P254

由于这一平衡原理揭示了企业会计要素之间的规律性联系,因而它是设置会计科目、复式记账和编制会计报表的理论依据。

(四)经济业务发生所引起的会计要素的变动

经济业务发生所引起的会计要素的变动,主要是下列九种情况:

(1)一项资产和一项负债同时等额增加。

(2)一项资产和一项所有者权益同时等额增加。

(3)一项资产和一项负债同时等额减少。

(4)一项资产和一项所有者权益同时等额减少。

(5)一项资产增加,另一项资产等额减少,负债和所有者权益要素不变。

(6)一项负债增加,另一项负债等额减少,资产和所有者权益要素不变。

(7)一项负债增加,另一项所有者权益等额减少,资产要素不变。

(8)一项负债减少,另一项所有者权益等额增加,资产要素不变。

(9)一项所有者权益增加,另一项所有者权益等额减少,资产和负债要素不变。

四、会计要素确认和计量基本原则

会计要素确认和计量的原则是指为了使会计信息能达到质量标准,而对会计核算所作的一般规范,这些原则是会计核算、计量、记录、报告的基础,是确认一定会计期间的收入和费用从而确认损益的基础。

(一)权责发生制原则

由于经济活动是持续进行的,而会计核算是分期进行的,在会计期间实现的收益和发生的费用,有些在相邻的会计期间是相互交错的。由于会计分期的假设,产生了本期与非本期的区别,企业在一定会计期间为进行生产经营活动而发生的费用,可能在本期已经付出货币资金,也可能在本期尚未付出货币资金;所形成的收入,可能在本期已经收到货币资金,也可能在本期尚未收到货币资金。同时,本期发生的费用可能与本期收入的取得有关,也可能与本期收入的取得无关。通常,企业用来确认一定会计期间的收入和费用,从而确定损益的标准有两种。

一种是权责发生制,也称应计制。权责发生制要求,凡是当期已经实现的收入和已经发生或应当负担的费用,不论款项是否收付,都应当作为当期的收入和费用;凡是不属于当期的收入和费用,即使款项已在当期收付,也不应当作为当期的收入和费用。即企业是按收入的权利和支出的义务是否属于本期,而不是按是否在本期实际收到款项来确认收入费用的入账时间。例如,某企业 1 月份支付上半年的设备租金 12000 元,由于此项费用的受益期是上半年,即 1 至 6 月,所以,该企业在 1 月份支付租金时并不是全部计入 1 月份的费用中,而是在 1 至 6 月中每月记录费用 2000 元。

另一种是收付实现制,也称现金制。收付实现制要求,凡是本期实际收到款项的收入,不论其应否归属于本期,均应作为本期的收入处理;凡是本期实际以款项支付的费用,不论其应否在本期收入中得到补偿,均应作为本期的费用处理。即企业是以收到款项或支付款项作为确认收入费用的基础,而不是按收入的权利和支出的义务是否属于本期来进行确认。如上述 1 月份支付上半年的租金,此费用发生在 1 月份,虽然 1 至 6 月都受益,但都直接计入 1 月份费用中。一个单位在确定会计记账基础时要充分考虑其所处行业的特点和会计信息使用者的不同需要,按照重要性原则加以确定。为了正确反映企业的经营成果,通常情况下应按权责发生

教材 P255

制进行确认和计量。

我国《企业会计准则》规定,企业会计的确认、计量和报告应当以权责发生制为基础。而我国行政事业单位预算会计核算采用收付实现制,财务会计核算采用权责发生制,国务院另有规定的,依照其规定。

(二)配比原则

配比原则是指对一个会计期间的收入和与其相关的成本、费用应当在该会计期间内确认,并应相互配比,以便计算本期损益。

在会计实务中,收入与费用的配比方式主要有两种:一种是根据收入与费用之间的逻辑因果关系进行直接配比,如主营业务收入与直接成本相配比;另一种是根据收入与费用项目存在的时间上的一致关系,将某些与特定收入项目没有明显因果关系的费用项目,如广告费、办公费和管理人员工资等期间费用,与发生在同一时间的收入相配比。配比原则要求在会计核算中,一个会计期间内的各项收入及与其相关的成本费用,应当在同一会计期间内进行确认、计量和记录,而不能提前或延后,否则就会造成经营成果虚假不实。对于一切预支款项的成本、费用,要递延到有关的收入取得时才能计列;对于与本期收入有关的一切未来费用,则应在本期内预提,以达到配比的目的。

(三)历史成本原则

历史成本原则又称实际成本原则或原始成本原则,是指企业各项财产在取得时应当按照实际成本计量,其后各项财产如果发生减值,应当按照规定计提相应的减值准备,除法律、行政法规和国家统一的会计制度另有规定者外,企业一律不得自行调整其账面价值。

采用历史成本计价的优点在于:一是它是买卖双方通过正常交易确定的金额,或资产购进过程中实际支付的金额,取得比较容易,也比较客观;二是有原始凭证作证明,便于查证;三是可以防止企业随意更改;四是会计核算手续简化,不必经常调整账目。历史成本原则是以币值稳定为前提的。在历史成本原则下,如果企业的资产发生了较大的价值变化,其账面价值就不能反映其实际价值,就不能提供正确的会计信息。

(四)划分收益性支出与资本性支出原则

划分收益性支出与资本性支出原则是指企业的会计核算应当合理划分收益性支出与资本性支出的界限。收益性支出是指在本期发生的只与本期收益有关的,应当在本期已实现的收益中得到补偿的支出;资本性支出是指在当期发生的不但与本期收益有关而且与以后会计期间收益也有关的,应当在以后若干会计期间的收益中得到补偿的支出。划分收益性支出与资本性支出原则要求,凡为取得本期收益而发生的支出,即支出的效益仅惠及本会计年度(或一个营业周期)的,应当作为收益性支出,计入当期损益,并在利润表中反映;凡是为以后各期取得收益而发生的各种资产支出,即支出的效益惠及几个会计年度(或几个营业周期)的,应当作为资本性支出,列入资产,在资产负债表中反映,并根据其与以后各期收益的关系,将其价值分摊到以后各个会计期间。

划分收益性支出与资本性支出的目的在于正确确认企业的当期损益。如果一笔收益性支出按资本性支出处理了,就会造成少计费用而多计资产价值,出现净收益和资产价值虚增的现象。相反,如果一笔资本性支出按收益性支出处理了,则会出现多计费用而少计资产价值的现象,出现当期净收益降低甚至亏损,以及资产价值偏低的结果。

五、会计基本前提

教材 P256

会计基本前提又称会计基本假设,是指为了保证会计工作的正常进行和会计信息的质量,对会计核算的范围、内容、基本程序和方法所作的限定,即面对变化不定的社会经济环境,会计人员对某种情况按进行会计工作的先决条件所作出的合理推断或人为规定,是组织会计核算工作的基本前提。会计的基本前提包括会计主体、持续经营、会计分期、货币计量。

(一)会计主体

会计主体是指会计确认、计量和报告的空间范围,是会计所服务的特定单位。会计是在每一个会计主体中进行的。会计核算应当以一个特定独立的或相对独立的经营单位为对象,所以会计主体一般是在经济上独立或相对独立可以单独进行确认计量的单位。在会计主体假设下,企业应当对其本身发生的交易或者事项进行会计确认、计量和报告,反映企业本身所从事的各项生产经营活动。明确界定会计主体,是会计核算的重要前提,是为了把会计主体的经济业务与其他会计主体以及投资者的经济业务划分开。会计主体确定之后,会计人员只是站在特定会计主体的立场,核算特定主体的经济活动。会计主体不同于法律主体,一般来说,法律主体必然是会计主体,但会计主体可以是一个独立的法律主体,也可以不是一个独立的法律主体,会计主体可以是营利性组织,也可以不是营利性组织,如行政事业单位、企业、企业的分支机构、企业内部相对独立的某个生产车间、可以作为费用报销单位的企业内部职能部门、由多个法人组成的企业集团、合伙组织等。但是,作为一个会计主体,必须有独立的资金活动,独立地进行核算,可以独立编制财务报告。

会计主体规定了会计核算内容的空间范围,这一前提就是要明确会计所提供的信息,特别是会计报表,反映的是特定会计主体的财务状况与经营成果,这一前提要求在会计核算中既不能将本会计主体与其他会计主体混淆,也不能将本会计主体的会计事项遗漏或转移。

(二)持续经营

持续经营是指会计核算应当以持续正常的生产经营活动为前提,在可以预见的将来,企业将会按当前的规模和状态继续经营下去,而不考虑企业停业或破产清算,也不考虑企业大规模削减业务,所持有的资产将正常营运,所负有的债务将正常偿还。明确持续经营这一前提,就意味着会计主体将按照既定的用途使用资产,按照既定的合约条件清偿债务,会计人员在此基础上选择会计政策和会计估计方法。会计主体确定后,只有假定这个作为会计主体的企业是持续正常经营的,假定在可以预见的未来,企业将以既定的经营方针和目标持续经营下去,而不会面临破产清算,会计原则和会计程序才可能建立在正常非清算的基础之上,这样才能保持会计信息处理的一致性和稳定性,才能建立起诸如历史成本原则、权责发生制原则等会计确认和计量的一般原则,固定资产才能根据历史成本进行记录,并按期计提折旧,将历史成本分摊到各个会计期间或相关产品的成本中。企业在信息的收集和处理上所采用的会计方法才能保持稳定,会计核算才能正常进行。例如,只有在持续经营的前提下,企业的资产和负债才区分为流动的和长期的;企业资产才能以历史成本计价,而不是以现行成本或清算价格计价;才有必要和可能进行会计分期,并为采用权责发生制奠定基础;才使正确区分资本与负债成为必要。

(三)会计分期

会计分期又称会计期间,是指将一个企业持续不断的生产经营活动期间,划分为若干连

教材 P257

续的、等距的会计期间,以便分期结算账目,计算盈亏,按期编制会计报表,从而提供有用的会计信息。会计分期是建立在持续经营基础上的。会计期间就是在会计工作中为核算生产经营活动或预算执行情况所规定的起讫日期,一般分年度和中期。在我国,年度和中期均按公历起讫日期确定,中期一般是指短于一个完整的会计年度的报告期间。明确会计期间这个前提,才产生了当期和以前期间、以后期间的差别,才使不同类型的会计主体有了会计确认和计量的基准,产生了收付实现制和权责发生制,才能正确贯彻配比原则。只有正确地划分会计期间,才能提供有关财务状况和经营成果的资料,才能进行会计信息的对比。

(四)货币计量

货币计量是指企业在进行会计确认、计量和报告时采用货币为主要计量单位进行记录,反映企业的财务状况、经营成果和现金流量,并假定货币的币值保持不变。

对企业经济活动的计量,可以采用多种计量单位,如实物数量、货币、重量、长度、体积等,由于各种经济活动的非货币计量单位,具有不同的性质,在量上无法比较,为了连续、系统、全面、综合地反映企业的经济活动,会计核算客观上需要一种统一的计量单位作为会计核算的计量尺度,货币作为一般等价物,是衡量商品价值的共同尺度,自然被选择作为会计核算的计量单位。明确货币计量这一前提,才能对所有会计对象采用同一种货币作为统一尺度来进行计量,并把企业经营活动和财务状况的数据转化为按统一货币单位反映的会计信息。我国《企业会计准则》规定,企业会计应当以货币计量。以货币作为统一计量单位,还包含着币值稳定的假设,当货币本身的价值波动不大,或前后波动能够被抵消时,会计核算中认为币值是基本稳定的,而不考虑货币价值的波动因素。当然,货币计量的假设并不表示货币是会计核算中唯一的计量单位,有时在会计核算中也辅以实物数量等计量单位。

综合上述会计核算的四个基本前提说明,会计要确定会计所服务的特定单位和范围,采用货币这一统一尺度,在持续经营条件下选择恰当的会计方法对日常的经济业务进行确认、计量,并按会计分期定期编制出完整反映会计主体财务状况和经营成果的会计报表,就构成了企业开展会计工作、组织会计核算的前提条件和理论基础。

六、会计信息质量要求

企业进行会计核算,对外提供会计信息,应当满足一定的要求。提供满足要求的会计信息,需要坚持一定的标准,这些标准是处理具体会计业务的基本要求,是在会计核算前提条件制约下,进行会计核算的标准和质量要求。我国《企业会计准则》要求企业提供会计信息时满足以下质量要求。

(一)可靠性

可靠性要求企业应当以实际发生的交易或者事项为依据进行会计确认、计量和报告,如实反映符合确认和计量要求的各项会计要素及其他相关信息,如实反映企业的财务状况、经营成果和现金流量,保证会计信息真实可靠、内容完整。可靠性包括真实性和客观性两方面含义,真实性要求会计核算所提供的会计信息,应当真实反映企业实际的财务状况和经营成果;客观性要求经济业务的记录和核算、报告必须建立在可查证的基础上,以客观事实为依据,不能凭空编造,并且项目完整、手续完备。在实际会计核算工作中,用作证明客观事实的计量依据主要是各种原始凭证和仪表记录等。

教材 P258

(二)相关性

相关性又称有用性,要求企业提供的会计信息应当与财务会计报告使用者的经济决策需要相关,有助于财务会计报告使用者对企业过去、现在或者未来的情况作出评价或者预测,有助于信息使用者作出经济决策。会计目标就是为有关方面提供经济信息,而要发挥好会计信息的作用,就必须使提供的信息能够作为会计信息使用者进行决策和分析的依据,便于信息使用者有效使用。这就要求会计在收集、处理、传递信息的过程中,考虑有关方面对会计信息的要求,以确保提供的信息与信息使用者的要求相关并且有用。

(三)清晰性

清晰性又称可理解性,要求会计提供的会计信息应当清晰明了,便于财务会计报告使用者理解和使用。要求企业提供的数据记录和文字说明能清楚地反映经济活动及其结果的基本情况,并对需要解释的问题作出必要的说明。

提供会计信息的目的是要使用这些信息,要使用,就必须先了解会计信息的内容,否则就谈不上会计信息的使用,这就要求会计所提供的信息必须清晰简明、易懂,能为大多数使用者所理解,对复杂的经济业务应该用规范文字加以表述,以便有关部门和人员正确理解,合理利用。

(四)可比性

可比性要求企业提供的会计信息应当具有可比性。一方面要求同一企业不同时期发生的相同或者相似的交易或者事项,应当采用一致的会计政策,不得随意变更;确需变更的,应当在附注中说明,以便进行不同时期的纵向比较。另一方面要求不同企业发生的相同或者相似的交易或者事项,应当采用规定的会计政策和会计处理办法,确保会计信息口径一致,以便在不同企业之间进行横向比较。

(五)实质重于形式

实质重于形式要求企业应当按照交易或事项的经济实质进行会计确认、计量和报告,而不应当仅仅以交易或者事项的法律形式为依据。

在实际工作中,交易和事项所表现出来的外在法律形式并不总能完全真实地反映其实质内容。所以,会计确认、计量和报告时应当根据它们的经济实质来进行,而不能仅仅根据它们的法律形式进行。如以融资租赁方式租入的固定资产,虽然法律上企业并不拥有其所有权,但由于租赁合同中规定的租赁期较长、接近于该资产的使用寿命,租赁期满承租企业有优先购买该资产的选择权,在租赁期内承租企业有权支配资产并从中获取收益,所以,从经济实质上,企业拥有该资产的实际控制权,在会计核算上就将其视为企业的资产。只有这样,才有利于会计信息使用者依据企业的财务状况和经营成果等作出决策。

(六)重要性

重要性要求企业提供的会计信息应当反映与企业财务状况、经营成果和现金流量等有关的所有重要交易或者事项。在会计核算过程中对交易或事项应当区别其重要程度,采用不同的核算方式。会计报表在全面反映企业财务状况和经济成果的同时,对于对资产、负债、损益等有较大影响,并进而影响财务会计报告使用者据以作出合理判断的重要的会计事项必须按照规定的方法和程序进行处理,并在财务会计报告中予以充分、准确的披露;而对次要的会计事项,在不影响会计信息真实性和不至于误导财务会计报告使用者作出正确判断的前提下,可适当简化或合并反映。重要性要求每个企业都要根据会计事项对信息使用者进行决策的影响程度来确定自己的重要会计事项,根据会计事项的重要程度,采取不同的核算方式和不同的核

教材 P259

算精度。

凡是一旦省略和错报就会影响使用者据此作出经济决策的,该项会计信息就具有重要性。在实际工作中,重要性的应用需要依赖职业判断,企业应当根据其所处的环境和实际情况,从项目的性质和金额大小两方面来判断其重要性。一般情况下,与决策者的利益关联度高的和金额占总业务量比重较大的项目应当作为重要项目在财务报表上进行反映。

(七)谨慎性

谨慎性又称稳健性,要求企业对交易或者事项进行会计确认、计量和报告时应当保持应有的谨慎,不应高估资产或者收益,低估负债或者费用。例如,某一经济业务有几种处理方法可供选择时,应选择采取一种不导致夸大资产、虚增账面利润、扩大所有者权益的方法。对于预计会发生的损失应计算入账,对于可能产生的收益则不预计入账。谨慎性原则在会计上的应用是多方面的,如采用成本与可变现净值孰低法对存货进行期末计价,对应收账款计提坏账准备,固定资产采用加速折旧法,对可能发生的资产损失计提减值准备等。但是,谨慎性原则的应用并不允许企业设置秘密准备。

(八)及时性

及时性要求企业对于已经发生的交易或者事项,应当及时进行会计确认、计量和报告,不得提前或者延后。及时性要求收集会计信息要及时,对会计信息进行加工处理和传递给信息使用者都要及时,以满足各方面信息使用者的决策需要。

七、会计法规

会计法规是指规范财务会计实务的法律、法规、准则和制度等的总称,它是约束会计行为的标准,又是评价会计工作的依据。我国现行的会计法规以《会计法》为核心,以会计准则、财务规则和会计制度为主要内容。

(一)《会计法》

《会计法》是我国会计工作的基本法律,是我国会计法规体系中处于最高层次的法律规范,是制定其他会计法规的基本依据,也是指导会计工作的最高准则。《会计法》对我国会计工作的主要方面作出了规定,涉及我国会计工作的各个方面。该法对我国会计工作的地位和作用进行了说明,并对我国会计管理的体制、会计核算和会计监督的对象及内容、会计机构、会计人员的职责和权限以及有关的法律责任作出了明确的规定。

(二)会计准则

会计准则也称会计标准,是制定会计核算制度和组织会计核算工作的基本规范。

1. 《企业会计准则》。我国的《企业会计准则》由财政部制定,包括基本准则和具体准则两部分。

(1)基本准则。基本准则主要是为规范会计确认、计量和报告行为,保证会计信息质量而对会计核算的一般要求和会计核算的主要方面作出原则性规定,为具体准则的制定提供依据,包括会计核算的一般原则和会计要素准则。

(2)具体准则。具体准则是根据基本准则的要求,对企业各种经济业务的会计处理方法和程序作出具体规定,包括基本业务准则、特殊业务准则和特殊行业基本业务准则。

2. 《事业单位会计准则》。《事业单位会计准则》是财政部制定的规范事业单位会计核算,保证会计信息质量的原则性规定。它主要对事业单位会计核算的目标、前提、会计要素、会计

教材 P260

信息质量要求、财务会计报告等作出了规定。3.《政府会计准则》。《政府会计准则》是财政部为了规范政府的会计核算,保证会计信息质量制定的原则性规定。它主要对政府会计信息质量要求、政府预算会计要素、政府财务会计要素、政府决算报告和财务报告等作出了规定。(三)财务规则1.《行政单位财务规则》。《行政单位财务规则》是为了规范行政单位的财务行为,加强行政单位财务管理和监督,提高资金使用效益,保障行政单位工作任务的完成,由财政部制定的规范行政单位财务活动的一般规则。它主要对行政单位财务管理的基本原则、主要任务、单位预算管理、收入管理、支出管理、结转和结余管理、专用基金管理、资产管理、负债管理、行政单位划转撤并的财务处理、财务报告和财务分析、财务监督以及行政单位财务分析指标等作出规定。2.《事业单位财务规则》。《事业单位财务规则》是财政部为了进一步规范事业单位的财务行为,加强事业单位财务管理和监督,提高资金使用效益,保障事业单位健康发展,由财政部制定的规范事业单位财务活动的一般规则。它主要对事业单位财务管理的基本原则、主要任务、单位预算管理、收入管理、支出管理、结转和结余管理、资产管理、负债管理、事业单位清算、财务报告和财务分析、财务监督以及事业单位财务分析指标等作出规定。(四)会计制度1.《企业会计制度》。《企业会计制度》是为了规范企业的会计核算,真实、完整地提供会计信息,由财政部根据《会计法》及国家其他有关法律和法规制定的具体会计核算制度。其主要内容有:企业会计工作的基本任务,会计核算的基本前提和基本原则,会计要素,有关会计业务核算中会计科目及其使用方法的规定,会计凭证账簿记账程序和记账方法的规定,会计报表的格式及其编制方法,有关财产管理、成本计算方面的规定和有关财产清查、会计人员交接和会计档案管理方面的规定等。2.《政府会计制度》。《政府会计制度》是为了规范行政事业单位的会计核算,保证会计信息质量,由财政部根据《会计法》《预算法》《政府会计准则》的要求制定的适用于行政事业单位具体会计核算制度。其主要内容有:总说明、会计科目名称和编号、会计科目使用说明、报表格式、报表编制说明等。

3必背

这些是必须背下来的。先遮住右边一列,看左边考点名,自己说出内容,说不出来的做记号。

经济基础 第28章 会计概论 必背

红 ★★★ 必考

考点必背内容
会计要素概念会计对象按交易或事项的经济特征所作的基本分类,是会计核算和监督对象的具体化,是组成会计报表的基本单位
六要素分两组「资负所」反映财务状况 = 资产负债表要素(时点);「收费利」反映经营成果 = 利润表要素(期间)
资产定义过去的交易或事项形成、企业拥有或控制、预期带来经济利益的资源
资产三特征拥有或控制;能带来经济利益;形成资产的交易或事项已经发生(计划买的不算)
流动资产货币资金、交易性金融资产、应收票据及应收账款、预付款项、其他应收款、存货
非流动资产长期股权投资、固定资产、在建工程、无形资产、开发支出
负债定义过去的交易、事项形成,预期导致经济利益流出企业的现时义务
负债三特征过去交易或本期业务形成;能用货币额反映;现行条件下已承担、会造成利益流出的现时义务
流动负债短期借款、应付票据及应付账款、预收款项、应付职工薪酬、应交税费、其他应付款
非流动负债长期借款、应付债券
所有者权益又称股东权益 = 资产 − 负债后由所有者享有的剩余收益;范围:实收资本(或股本)、资本公积、盈余公积、未分配利润
留存收益盈余公积 + 未分配利润
收入定义日常活动形成、导致所有者权益增加、与所有者投入资本无关的经济利益总流入
收入三特征日常活动形成;导致经济利益流入(不含所有者投入);最终导致所有者权益增加
收入范围营业收入、投资收益、营业外收入
费用定义日常活动发生、导致所有者权益减少、与向所有者分配利润无关的经济利益总流出
费用三特征日常活动发生;导致经济利益流出(不含分配利润);最终导致所有者权益减少
费用范围狭义 = 营业费用;广义还包括投资损失、营业外支出、所得税费用
利润定义一定会计期间的经营成果,各种收入扣除各种费用后的盈余,反映经营成果的最终要素
利润范围收入减费用后的净额 + 直接计入当期利润的利得和损失
会计等式资产 = 权益 = 债权人权益 + 所有者权益 = 负债 + 所有者权益;收入 − 费用 = 利润
权责发生制又称应计制:当期已实现的收入、已发生或应负担的费用,不论款项是否收付都算当期;不属于当期的,即使收付了也不算当期
收付实现制又称现金制:本期实际收到或付出的款项,就算本期收入或费用
谁用哪种企业会计:权责发生制;行政事业单位:预算会计用收付实现制,财务会计用权责发生制,国务院另有规定依其规定
配比原则一个会计期间的收入和与其相关的成本费用,在该期间内确认并相互配比,以计算本期损益
历史成本原则又称实际成本原则、原始成本原则:取得时按实际成本计量,发生减值按规定计提减值准备,除法律法规和国家统一会计制度另有规定外一律不得自行调整账面价值
收益性支出效益只在本会计年度(或一个营业周期),计入当期损益,进利润表
资本性支出效益惠及几个会计年度(或几个营业周期),列入资产进资产负债表,再分摊到以后各期
划分错了会怎样收益性支出错按资本性处理:少计费用、多计资产、利润虚增;反之:多计费用、少计资产、利润偏低
会计基本前提又称会计基本假设,四个:会计主体、持续经营、会计分期、货币计量
会计主体会计确认、计量和报告的空间范围,会计所服务的特定单位;法律主体必是会计主体,会计主体不一定是法律主体
持续经营假定企业按当前规模和状态继续经营,不考虑停业、破产清算、大规模削减业务
会计分期又称会计期间:把持续经营活动划分为若干连续、等距的期间,以便分期结账、算盈亏、编报表;分年度和中期,中期短于一个完整会计年度
货币计量以货币为主要计量单位记录,并假定币值不变;货币不是唯一计量单位,可辅以实物数量

黄 ★★ 重点

考点必背内容
会计概念以货币为主要计量单位,用专门方法对单位全部经济运动进行核算和监督的经济管理活动,通过确认、计量和报告为管理者提供决策信息
财务会计 vs 管理会计财务会计:对外(投资者、债权人、政府、社会公众),记已发生的业务,反映过去;管理会计:从财务会计分离出来,对内,服务编计划、作决策、控制活动
管理会计五内容预测分析、决策分析、全面预算、成本控制、责任会计
两项基本职能核算职能(最基本,特点:完整性、连续性、系统性)+ 监督职能(事前、事中、事后)
核算与监督关系核算是监督的前提,监督保证核算的正确性,不可分割
会计对象会计的客体,即会计所核算和监督的内容;以货币表现的经济活动 = 资金运动
资金运动三阶段投入(所有者投入 = 所有者权益,债权人投入 = 负债;分成流动资产和非流动资产)→ 循环与周转(供应、生产、销售)→ 退出(缴税、还债、分股利)
资金形态循环货币资金 → 储备资金(供应)→ 生产资金(生产)→ 成品资金(销售)→ 货币资金
经济业务事项分经济业务(与外部交换:买固定资产、卖商品、缴税)和经济事项(内部:发工资、报差旅费、计提折旧)
《会计法》规定应核算的六项资产的增减和使用;负债的增减;净资产(所有者权益)的增减;收入、支出、费用、成本的增减;财务成果的计算和处理;其他需办理会计手续的事项
会计目标会计工作预期达到的最终结果;我国企业会计目标:提供决策有用信息 + 反映管理层受托责任履行情况
会计信息三类财务状况(资产负债表)、经营成果(利润表)、现金流量(现金流量表)
会计信息使用者内部管理人员 + 外部利益关系人(投资者、债权人、政府及有关部门、社会公众、其他如监管部门和企业职工)
可靠性以实际发生的交易事项为依据,真实可靠、内容完整;包括真实性和客观性
相关性又称有用性:与使用者经济决策需要相关,有助于评价过去、现在或预测未来
清晰性又称可理解性:信息清晰明了,便于理解和使用
可比性同一企业不同时期一致(纵向,不得随意变更,确需变更附注说明)+ 不同企业同类业务口径一致(横向)
实质重于形式按经济实质而非法律形式确认计量报告;例子:融资租赁租入的固定资产视为企业资产
重要性反映所有重要交易事项;判断看性质和金额大小两方面;次要事项可简化合并
谨慎性又称稳健性:不高估资产或收益,不低估负债或费用;例子:存货成本与可变现净值孰低、计提坏账准备、加速折旧、计提减值准备;不允许设秘密准备
及时性已发生的交易事项及时确认计量报告,不得提前或延后

绿 ★ 会考的点

考点必背内容
会计法规体系以《会计法》为核心,以会计准则、财务规则、会计制度为主要内容
《会计法》地位我国会计工作的基本法律,会计法规体系中最高层次,制定其他会计法规的基本依据,指导会计工作的最高准则
会计准则也称会计标准;《企业会计准则》由财政部制定,分基本准则(一般原则 + 会计要素准则)和具体准则(基本业务、特殊业务、特殊行业基本业务准则)
事业单位/政府会计准则都是财政部制定的原则性规定
财务规则《行政单位财务规则》《事业单位财务规则》,财政部制定的一般规则
会计制度《企业会计制度》依据《会计法》;《政府会计制度》依据《会计法》《预算法》《政府会计准则》,都是财政部制定的具体核算制度

数字与公式清单

  • 会计 2 大分支:财务会计(对外)、管理会计(对内)
  • 会计 2 项基本职能:核算(最基本)、监督(事前、事中、事后)
  • 资金运动 3 步:投入、循环与周转(供应、生产、销售 3 阶段)、退出
  • 《会计法》规定应核算的经济业务事项 6 项
  • 会计信息 3 类内容对 3 张表:资产负债表、利润表、现金流量表
  • 会计要素 6 个:资产、负债、所有者权益、收入、费用、利润
  • 资产 3 特征、负债 3 特征、收入 3 特征、费用 3 特征;资产和负债的确认条件各 2 条,收入和费用的确认条件各 3 条
  • 所有者权益 4 项:实收资本(或股本)、资本公积、盈余公积、未分配利润
  • 会计等式:资产 = 负债 + 所有者权益;收入 − 费用 = 利润
  • 经济业务引起会计要素变动 9 种情况
  • 确认计量原则 4 个:权责发生制、配比、历史成本、划分收益性支出与资本性支出
  • 历史成本计价优点 4 条:金额客观易取得、有原始凭证可查证、防止随意更改、核算手续简化
  • 权责发生制例子:1 月付上半年租金 12000 元,每月记 2000 元,6 个月
  • 会计基本前提 4 个:会计主体、持续经营、会计分期、货币计量
  • 流动资产/流动负债的期限标准:资产负债表日起 1 年内(含 1 年)
  • 会计信息质量要求 8 条:可靠性、相关性、清晰性、可比性、实质重于形式、重要性、谨慎性、及时性
  • 会计法规 1 核心(《会计法》)+ 3 内容(准则、财务规则、制度)

4总结

一页纸看完整章。二轮快刷和考前只看这里和必背。

经济基础 第28章 会计概论 一页纸总结

本章一句话

会计就是用「钱」这把尺子,把一家单位的全部经济活动记下来、管起来(核算 + 监督)。记什么,靠六个会计要素分类(资产、负债、所有者权益、收入、费用、利润);怎么记,靠四条原则(权责发生制、配比、历史成本、划分收益性与资本性支出);在什么前提下记,靠四个假设(主体、持续经营、分期、货币计量);记出来的信息要合格,靠八条质量要求;整个行为受《会计法》为核心的法规体系约束。这是会计部分的开篇,后面第 29 到 31 章全建在这些概念上。

章末总览表

考点星级一句话要点考法
考点一 会计基本概念★★会计定义;财务会计对外、管理会计对内;核算(最基本)+ 监督(事前事中事后)两职能;会计对象 = 资金运动(投入、循环周转、退出);经济业务 vs 经济事项;《会计法》六项核算内容;会计目标、三类信息对三张表、两类使用者单选、多选(管理会计内容、职能特点、使用者分类常考)
考点二 会计要素★★★六要素定义、特征、分类、范围;资产负债表要素反映财务状况,利润表要素反映经营成果;流动/非流动项目归类;所有者权益四项;会计等式两条单选、多选(每年必考,项目归类和特征辨析是重灾区)
考点三 会计要素确认和计量基本原则★★★权责发生制(企业用,行政事业单位预算会计用收付实现制);配比;历史成本(取得时实际成本,减值可计提,不得自行调账面);收益性支出进利润表、资本性支出进资产负债表单选、多选(权责发生制判断题、支出划分后果常考)
考点四 会计基本前提★★★又称基本假设:会计主体(空间范围)、持续经营、会计分期(时间范围,年度和中期)、货币计量(假定币值不变)单选、多选(给一句话问属于哪个前提)
考点五 会计信息质量要求★★八条:可靠(真实 + 客观)、相关(有用)、清晰(可理解)、可比(纵向 + 横向)、实质重于形式(融资租赁)、重要性(性质 + 金额)、谨慎(稳健,不高估资产收益不低估负债费用)、及时单选、多选(给例子问体现哪条要求,「又称」配对)
考点六 会计法规★《会计法》为核心 + 准则、财务规则、制度;《会计法》是最高层次;准则分基本准则和具体准则;准则和制度都由财政部制定单选(法规层次、制定机关)

易错坑

  1. 「预付款项」是流动资产,「预收款项」是流动负债;「应收」在资产,「应付」在负债。看到「预」字先想是我先付钱(资产)还是别人先付钱给我(负债)。
  2. 收入的流入「不包括所有者投入资本」,费用的流出「不包括向所有者分配利润」。股东投钱进来不算收入,给股东分红不算费用。营业外收入算收入,营业外支出只算广义费用。
  3. 权责发生制不是所有单位都用:企业用权责发生制;行政事业单位的预算会计用收付实现制,财务会计用权责发生制。题目问「行政事业单位预算会计」答收付实现制。
  4. 收益性支出错按资本性支出处理,结果是少计费用、多计资产、利润「虚增」。资本性支出错按收益性处理,结果是多计费用、少计资产、利润「偏低」。哪边错、往哪边偏,先定方向再答。
  5. 四个「又称」和三个「最」别混:相关性又称有用性,清晰性又称可理解性,谨慎性又称稳健性,会计基本前提又称基本假设;核算是「最基本」职能,《会计法》是「最高层次」法规,利润是「最终」要素。

和前后章的关系

本章是第五部分「会计」的第一章,全是概念和框架,不算题。第 29 章会计循环把本章的「确认、计量、记录、报告」四个环节展开,权责发生制和会计要素在那里直接拿来用;第 30 章财务报表把本章的三张表(资产负债表、利润表、现金流量表)一张张讲;第 31 章财务报表分析再用报表算指标。本章的六要素和会计等式是后面三章的地基,先把这章的定义背熟,后面的表和分录才看得懂。

5解读(读透版讲义)

哪里没看懂,来这里看大白话讲解。生活例子、考法、坑都在这。可以先读这个再回去读教材。

会计概论(教材原文·OCR)

文字为主,公式/图表以教材扫描为准。配套精华看复习网页。

会计概论

万)
第二十八童

一会计基本概念

( 一)会计的概念

会计是以货币为主要计量单位,采用专门的技术方法,对单位的全部经济运动进行核算和
监督的一种经济管理活动 ,它通过系统.客观.及时地对单位的经济活动进行确认.计量和报告
来为管理者提供决策信息。

现代会计以企业会计为核心,按照对外提供还是对内提供决策所需的信息分成财务会计
与管理会计两大分支。

财务会计是以会计准则为主要依据,通过一定的程序和方法,确认计量企业资产.负债、
所有者权益的增减变动,记录营业收入的取得、费用的发生和归属,以及收益的形成和分配,定
期以财务报表的形式报告企业财务状况 .经营成果和现金流量,并分析报表,评价企业偿债能
力 营运能力和列利能力等的一套信息处理系统。财务会计的目的主要是向投资者债权人、
政府及有关部门和与企业有利害关系的社会公众等外部会计信息使用者提供企业生产经营活
动情况等信息,帮助使用者作出相关决策。财务会计主要是对企业已发生的经济业务进行事
后记录和反映,提供的信息是对过去生产经营活动的客观反映。

管理会计是从财务会计中分离出来的,它利用财务会计、统计及其他有关资料并通过对这
些资料进行整理.计算,对比和分析,产生一系列新的信息,用于满足企业内部管理人员编制计
划、作出决策 .控制经济活动等方面的信息需要,是服务于企业加强内部经营管理,加强决策控
制、提高经济效益需要的一套信息处理系统。管理会计主要包括预测分析 ,决策分析 全面预
算 .成本控制和责任会计等内容。

( 二)会计的基本职能

会计的职能是指会计在经济管理中所具有的功能,是会计本质的外在表现形式。会计具
有核算和监督两项基本职能。

  1. 会计的核算职能。会计的核算职能是指会计通过确认`计量,记录、报告 ,运用一定的方

法或程序,利用货币形式,从价值量方面反映企业已经发生或完成的客观经济活动情况,为经
济管理提供可靠的会计信息。核算职能是会计的最基本职能。会计不仅要记录已发生的经济
业务,也要记录正在发生的经济业务 ,为各单位的经营决策和管理控制提供依据。会计核算具

  1. 会计的监督职能。会计的监督职能是指在经济事项发生以前、经济事项进行当中和经

济事项发生以后,会计利用预算 .检查 ,考核.分析等手段,对单位的会计核算及其经济活动的
真实性 完整性、合规性和有效性进行检查与控制。会计监督包括事前`事中和事后监督。

会计的核算职能和监督职能是不可分割的。两者的关系是辩证统一的。对经济活动进行

计

第五部分 会

248 经济基础知识 (中级)

会计核算的过程,也是实行会计监督的过程,核算是基本的.首要的,核算是监督的前提,没有
会计核算,会计监督就失去了存在的基础; 同时,没有会计监督来保证会计核算的正确性,会计
核算就失去了存在的意义。

( 三)会计的对象

会计的对象即会计的客体,就是会计所核算和监督的内容。凡是特定对象能以货币表现
的经济活动 ,都是会计核算和监督的内容。企业中以货币表现的经济活动一般又称为资金运

以工业企业为例 ,工业企业是从事工业产品生产和销售的营利性经济组织 ,其再生产过程
是以生产过程为中心的供应,生产和销售过程的统一。为了从事生产经营活动,企业必须拥有
一定数量的资金,用于建造厂房 ,购买机器设备.购买原材料.支付职工工资 .支付经营管理过
程中各种必要的开支等; 生产出的产品经过销售后,收回的货款还要补偿生产经营过程中垫付

  1. 资金的投入。资金的投入包括企业所有者投入的资金和债权人投入的资金两部分,前

者属于企业所有者权益,后者属于企业债权人权益( 企业的负债 ) 投入企业的资金一部分构
成流动资产( 如货币资金 .原材料等 ),另一部分构成非流动资产( 如厂房.机器设备等 )。资金
的投入是企业资金运动的起点。

  1. 资金的循环与周转。企业将资金运用于生产经营过程,就形成了资金的循环与周转。

它又分为供应过程 ,生产过程 .销售过程三个阶段。

(1 1)供应过程。它是生产的准备过程。在这个阶段,为了保证生产的正常进行,企业需要
与供应单位发生货款的结算关系。随着采购活动的进行,企业的资金从货币资金形态转化为

(2 )生产过程。它既是产品的制造过程,又是资产的耗费过程。在这个阶段,劳动者借助
于劳动手段将劳动对象加工成特定的产品,企业要发生原材料等劳动对象的消耗 劳动力的消
耗和同定资产等劳动手段的消耗等,构成了产品的使用价值与价值的统一体。同时,随着劳动
对象的消耗,资金从储备资金形态转化为生产资金形态; 随着劳动力的消耗,企业向劳动者支
付工资 .奖金等劳动报酬,资金从货币资金形态转化为生产资金形态; 随着固定资产等劳动手
段的消耗,固定资产和其他劳动手段的价值通过折旧或推销的形式部分地转化为生产资金形

(3 )销售过程。它是产品价值的实现过程。在这个阶段,企业将生产的产品销售出去,取
得销售收入,发生货款结算等业务活动 ,资金从成品资金形态转化为货币资金形态。

由此可见,随着生产经营活动的进行,企业的资金从货币资金形态开始,依次经过供应过
程\生产过程和销售过程三个阶段,分别表现为储备资金.生产资金 .成品资金等不同的存在形
态,最后又回到货币资金形态,这种运动过程称为资金的循环。资金周而复始地不断循环,称

  1. 资金的退出。企业在生产经营过程中,为社会创造了一部分新价值,因此,企业收回的

货币资金一般要大于投入的资金,这部分增加招就是企业的利润。企业实现的利润,按规定应
以税金的形式上缴一部分给国家,还要按照有关合同或协议偿还各项债务,另外,还要按照企
业章程或董事会决议向投资者分配股利或利润。这样,企业收回的货币资金中,用于缴纳税
金 .偿还债务和向投资者分配股利或利润的这部分资金就退出了企业的资金循环与周转,剩余

第二让从章,会*计"概论 249,

的资金则留在企业 ,继续用于企业的再生产过程。

(四 )会计核算的具体内容

凡是特定主体能够以货币表现的经济活动,都是会计核算的内容。以货币表现的经济活
动通常又称为资金运动。资金运动是指以货币表现的一个单位所拥有的各项财产物资的形态
变化和位置移动。

通常将单位在日常生产经营和业务活动中的资金运动称为经济业务事项。经济业务事项
分为经济业务和经济事项。经济业务又称经济交易,是指单位与其他单位和个人之间发生的
各种经济利益的交换,如购买固定资产销售商品.上缴税收等。经济事项是指在单位内部发
生的具有经济影响的各类事项,如支付职工工资 .报销差旅费.计提折旧等。这些经济业务事
项就是会计核算的具体内容。

根据《中华人民共和国会计法》( 以下简称《会计法规定,应当办理会计手续,进行会计
核算的经济业务事项主要有: @资产的增减和使用; @和负债的增减; @净资产( 所有者权益 )
的增减; @收入支出、费用 .成本的增减; @财务成果的计算和处理; @和需要办理会计手续、进
行会计核算的其他事项。

二.会计目标

( 一)会计目标

会计目标是指会计工作预期达到的最终结果。企业经营者在企业经营管理活动中,经党
需要对一些重大问题作出决策。例如,在资金筹集活动中,要对筹集多少资金何时筹集资金、
从何处筹集资金等作出决策; 在内部投资活动中,要对企业进行何种类型投资.如何投资等进
行决策; 在生产经营活动中,要对生产什么产品.提供何种劳务.如何生产这些产品和如何提供
这些劳务作出决策; 在销售活动中,要对向谁销售产品和提供劳务 .以何种价格销售,怎样销售
作出决策; 在利润分配活动中,要对确定何种股利政策,如何进行股利分配等进行决策。

在市场经济条件下 ,会计的一般目标是向企业内部管理部门和企业外部与企业有利害关
系的主体提供决策所需要的会计信息及与之相关的其他财务信息。会计目标要解决的问题,
首先是谁需要会计信息,其次是需要什么样的会计信息。

我国企业会计的目标,一是通过会计活动,向会计信息使用者提供对决策有用的,与企业财
务状况.经营成果和现金流量等有关的会计信息,以帮助会计信息使用者作出经济决策; 二是反
上映企业管理层受托责任履行情况,有助于会计信息使用者评价企业的经营管理责任以及资源
使用的有效性。

( 二 )会计信息的内容

总体上说,企业会计信息的主要内容大致有以下三大类。

  1. 有关企业财务状况的信息,主要通过企业编制的资产负债表来反映。这类信息包括某

一时点资产的总额和结构,表明企业拥有或控制的资源及其分布情况; 某一时点负债总额及其
结构,表明企业未来需要多少资产或劳务来清偿债务以及清偿时间; 某一时点的所有者权益,
据以判断资本保值增值的情况以及对负债的保障程度。

  1. 有关企业经营成果的信息,主要通过利润表来反映。这类信息包括企业一定会计期间

的收入实现情况,一定会计期间的费用耗费情况和生产经营成果,据以判断企业实现总价值的
增减情况。

“ 250 经济基础知识(中级)

  1. 有关企业现金流量的信息,主要通过现金流量表来反映。这类信息包括一定会计期间

的现金或现金等价物的流动情况,经营活动,投资活动和筹资活动产生的现金流量及其内部组
成情况。

( 三)会计信息的主要使用者

企业会计信息的主要使用者包括企业内部管理人员和外部利益关系人两大类,企业外部
利益关系人主要有企业的投资者债权人、政府及有关部门.社会公众等,他们基于不同的需
求,需要不同的会计信息。

  1. 企业内部管理人员。企业管理人员为了内部管理和经营目的需要了解企业有关的会计

言息 ,如收入总额 ,利润情况.费用大小等,将其与同行业水平相比 .与本企业历史相比 .与先进
水平相比,可以找出差距,提出改进的方向和目标。通过对会计信息的分析使用,便于内部管
理人员根据实际情况及时作出相应决策,提高经营管理水平,提高经济效益。

  1. 外部利益关系人。会计信息的外部使用者主要是指企业外部的与企业有直接或间接利

害关系的单位和个人以及政府有关管理部门,包括: 四投资者; @债权人; 国政府及其有关部
门; 图社会公众; @其他使用者,如监管部门、企业职工。

三.会计要素

为了具体实施会计核算,需要对会计核算和监督的内容进行分类。会计要素是会计对象
按照交易或事项的经济特征所作的基本分类,是会计核算和监督对象的具体化。合理划分会
计要素,有利于清晰地反映产权关系和其他经济关系。会计要素分为反映企业财务状况的会
计要素和反映企业经营成果的会计要素。会计要素是组成会计报表的基本单位。我国企业会
计准则规定,企业会计要素包括资产.负债,所有者权益 .收入.费用和利润。资产、负债,所有
者权益是组成资产负债表的会计要素,也称资产负债表要素。其中资产是资金的占用形态,负
债和所有者权益是与资产相对应的取得途径,它们是反映企业财务状况的会计要素。而收入、
费用 ,利润则是组成利润表的会计要素,也称利润表要素。其中收入是经济活动中经济利益的
总流入,费用是经济活动中经济利益的总流出,收入与费用相配比,即形成经济活动的利润,利
润是资金运用的成果 ,它们是反映企业经营成果的会计要素。

( 一)反映财务状况的会计要素

  1. 资产。资产是指企业过去的交易或者事项形成的由企业拥有或者控制的,预期会给企

业带来经济利益的资源。资产具有以下几个方面的特征:

(1 )资产必须是企业拥有或控制的资源,指企业享有某项资源的所有权 ,或者虽然不享有
某项资源的所有权 ,但该资源能被企业所控制。

(2 )资产必须是预期能够直接或间接给企业带来经济利益的,只有能给企业带来现金流
入和经济利益的资源才可以作为资产; 如果某项资产不能为企业带来经济利益,即使是由企业
拥有或者控制的,也不能作为企业的资产,而应确认为损失,如竺处理的无价值的报废产品等
不能作为企业的资产。

(3 )形成资产的交易或事项必须已经发生,即资产必须是现实的资产,是由企业过去的交
易或者事项,如购买.生产建造行为或其他交易或者事项形成的,而不是预期的资产,预期在
未来发生的交易或者事项不形成资产。例如,企业购入的原材料 .固定资产.委托加工材料 .应
收账款等都属于企业的资产 ,而计划购买的机器设备等尚未购置的则不能作为企业的资产。

第二让从章“会<计"概"论 251,

将一项资源确认为资产,需要符合资产的定义,并同时满足以下两个条件: 一是与该资源
有关的经济利益很可能流入企业,二是该资源的成本或者价值能够可靠地计量。

资产按流动性分类可分为流动资产和非流动资产。流动资产是指预计在一个正常营业周
期中变现、出售或耗用,或者主要为交易目的而持有,或者预计在资产负债表日起 1 年内( 含
1 年 )变现的资产,以及自资产负债表日起 1 年内交换其他资产或清偿负债的能力不受限制的
现金或现金等价物。流动资产主要包括货币资金,交易性金融资产 应收票据及应收账款、预
付款项其他应收坎 ,存货等。非流动资产是指流动资产以外的资产,主要包括长期股权投资、

符合资产定义和资产确认条件的项目,应当列人资产负债表; 符合资产定义,但不符合资
产确认条件的项目,不应当列人资产负债表。

  1. 负债。负债是指过去的交易,事项形成的,预期会导致经济利益流出企业的现时义务。

它是企业所承担的能以货币计量,需以资产或劳务偿还的债务。负债具有以下特征:

(1 )企业的负债只能由过去的交易活动或本期经济业务所形成,且必须于未来某一特定
时期予以清偿的现时义务 ,不需要未来偿还的现时义务或企业在将来要发生的交易或者事项
形成的义务不属于负债,如企业从银行借和人贷款即形成企业的负债,企业与供应商签订的在未
来可能形成负债的采购合同 ,在当前就不能作为负债。

(2 )负债必须有其可用货币额反映的价值量,不能用货币计量的不能作为负债。

(3 )负债的偿还不论是以资产偿还,还是以提供劳务偿还或是转让股权给债权人,必须是
企业现行条件下已承担的预期都会造成经济利益流出企业的现时义务。

符合负债定义的义务 ,在同时满足以下两个条件时 ,确认为负债: 一是与该义务有关的经
济利益很可能流出企业,二是未来流出的经济利益的金额能够可靠计量。

负债按流动性分类可分为流动负债和非流动负债。流动负债是指预计在一个正常营业周
期中清偿,或者主要为交易目的而持有,或者自资产负债表日起 1 年内(含 1 年 )到期应耶以
清偿或者企业无权自主地将清偿推迟至资产负债表日后 1 年以上的负债。流动负债主要包括
短期借款 应付票据及应付账款、预收款项 应付职工薪酬 .应交税费,其他应付款等。非流动
负债是指流动负债以外的负债,主要包括长期借款,应付债券等。

符合负债定义和负债确认条件的项目,应当列入资产负债表; 符合负债定义,但不符合负
债确认条件的项目 ,不应当列人资产负债表。

  1. 所有者权益。所有者权益又称为股东权益,是指企业资产扣除负债后由所有者享有的

剩余收益。所有者权益是投资人在企业中享有的经济利益,即投资人对企业净资产的所有权。
所有者权益的来源包括所有者投入的资本,直接计人所有者权益的利得和损失 .留存收益等。
利得是指由企业非日常活动所发生的会导致所有者权益增加的,与所有者投入资本无关的经
济利益的流入。损失是指由企业非日常活动所发生的、会导致所有者权益减少的、与向所有者
分配利润无关的经济利益的流出。

所有者权益的确认主要依赖于其他会计要素,尤其是资产和负债的确认; 其金额的确定
取决于资产和负债的计量。

所有者权益包括实收资本(或股本 )资本公积、列余公积和未分配利润。其中资本公积
包括企业收到投资者出资超过其在注册资本或股本中所占份额的部分,以及直接计和人所有者
权益的利得和损失等; 盈余公积和未分配利润又合称为留存收益,是企业历年实现的净利润留
存于企业的部分。

252 ', ”经济基础知识(中级)
所有者权益项目应当列人资产负债表。
会计要素的角度来看,负债和所有者权益同为企业资产的取得来源,两者都可以对企
业资产提出索偿要求,但负债体现的是债权人对企业资产的索偿权,它是企业所承担的现时义

定条件支付利息,债权人不参与利润分配,在企业清算时需要优先清偿,净资产在清偿所有负
债后才可以返还给投资人; 而所有者权益则是投资人对总资产扣除负债后的剩余净资产的索
偿权,投资人在一般情况下不需要企业归还其投资,也不需要支付利息,只是要参与企业利润
分配,以利润分配作为回报。

( 二)反映经营成果的会计要素

1收入。收入是指企业在日常活动中形成的,会导致所有者权益增加的.与所有者投入资
本无关的经济利益的总流入。收入具有以下特征: @收入应当是企业在日常活动中形成的;
四收入应当会导致企业经济利益的流人,该流人不包括所有者投入资本; @收入应当最终会导
致所有者权益的增加。符合收入的定义,同时符合下列条件的经济利益的流入,可以确认为收
入:一是与收入有关的经济利益很可能流入企业,二是经济利益流入企业会导致企业资产增加
或者负债减少,三是经济利益的流入额能够可靠计量。

由于销售商品、提供劳务及让渡资产使用权等日常经营活动所发生的或即将发生的经济
利益的流入,包括营业收入、投资收益和营业外收入 ,都属于企业的收入。收入是企业持续经
营的基本条件,也是企业获得利润的前提条件。收入是企业的日常经营活动中产生的,而不是
从偶发的交易或事项中产生的。收入可能表现为企业资产的增加,也可能表现为企业负债的
减少,或者兼而有之。收入能导致企业所有者权益的增加。只有流入本企业的经济利益才属
于本企业的收入 ,为第三方代收的款项不属于本企业的收入。

符合收入定义和收入确认条件的项目 ,应当列人利润表。

  1. 费用。费用是指企业在日常活动中发生的、会导致所有者权益减少的.与向所有者分配

利润无关的经济利益的总流出。费用具有以下特征:

(1 )费用应当是企业在日常活动中发生的。

(2 )费用应当会导致经济利益的流出,该流出不包括向所有者分配的利润。

(3 ) 费用应当最终会导致所有者权益的减少。符合费用的定义 ,并符合以下条件的经济
利益的流出,可以确认为费用: 一是与费用有关的经济利益很可能流出企业,二是经济利益流
出企业的结果会导致企业资产减少或者负债增加, 三是经济利益的流出额能够可靠计量。

企业为生产产品提供劳务等发生的可归属于产品成本 劳务成本的费用,应当在确认产
品销售收入`劳务收入时,将已销售产品 `已提供劳务的成本计人当期损益。企业发生的支出
不产生经济利益的,或者即使能够产生经济利益但不符合或者不再符合资产确认条件的,应当
在发生时确认为费用,计人当期损益。企业发生的交易或者事项导致其承担了一项负债而又
不确认为一项资产的,应当在发生时确认为费用,计入当期损益。

企业要进行经营活动,在取得收入的同时必然要相应地发生一定的费用。狭义的费用是
指为取得收入而发生的各种与提供商品和劳务有关的资产耗费,即营业费用; 广义的费用还包
括投资损失 ,营业外支出和所得税费用。

营业费用是企业费用的主体部分,按照是否构成产品成本,工业企业的营业费用可分为
制造成本和期间费用。制造成本是指与生产产品直接有关的费用,应计和人产品成本,从销售收
入中得到补偿。期间费用是指与生产产品无直接关系,属于某一时期耗用的费用,包括管理费

第二中并章,会<计"概论 253,

用、研发费用、财务费用和销售费用等。期间费用不参与成本计算,而是直接计人当期损益。
费用通常是为取得营业收入而发生的耗费,可以表现为资产减少或负债增加。费用是对耗费
的计量,这种耗费并不一定表现为当期直接发生的支出,有些耗费是通过系统合理地分配而形
成的,如固定资产折旧费用长期待挫费用摊销等。费用与成本是相互联系又相互区别的两个
概念,为生产某产品发生的生产费用是构成该产品成本的基础。两者的区别在于费用是按照
时间归集的,而产品成本是按照产品对象归集的。

符合费用定义和费用确认条件的项目,应当列和人利润表。

  1. 利润。利润是指企业在一定会计期间内的经营成果,是企业在生产经营过程中各种收

入扣除各种费用后的盈余,是反映经营成果的最终要素。利润反映的是企业的经营业绩情况,
是业绩考核的重要指标。

利润包括收入减去费用后的净额,直接计和人当期利润的利得和损失等。其中收入减去费
用后的交额反映的是企业日常活动的业绩; 直接计人当期利润的利得和损失,是指应当计和信当
期损益 .最终会引起所有者权益发生增减变动的.与所有者投入资本或者向所有者分配利润无
关的利得和损失 ,它反映的是企业非日常活动的业绩。

利润的确认主要依赖于收入和费用以及利得和损失的确认,其余额的确定取决于收入和
费用 直接计入当期利润的利得和损失金额的计量。利润项目应当列和利润表。

( 三 )会计等式

以上六个会计要素相互之间存在着一定的数量关系。反映这种数量关系的恒等式,即为

资产和负债,所有者权益是财产资源这个同一体的两个方面,因而客观上存在必然相等的
关系。从数量上看,有一定数额的资产,必定有一定数额的负债和所有者权益; 反之,有一定数
额的负债和所有者权益,也必定有一定数额的资产,资产与负债和所有者权益之间在数量上必

资产 = 权益 = 债权人权益 + 所有者权益 = 负债 + 所有者权益

这一平衡公式反映了企业资产的归属关系。企业的资产来源于所有者的投入资本和债权
人的借入资金,以及企业在生产经营中所产生效益的积累,分别归属于所有者和债权人,归属
于所有者的部分形成所有者权益,归属于债权人的部分形成债权人权益,即企业的负债。资产
来源于权益,包括所有者权益和债权人权益 ,资产与权益必然相等。在某个特定的时点,资产
与负债和所有者权益三者之间所存在的平衡关系,是复式记账法的理论基础,也是编制资产负

与此相对应,企业收入是其日常活动中形成的经济效益的总流入,费用是企业在日常经营
活动中发生的经济效益的总流出,企业一定时期的收入扣除所发生的各项费用后的净额,经过
调整后等于利润。在不考虑调整因素,如直接计和人当期利润的利得和损失等情况下 ,收入减去
费用等于利润。

收入-费用=利润

这一平衡公式反映了企业利润的形成过程,收入、费用和利润之间的上述关系是编制利润
表的基础。

企业在经营过程中不断发生各种经济业务 ,这些业务的发生会对有关会计要素产生影响。
但无论发生什么经济业务 ,都不会破坏上述资产与负债和所有者权益各会计要素之间的平衡

"254 , ”经济基础知识(中级)

由于这一平衡原理揭示了企业会计要素之间的规律性联系,因而它是设置会计科目 .复式
记账和编制会计报表的理论依据。

( 四 )经济业务发生所引起的会计要素的变动

经济业务发生所引起的会计要素的变动,主要是下列九种情况:

(1 )一项资产和一项负债同时等额增加。

(2 )一项资产和一项所有者权益同时等额增加。

(3 )一项资产和一项负债同时等额减少。

〈《4)一项资产和一项所有者权益同时等额减少。

(5 )一项资产增加,另一项资产等额减少,负债和所有者权益要素不变。

《6 )一项负债增加,另一项负债等额减少,资产和所有者权益要素不变。

《7 )一项负债增加,另一项所有者权益等额减少,资产要素不变。

(8 )一项负债减少,另一项所有者权益等额增加,资产要素不变。

《9 )一项所有者权益增加,另一项所有者权益等额减少,资产和负债要素不变。

四,会计要素确认和计量基本原则

会计要素确认和计量的原则是指为了使会计信息能达到质量标准,而对会计核算所作的
一般规范,这些原则是会计核算 .计量记录、报告的基础,是确认一定会计期间的收入和费用
从而确认损益的基础。

( 一 )权责发生制原则

由于经济活动是持续进行的,而会计核算是分期进行的,在会计期间实现的收益和发生的
费用,有些在相邻的会计期间是相互交错的。由于会计分期的假设,产生了本期与非本期的区
别,企业在一定会计期间为进行生产经营活动而发生的费用,可能在本期已经付出货币资金,
也可能在本期尚未付出货币资金; 所形成的收入,可能在本期已经收到货币资金,也可能在本
期尚未收到货币资金。同时,本期发生的费用可能与本期收入的取得有关,也可能与本期收入
的取得无关。通常,企业用来确认一定会计期间的收入和费用,从而确定损益的标准有两种。

一种是权责发生制,也称应计制。权责发生制要求,凡是当期已经实现的收入和已经发
生或应当负担的费用,不论款项是否收付,都应当作为当期的收入和费用; 凡是不属于当期的
收入和费用,即使款项已在当期收付,也不应当作为当期的收入和费用。即企业是按收入的
权利和支出的义务是否属于本期,而不是按是否在本期实际收到款项来确认收入费用的人
账时间。例如,某企业 1 月份支付上半年的设备租金 12000 元,由于此项费用的受益期是上
半年,即 1一6 月,所以,该企业在 1 月份支付租金时并不是全部计入 1月份的费用中,而是在
1一6 月中每月记录费用 2000 元。

另一种是收付实现制,也称现金制。收付实现制要求,凡是本期实际收到款项的收入,不
论其应否归属于本期,均应作为本期的收入处理; 凡是本期实际以款项支付的费用,不论其应
否在本期收入中得到补偿,均应作为本期的费用处理。即企业是以收到款项或支付款项作为
确认收入费用的基础,而不是按收入的权利和支出的义务是否属于本期来进行确认。如上述
1 月份支付上半年的租金,此费用发生在 1 月份,虽然 ]一6 月都受益,但都直接计入 1 月份费
用中。一个单位在确定会计记账基础时要充分考虑其所处行业的特点和会计信息使用者的不
同需要 ,按照重要性原则加以确定。为了正确反映企业的经营成果,通常情况下应按权责发生

第二让从章“会<计"概"论 257,

制进行确认和计量。

我国《企业会计准则》规定,企业会计的确认、`计量和报告应当以权责发生制为基础。而
我国行政事业单位预算会计核算采用收付实现制,财务会计核算采用权责发生制, 国务院丸有
规定的,依照其规定。

(二)配比原则

配比原则是指对一个会计期间的收入和与其相关的成本 `费用应当在该会计期间内确认,
并应相互配比,以便计算本期损益。

在会计实务中 ,收入与费用的配比方式主要有两种: 一种是根据收入与费用之间的逻辑因

果关系进行直接配比,如主营业务收入与直接成本相配比; 另一种是根据收入与费用项目存在
的时间上的一致关系,将某些与特定收入项目没有明显因果关系的费用项目,如广告费办公
费和管理人员工资等期间费用,与发生在同一时间的收入相配比。配比原则要求在会计核算
中,一个会计期间内的各项收入及与其相关的成本费用,应当在同一会计期间内进行确认、计
量和记录,而不能提前或延后,否则就会造成经营成果虚假不实。对于一切预支款项的成本、
费用,要递延到有关的收入取得时才能计列; 对于与本期收入有关的一切未来费用,则应在本
期内预提,以达到配比的目的。

( 三 )历史成本原则

历史成本原则又称实际成本原则或原始成本原则,是指企业各项财产在取得时应当按照
实际成本计量,其后各项财产如果发生减值,应当按照规定计提相应的减值准备,除法律 .行政
法规和国家统一的会计制度另有规定者外,企业一律不得自行调整其账面价值。

采用历史成本计价的优点在于: 一是它是买卖双方通过正常交易确定的金额,或资产购
进过程中实际支付的金额,取得比较容易,也比较客观; 二是有原始凭证作证明,便于查证;
三是可以防止企业随意更改; 四是会计核算手续简化,不必经常调整账目。历史成本原则是以
币值稳定为前提的。在历史成本原则下 ,如果企业的资产发生了较大的价值变化,其账面价值
就不能反映其实际价值,就不能提供正确的会计信息。

( 四 )划分收益性支出与资本性支出原则

划分收益性支出与资本性支出原则是指企业的会计核算应当合理划分收益性支出与资本
性支出的界限。收益性支出是指在本期发生的只与本期收益有关的,应当在本期已实现的收
益中得到补偿的支出; 资本性支出是指在当期发生的不但与本期收益有关而且与以后会计期
间收益也有关的,应当在以后若干会计期间的收益中得到补偿的支出。划分收益性支出与资
本性支出原则要求,凡为取得本期收益而发生的支出,即支出的效益仅惠及本会计年度( 或一
个营业周期 )的,应当作为收益性支出,计入当期损益 ,并在利润表中反映; 凡是为以后各期取
得收益而发生的各种资产支出,即支出的效益惠及几个会计年度( 或几个营业周期 )的,应当
作为资本性支出,列人资产,在资产负债表中反映,并根据其与以后各期收益的关系,将其价值
分摊到以后各个会计期间。

划分收益性支出与资本性支出的目的在于正确确认企业的当期损益。如果一笔收益性支
出按资本性支出处理了,就会造成少计费用而多计资产价值 ,出现净收益和资产价值虚增的现
象。相反,如果一笔资本性支出按收益性支出处理了,则会出现多计费用而少计资产价值的现
象,出现当期净收益降低甚至亏损,以及资产价值偏低的结果。

.256 ”经济基础知识 (中级)

五会计基本前提

会计基本前提又称会计基本假设,是指为了保证会计工作的正常进行和会计信息的质量,
对会计核算的范围.内容,基本程序和方法所作的限定,即面对变化不定的社会经济环境,会计
人员对某种情况按进行会计工作的先决条件所作出的合理推断或人为规定,是组织会计核算
工作的基本前提。会计的基本前提包括会计主体 .持续经营 .会计分期.货币计量。

( 一)会计主体

会计主体是指会计确认,计量和报告的空间范围,是会计所服务的特定单位。会计是在每
一个会计主体中进行的。会计核算应当以一个特定独立的或相对独立的经营单位为对象,所
以会计主体一般是在经济上独立或相对独立可以单独进行确认计量的单位。在会计主体假
设下,企业应当对其本身发生的交易或者事项进行会计确认、`计量和报告,反映企业本身所从
事的各项生产经营活动。明确界定会计主体,是会计核算的重要前提,是为了把会计主体的经
济业务与其他会计主体以及投资者的经济业务划分开。会计主体确定之后,会计人员只是站
在特定会计主体的立场,核算特定主体的经济活动。会计主体不同于法律主体,一般来说,法
律主体必然是会计主体,但会计主体可以是一个独立的法律主体,也可以不是一个独立的法律
主体,会计主体可以是营利性组织,也可以不是营利性组织,如行政事业单位企业 企业的分
支机构、企业内部相对独立的某个生产车间、可以作为费用报销单位的企业内部职能部门 .由
多个法人组成的企业集团 .合伙组织等。但是,作为一个会计主体,必须有独立的资金活动 ,独
立地进行核算,可以独立编制财务报告。

会计主体规定了会计核算内容的空间范围,这一前提就是要明确会计所提供的信息,特别
是会计报表,反映的是特定会计主体的财务状况与经营成果 ,这一前提要求在会计核算中既不
能将本会计主体与其他会计主体混淆,也不能将本会计主体的会计事项遗漏或转移。

( 二 )持续经营

持续经营是指会计核算应当以持续正常的生产经营活动为前提,在可以预见的将来,企
业将会按当前的规模和状态继续经营下去 ,而不考虑企业停业或破产清算,也不考虑企业大规
模削减业务 ,所持有的资产将正常营运,所负有的债务将正常偿还。明确持续经营这一前提,
就意味着会计主体将按照既定的用途使用资产 ,按照既定的合约条件清偿债务,会计人员在此
基础上选择会计政策和会计估计方法。会计主体确定后,只有假定这个作为会计主体的企业
是持续正常经营的,假定在可以预见的未来,企业将以既定的经营方针和目标持续经营下去,
而不会面临破产清算 ,会计原则和会计程序才可能建立在正常非清算的基础之上 ,这样才能保
持会计信息处理的一致性和稳定性,才能建立起诸如历史成本原则 、权责发生制原则等会计确
认和计量的一般原则,固定资产才能根据历史成本进行记录,并按期计提折旧,将历史成本分
摊到各个会计期间或相关产品的成本中。企业在信息的收集和处理上所采用的会计方法才能
保持稳定,会计核算才能正常进行。例如,只有在持续经营的前提下 ,企业的资产和负债才区
分为流动的和长期的; 企业资产才能以历史成本计价,而不是以现行成本或清算价格计价; 才
有必要和可能进行会计分期,并为采用权责发生制商定基础; 才使正确区分资本与负债成为必

( 三 )会计分期

会计分期又称会计期间,是指将一个企业持续不断的生产经营活动期间,划分为若干连

第二记关章 会<许"概-论 .257,

续的.等距的会计期间,以便分期结算账目,计算盈亏,按期编制会计报表,从而提供有用的会
计信息。会计分期是建立在持续经营基础上的。会计期间就是在会计工作中为核算生产经营
活动或预算执行情况所规定的起该日期,一般分年度和中期。在我国,年度和中期均按公历起
该日期确定,中期一般是指短于一个完整的会计年度的报告期间。明确会计期间这个前提,才
产生了当期和以前期间`以后期间的差别,才使不同类型的会计主体有了会计确认和计量的基
准,产生了收付实现制和权责发生制,才能正确贯彻配比原则。只有正确地划分会计期间 ,才
计生 经营成果的资料,才能进行会计信息的对比。

(四)货币计量

人最是车企业在 进行会计确认 计量和报告时采用货币为主要计量单位进行记录,反
映企业的财务状况.经营成果和现金流量,并假定货币的币值保持不变。

对企业经济活动的计量,可以采用多种计量单位,如实物数量货币.重量长度,体积等,
由于各种经济活动的非货币计量单位,具有不同的性质,在量上无法比较,为了连续系统、全
面、综合地反映企业的经济活动,会计核算客观上需要一种统一的计量单位作为会计核算的计
量尺度,货币作为一般等价物,是衡量商品价值的共同尺度,自然被选择作为会计核算的计量
单位。明确货币计量这一前提,才能对所有会计对象采用同一种货币作为统一尺度来进行计
量,并把企业经营活动和财务状况的数据转化为按统一货币单位反映的会计信息。我国《企

会计准则》规定,企业会计应当以货币计量。以货币作为统一计量单位,还包含着币值稳定
的候设, 当货币本身的价值波动不大,或前后波动能够被抵消时,会计核算中认为币值是基本
稳定的,而不考虑货币价值的波动因素。当然,货币计量的假设并不表示货币是会计核算中唯
一的计量单位,有时在会计核算中也辅以实物数量等计量单位。

综合上述会计核算的四个基本前提说明,会计要确定会计所服务的特定单位和范围,采

货币这一统一尺度 ,在持续经营条件下选择恰当的会计方法对日常的经济业务进行确认、计
量, 重生下项间定期编币出完交天克的会 计报表,就构成了企业开展会计工作 组织会计核
算的前提条件和理论基础。

六、会计信息质量要求

企业进行会计核算,对外提供会计信息,应当满足一定的要求。提供满足要求的会计信

息 ,需要坚持一定的标准,这些标准是处理具体会计业务的基本要求,是在会计核算前提条件
制约下, 进行会计核算的标准和质量要求。我国《企业会计准则 》要求企业提供会计信息时满
足以下质量要求。

(一)可靠性

可靠性要求企业应当以实际发生的交易或者事项为依据进行会计确认、`计量和报告,如实
反映符合确认和计量要求的各项会计要素及其他相关信息,如实反映企业的财务状况 .经营成
果和现金流量,保证会计信息真实可靠、内容完整。 可千性包括真实 性和客观性两方面含义,
真实性要求会计核算所提供的会计信息,应当真实反映企业实际的财务状况和经营成果; 客观
全 经济业务的记录和核算 .报告必须建立在可查证的基础上,以客观事实为依据,不能

为凭空编造,并且项目完整 .手续完备。在实际会计核算工作中,用作证明客观事实计量依
从 芋要是扣各利原志人 任证和仪表记录等。

258 经济基础知识(中级)

( 二 )相关性

相关性又称有用性,要求企业提供的会计信息应当与财务会计报告使用者的经济决策需
要相关,有助于财务会计报告使用者对企业过去 现在或者未来的情况作出评价或者预测,有
助于信息使用者作出经济决策。会计目标就是为有关方面提供经济信息,而要发挥好会计信
上息的作用,就必须使提供的信息能够作为会计信息使用者进行决策和分析的依据,便于信息使
用者有效使用。这就要求会计在收集,处理、传递信息的过程中,考虑有关方面对会计信息的
要求,以确保提供的信息与信息使用者的要求相关并且有用。

( 三 )清晰性

清晰性又称可理解性,要求会计提供的会计信息应当清晰明了,便于财务会计报告使用者
理解和使用。要求企业提供的数据记录和文字说明能清楚地反映经济活动及其结果的基本情
况,并对需要解释的问题作出必要的说明。

提供会计信息的目的是要使用这些信息,要使用,就必须先了解会计信息的内容,否则就
谈不上会计信息的使用,这就要求会计所提供的信息必须清晰简明、易仅,能为大多数使用
者所理解,对复杂的经济业务应该用规范文字加以表述,以便有关部门和人员正确理解,合理
利用。

(四 )可比性

可比性要求企业提供的会计信息应当具有可比性。一方面要求同一企业不同时期发生的
相同或者相似的交易或者事项,应当采用一致的会计政策,不得随意变更; 确需变更的,应当在
附注中说明, 以便进行不同时期的纵向比较。另一方面要求不同企业发生的相同或者相似的
交易或者事项,应当采用规定的会计政策和会计处理办法,确保会计信息口径一致,以便在不
同企业之间进行横向比较。

( 五 )实质重于形式

实质重于形式要求企业应当按照交易或事项的经济实质进行会计确认`计量和报告 ,而不
应当仅仅以交易或者事项的法律形式为依据。

在实际工作中,交易和事项所表现出来的外在法律形式并不总能完全真实地反映其实质
内容。所以,会计确认`计量和报告时应当根据名 和的 济现实来进行,而不能仅
仅根据它们的法律形式进行。如以融资租赁方式租入的固定资 产 最村全上相关不胡

其所有权,但由于租赁合同中规定的租赁期较长.接近于该资产的使用放命,租作期清承租企
业有优先购买该资产的选择权,在租赁期内承租企业有权支配资产并从中获取收益,所以,从
经济实质上,企业拥有该资产的实际控制权 ,在会计核算上就将其视为企业的资产。只有这
样,才有利于会计信息使用者依据企业的财务状况和经营成果等作出决策。

( 六 )重要性

重要性要求企业提供的会计信息应当反映与企业财务状况、经营成果和现金流量等有关
的所有重要交易或者事项。在会计核算过程中对交易或事项应当区别其重要程度,采用不同
的核算方式。会计报表在全面反映企业财务状况和经济成果的同时,对于对资产 .负债 .损益
等有较大影响 ,并进而影响财务会计报告使用者据以作出合理判断的重要的会计事项必须按
照规定的方法和程序进行处理,并在财务会计报告中予以充分、准确的披露; 而对次要的会计
事项,在不影响会计信息真实性和不至于误导财务会计报告使用者作出正确判断的前提下 ,可
适当简化或合并反映。重要性要求每个企业都要根据会计事项对信息使用者进行决策的影响
程度来确定自己的重要会计事项,根据会计事项的重要程度,采取不同的核算方式和不同的核

第二丰闪章 :会<计*概<“论 259,

算精度。

凡是一旦省略和错报就会影响使用者据此作出经济决策的,该项会计信息就具有重要性。
在实际工作中 ,重要性的应用需要依赖职业判断,企业应当根据其所处的环境和实际情况,从
项目的性质和金额大小两方面来判断其重要性。一般情况下 ,与决策者的利益关联度高的和
金额占总业务量比重较大的项目应当作为重要项目在财务报表上进行反映。

( 七 )谨慎性

谨慎性又称稳健性,要求企业对交易或者事项进行会计确认、`计量和报告时应当保持应
的谨慎,不应高估资产或者收益,低估负债或者费用。例如,某一 全业务有光阳直理广法
供选择时 ,应选择采取一种不导致夸大资产、虚增账面利润.扩大所有者权益的方法。对于预
计会发生的损失应计算入账,对于可能产生的收益则不预计人账。谨慎性原则在会计上的应
用是多方面的,如采用成本与可变现净值训低法对存货进行期末计价 ,对应收账款计提坏账准
备,固定资产采用加速折旧法,对可能发生的资产损失计提减值准备等。但是,谨慎性原则的
应用并不允许企业设置秘密准备。

(八)及时性

及时性要求企业对于已经发生的交易或者事项,应当及时进行会计确认、`计量和报告 ,不
得提前或者延后。及时性要求收集会计信息要及时,对会计信息进行加工处理和传递给信息
使用者都要及时 ,以满足各方面信息使用者的决策需要。

七会计法规

会计法规是指规范财务会计实务的法律 法规、准则和制度等的总称,它是约束会计行为
的标准,又是评价会计工作的依据。我国现行的会计法规以《会计法》为核心,以会计准则 、财
务规则 人会计半》

《会 AR 计工作的基本法律,是我国会计法规体系中处于最高层次的法律规
范,是制定其他会计法规的基本依据,也是指导会计工作的最高准则。《会计法》对我国会计
工作的主要方面作出了规定,涉及我国会计工作的各个方面。该法对我国会计工作的地位和
作用进行了说明 ,并对我国会计管理的体制 .会计核算和会计监督的对象及内容 会计机构 .会
计人员的职责和权限以及有关的法律责任作出了明确的规定。

( 二)会计准则

会计准则也称会计标准,是制定会计核算制度和组织会计核算工作的基本规范。

1《企业会计准则》 我国的《企业会计准则》由财政部制定,包括基本;准则和具体准则两

(1 )基本准则。基本准则主要是为规范会计确认、`计量和报告行为,保证会计信息质量而

会计核算的一般要求和会计核算的主要方面作出原则性规定,为具体准则的制定提供依据。
让和人 计核算的一般原则和会计要素准则。

(2 )具体准则。具体准则是根据基本准则的要求,对企业各种经济业务的会计处理方法
和程序作出具体规定,包括基本业务准则 ,特殊业务准则和特殊行业基本业务准则。

2《事业单位会计准则《事业单位会计准则》是财政部制定的规范事业单位会计核算,
保证会计信息质量的原则性规定。它主要对事业单位会计核算的目标 .前提.会计要素 会计

' 260 , 经济基础知识(中级)

息质量要求、财务会计报告等作出了规定。


零基础复习卡(两版教材核验)

来源核验:主教材《2026经济基础知识中级原书有色差(371)》PDF 第258-271页;《经济基础知识(中级)-292》PDF 第200-210页(书内第192-202页)。

一句话先懂

会计就是用统一规则把企业的资金运动“认出来、算清楚、记下来、报出去”,同时监督经济活动是否合法、合理、有效。

零基础解释

  1. 两项基本职能:核算职能贯穿确认、计量、记录和报告;监督职能可发生在事前、事中和事后。核算是基础,监督是保障。
  2. 核算对象:企业能以货币表现的经济活动,即资金投入、循环周转和退出。
  3. 会计目标:向信息使用者提供财务状况、经营成果和现金流量信息,帮助决策,并反映管理层受托责任履行情况。
  4. 六大会计要素:资产、负债、所有者权益描述某一时点的财务状况;收入、费用、利润描述一定期间的经营成果。
  5. 两个恒等式:`资产=负债+所有者权益` 是复式记账和资产负债表的基础;`收入-费用=利润` 是利润表的基础。
  6. 确认基础:权责发生制看权利义务是否发生,不看钱何时收付;收付实现制看现金实际收付。
  7. 四项基本假设:会计主体划范围、持续经营定前提、会计分期切时间、货币计量统一尺度。

必背清单

  • 资产:过去形成、企业拥有或控制、预期带来经济利益。
  • 负债:过去形成、企业承担的现时义务、预期导致经济利益流出。
  • 所有者权益=`资产-负债`,包括投入资本、直接计入权益的利得和损失、留存收益等。
  • 收入来自日常活动并导致权益增加;费用来自日常活动并导致权益减少;所有者投入、分配利润不算收入费用。
  • 会计信息质量八项:可靠、相关、可理解、可比、实质重于形式、重要、谨慎、及时。
  • 谨慎性不允许秘密准备、故意低估资产或收入,也不允许故意高估负债或费用。

易混点

  • 会计主体不必等于法律主体:集团可作为会计主体,但不一定是独立法人;法人一般是会计主体。
  • 收入不等于收款,费用不等于付款:权责发生制下可能先确认后收付。
  • 利得/损失不一定来自日常活动;收入/费用强调日常活动。
  • 可靠性与谨慎性不冲突:谨慎是在不确定情况下不高估,不是任意压低利润。

记忆口诀

  • 四假设:“主体画圈、持续不断、分期切段、货币统一”。
  • 八质量:“可(可靠)相(相关)理(可理解)比,实重谨时”。
  • 六要素:“资负权看家底,收费用看成绩”。

自测题

  1. 判断:企业已经提供服务但尚未收款,权责发生制下一定不能确认收入。

答案:错。 符合收入确认条件即可确认,不以是否收款为唯一标准。

  1. 单选:把企业与投资人个人收支分开,依据的是( )。A持续经营 B会计主体 C会计分期 D货币计量

答案:B。 会计主体界定核算空间范围。

  1. 多选:反映某一时点财务状况的要素有( )。A资产 B负债 C所有者权益 D收入 E费用

答案:ABC。 收入、费用、利润是期间要素。

  1. 判断:所有者投入资本会增加所有者权益,所以属于收入。

答案:错。 所有者投入直接增加权益,不属于日常活动形成的收入。

  1. 单选:融资租入资产虽然法律所有权未必立即转移,仍按资产核算,体现( )。A及时性 B实质重于形式 C可比性 D谨慎性

答案:B。 应按交易经济实质核算。

  1. 简答:核算与监督是什么关系?

答案: 会计核算提供完整、连续、系统的信息,是监督的基础;会计监督保证经济活动和核算信息合法、合理、真实,两者相辅相成。

6刷题(章节配套练习,含校订与教学改编)

先做后看答案。单选点一下就判,多选选完点「核对答案」。错题自动进错题本,二轮会回来重做。

1. 单项选择题
对企业已发生的经济业务进行事后记录和反映,提供的信息是对过去生 产经营活动的客观反映的会计类型是( )。
A. 财务会计B. 管理会计C. 责任会计D. 决策会计
答案 A 财务会计主要是对企业已发生的经济业务进行事后记录和反映,提供的信息是对 过去生产经营活动的客观反映。
2. 单项选择题
财务会计主要是对企业已发生的经济业务进行事后记录和反映,其主要 依据是()。
A. 会计准则B. 会计法规C. 国家法律法规D. 会计基础规范
答案 A 财务会计是以会计准则为主要依据,通过一定的程序和方法,确认、计量企业资产、 负债、所有者权益的增减变动,记录营业收入的取得、费用的发生和归属,以及收益的形成和分 配,定期以财务报表的形式报告企业财务状况、经营成果和现金流量,并分析报表,评价其偿债 能力、营运能力和盈利能力的一套信息处理系统。
3. 单项选择题
下列会计活动中,属于财务会计范畴的是()。
A. 全面预算B. 清查财产C. 责任会计D. 成本控制
答案 B 本题考查会计的两大分支。管理会计主要包括预测分析、决策分析、全面预算、成本 控制和责任会计,选项A、C、D属于管理会计范畴。
4. 单项选择题
下列对于财务会计的说法,错误的是()。
A. 以会计准则为主要依据B. 提供的信息是对过去生产经营活动的客观反映C. 主要为内部会计信息使用者提供信息D. 主要对企业已经发生的经济业务进行事后记录和反映
答案 C 财务会计主要为外部会计信息使用者提供信息,选项C符合题意。
5. 单项选择题
下列会计活动中,属于管理会计内容的是()。
A. 确认和计量企业资产、负债、所有者权益的增减变动B. 预测分析企业成本变化趋势C. 记录经营收人的取得,费用的发生和归属以及收益的形成和分配D. 报告企业财务状况、经营成果和现金流量
答案 B 现代会计按照对外提供还是对内提供决策所需信息,分为财务会计与管理会计。其 中,管理会计主要包括:预测分析、决策分析、全面预算、成本控制和责任会计等内容。选项A、 C、D 都属于财务会计。
6. 多项选择题
现代会计按照对外提供还是对内提供决策所需信息,分为()。
A. 成本会计B. 责任会计C. 财务会计D. 管理会计E. 国际会计
答案 CD 会计的两大分支是财务会计和管理会计。
7. 多项选择题
下列会计工作中,属于管理会计范畴的有()。
A. 会计计量B. 预测分析C. 全面预算D. 财务会计报告E. 责任会计
答案 BCE 管理会计主要包括预测分析、决策分析、全面预算、成本控制和责任会计等内容。
8. 单项选择题
会计的基本职能是()。
A. 核算和监督B. 反映和控制C. 核算和报告D. 预算和决算
答案 A 会计具有核算和监督两项基本职能。
9. 单项选择题
会计的最基本职能是()。
A. 核算B. 分析C. 预算D. 控制
答案 A 会计具有核算和监督两项基本职能,核算职能是会计的最基本职能。
10. 单项选择题
通过确认、计量、记录、报告,利用货币形式从价值量方面反映已经发生或完成的经济活动,为经济管理提供可靠信息,属于会计的()职能。
A. 核算B. 检查C. 预测D. 监督
答案 A 会计的核算职能是指通过确认、计量、记录、报告,运用一定的方法或程序,利用货 币形式,从价值量方面反映企业已经发生或完成的客观经济活动情况,为经济管理提供可靠的 会计信息。

校勘说明:为消除歧义或明确准则适用条件所作的校订后教学题设,不冒充原题原文。

11. 单项选择题
在企业资金循环中,企业的资金从货币资金形态转化为储备资金形态的 过程是企业的()。
A. 供应过程B. 生产过程C. 销售过程D. 清算过程
答案 A 本题考查资金的循环与周转。供应过程中,企业的资金从货币形态转化为储备资 金形态。
12. 单项选择题
当产品制成时,企业的资金运动是()。
A. 从货币资金形态转化为储备资金形态B. 从储备资金形态转化为生产资金形态C. 从生产资金形态转化为成品资金形态D. 从成品资金形态转化为货币资金形态
答案 C 当产品制成时,资金从生产资金形态转化成品资金形态。
13. 多项选择题
下列业务中,属于资金循环与周转过程的有( )。
A. 购买材料B. 缴纳税金C. 支付工资D. 银行借款E. 销售商品
答案 ACE 资金的运动分为三个阶段:资金的投入、资金的循环与周转、资金的退出。其中, 资金的循环与周转又分为供应过程、生产过程、销售过程。选项A属于供应过程,选项C属于 生产过程,选项E属于销售过程,都是资金的循环与周转过程。选项D属于资金的投入,选项 B 属于资金的退出。
14. 多项选择题
企业收回的货币资金中,下列用途会使相应资金退出企业资金循环与周转的有()。
A. 向国家缴纳税金B. 用货币资金购入本企业生产设备C. 向投资者分配利润D. 留存收益用于企业再生产E. 留在企业购买生产材料
答案 AC 按本章资金运动分类,纳税和向投资者分配利润属于资金退出;购买生产设备、材料和留存再生产属于企业资金循环与周转。选AC。

校勘说明:为消除歧义或明确准则适用条件所作的校订后教学题设,不冒充原题原文。

15. 多项选择题
在生产经营过程中,企业收回的货币资金一般要大于投入的资金。企业 收回的货币资金中,退出了企业资金循环与周转的有()。
A. 用于缴纳税金的资金B. 用于偿还债务的资金C. 用于向投资者分配股利或利润的资金D. 用于购买机床的资金E. 用于向劳动者支付工资的资金
答案 ABC 企业收回的货币资金中,用于缴纳税金、偿还债务和向投资者分配股利或利润的 这部分资金就退出了企业的资金循环与周转,剩余的资金则留在企业,继续用于企业的再生产 过程。
16. 多项选择题
下列经济活动中,属于经济交易的有()。
A. 上缴税收B. 购买固定资产C. 销售商品D. 计提折旧E. 报销差旅费
答案 ABC 经济业务又称经济交易,是指单位与其他单位和个人之间发生的各种经济利益 的交换,如购买固定资产、销售商品、上缴税收等。
17. 多项选择题
根据《中华人民共和国会计法》,应当进行会计核算的经济业务事项包括 ()。
A. 资产的增减B. 负债的增减C. 净资产的增减D. 收入的增减E. 员工的增减
答案 ABCD 根据《中华人民共和国会计法》,应当办理会计手续、进行会计核算的经济业务 事项包括:资产的增减和使用;负债的增减;净资产(所有者权益)的增减;收入、支出、费用、 成本的增减;财务成果的计算和处理;需要办理会计手续、进行会计核算的其他事项。
18. 单项选择题
下列关于会计目标的说法,错误的是()。
A. 会计目标是指会计工作预期达到的最终结果B. 会计的一般目标是仅向内部管理部门提供决策所需要的会计信息及与之相关的其他 财务信息C. 会计目标要解决的问题,首先是谁需要会计信息,其次是需要什么样的会计信息D. 我国企业会计目标之一是反映企业管理层受托责任履行情况
答案 B 在市场经济条件下,会计的一般目标是向企业内部管理部门和企业外部与企业有利 害关系的主体提供决策所需要的会计信息及与之相关的其他财务信息。
19. 多项选择题
企业财务会计信息的主要内容包括有关()的信息。
A. 财务状况B. 经营成果C. 现金流量D. 管理水平E. 财务人员水平
答案 ABC 财务会计信息的主要内容大致有三类:①有关企业财务状况的信息,通过资产负 债表来反映;②有关企业经营成果的信息,通过利润表来反映;③有关企业现金流量的信息, 通过现金流量表来反映。
20. 多项选择题
企业财务会计报告主要提供的会计信息包括()。
A. 有关财务状况的信息B. 有关现金流量的信息C. 有关经营成果的信息D. 预算执行情况的信息E. 会计核算质量信息
答案 ABC 企业财务会计信息主要反映财务状况、经营成果和现金流量,分别主要由资产负债表、利润表、现金流量表提供,选ABC。

校勘说明:为消除歧义或明确准则适用条件所作的校订后教学题设,不冒充原题原文。

21. 单项选择题
以下关于资产特征的说法,错误的是( )。
A. 资产必须是企业拥有或控制的资源B. 资产必须是预期能够直接或间接给企业带来经济利益的资源C. 资产必须是现实的资产,而不是预期的资产D. 资产是过去的交易活动形成的且必须于未来某一特定时间予以清偿的现时义务
答案 D 资产是过去交易或事项形成、企业拥有或控制且预期带来经济利益的资源,ABC正确。D将资产混同为现时义务,且负债并不要求每项义务均有确定清偿日期,故选D。
22. 单项选择题
下列属于资产项目的是()。
A. 预收账款B. 预付账款C. 应付账款D. 盈余公积
答案 B 本题考查资产。选项A、C属于负债,选项D属于所有者权益。
23. 单项选择题
主要为交易目的而持有,预计在资产负债表日起1年内(含1年)变现 的资产指的是()。
A. 流动资产B. 固定资产C. 递延资产D. 无形资产
答案 A 流动资产是指预计在一个正常营业周期中变现、出售或者耗用的,或者主要为交易 目的而持有,或者预计在资产负债表日起1年内(含1年)变现的资产。
24. 单项选择题
下列属于流动资产项目的是()。
A. 可随时用于支付的货币资金B. 固定资产C. 在建工程D. 无形资产
答案 A 选项B、C、D属于非流动资产。

校勘说明:为消除歧义或明确准则适用条件所作的校订后教学题设,不冒充原题原文。

25. 单项选择题
下列各项中,已经形成企业负债的是()。
A. 企业已取得、尚未归还的银行贷款B. 企业仅签订且尚未履行、不含衍生工具或亏损义务的普通采购合同C. 企业以自有存款付清价款购入的固定资产D. 企业已当期付清且无后续付款义务的销售费用
答案 A 已取得且未偿还的银行贷款形成现时偿还义务,选A。普通未履行采购合同不等同于期货等衍生工具;已付清购置和费用不会因此留下应付债务。

校勘说明:为消除歧义或明确准则适用条件所作的校订后教学题设,不冒充原题原文。

26. 单项选择题
下列关于负债的说法,错误的是()。
A. 负债是指过去的交易、事项形成的,预期会导致经济利益流出企业的现时义务B. 负债必须有其可用货币额反映的价值量C. 负债按流动性分类可分流动负债和非流动负债D. 不符合负债确认条件,但符合负债定义的项目,应当列入资产负债表
答案 D 符合负债定义和负债确认条件的项目,应该列入资产负债表。符合负债定义,但不 符合负债确认条件的项目,不应当列入资产负债表。
27. 单项选择题
企业收到投资者出资超过其在注册资本或股本中所占份额的部分,通常计入()。
A. 实收资本(或股本)B. 资本公积C. 盈余公积D. 未分配利润
答案 B 投资者出资超过其在注册资本或股本中所占份额的部分计入资本公积(资本溢价或股本溢价),选B。直接计入权益的利得和损失应依准则区分其他综合收益等,不得一概归入资本公积。

校勘说明:校订后教学题设,不冒充原题原文。原题把直接计入权益的利得损失一概归为资本公积,不符合其他综合收益等分类;本题改考资本溢价,不依赖2026年新列报准则的提前执行选择。

28. 单项选择题
下列不属于所有者权益来源的是()。
A. 所有者投人的资本B. 直接计入所有者权益的利得和损失C. 留存收益D. 出售资产所得
答案 D 所有者权益的来源包括所有者投人的资本、直接计入所有者权益的利得和损失、留 存收益等。
29. 单项选择题
下列会计要素中,属于所有者权益的是()。
A. 未分配利润B. 应付职工薪酬C. 无形资产D. 预收款项
答案 A 未分配利润属于所有者权益,选A;应付职工薪酬、预收款项属于负债,无形资产属于资产。
30. 多项选择题
反映企业某一特定时点财务状况的会计要素有()。
A. 收入B. 负债C. 资产D. 利润E. 所有者权益
答案 BCE 资产、负债、所有者权益反映某一特定时点的财务状况,选BCE;收入、费用、利润反映一定期间的经营成果。

校勘说明:为消除歧义或明确准则适用条件所作的校订后教学题设,不冒充原题原文。

31. 多项选择题
下列资产中,属于非流动资产的有()。
A. 固定资产B. 无形资产C. 开发支出D. 交易性金融资产E. 预付款项
答案 ABC 非流动资产是指除流动资产以外的资产,主要包括长期股权投资、固定资产、在 建工程、无形资产、开发支出等。
32. 多项选择题
下列属于企业负债的有()。
A. 企业购买的大型设备B. 企业欠职工的工资C. 企业欠银行的贷款D. 企业的存货E. 企业负责人个人购房时向朋友的借款
答案 BC 选项A、D属于资产,选项E不属于企业财务。
33. 单项选择题
利润是指企业在一定期间内的经营成果,但不包括()。
A. 收入减去费用后的净额B. 直接计入当期利润的利得C. 直接计入当期利润的损失D. 企业投资人投入的资本
答案 D 本题考查利润。选项D属于所有者权益。
34. 多项选择题
下列会计要素中,能够反映经营成果的有()。
A. 收入B. 费用C. 利润D. 负债E. 资产
答案 ABC 反映经营成果的会计要素包括收入、费用和利润。
35. 多项选择题
符合费用的定义,并符合以下()条件的经济利益的流出,可以确认 为费用。
A. 与费用有关的经济利益很可能流出企业B. 会导致企业资产增加或者负债减少C. 经济利益的流出额能够可靠计量D. 会导致企业资产减少或者负债增加E. 经济利益可能流入企业
答案 ACD 确认为费用的条件包括:①与费用有关的经济利益很可能流出企业;②经济 利益流出企业的结果会导致企业资产减少或者负债增加;③经济利益的流出额能够可靠计 量。

校勘说明:为消除歧义或明确准则适用条件所作的校订后教学题设,不冒充原题原文。

36. 单项选择题
反映企业资产归属关系的平衡公式是()。
A. 资产=负债+所有者权益B. 资产=负债-所有者权益C. 资产=投资人投人资本+银行借款D. 资产=有形资产+无形资产
答案 A 本题考查会计等式。资产=权益=债权人权益+所有者权益=负债+所有者权 益,这一平衡公式反映了企业资产的归属关系。
37. 单项选择题
企业收到应收账款100万元并存人银行,引起的会计要素变动是()。
A. 一项资产和一项负债同时等额增加B. 一项资产和一项所有者权益同时等额增加C. 一项资产和一项所有者权益同时等额减少D. 一项资产增加,另一项资产等额减少,负债和所有者权益要素不变
答案 D 本题考查经济业务发生所引起的会计要素的变动。企业应收账款和银行存款都属 于资产,企业收到应收账款100万元并存人银行,一项资产增加,另一项资产等额减少,负债和 所有者权益要素不变。
38. 单项选择题
企业缴纳应交税费,所引起的会计要素变动是()。
A. 一项资产增加,另一项资产等额减少B. 一项资产和一项负债同时等额减少C. 一项资产和一项所有者权益同时等额减少D. 一项负债减少,另一项所有者权益等额增加
答案 B 企业缴纳应交税费,会引起一项资产和一项负债同时等额减少。
39. 单项选择题
某企业向供货方支付了应付账款,其引起的会计要素变动是()。
A. 一项所有者权益增加,另一项所有者权益等额減少,资产和负债要素不变B. 一项资产和一项负债同时等额减少C. 一项资产和一项所有者权益同时等额减少D. 一项负债减少,另一项所有者权益等额增加,资产要素不变
答案 B 企业向供货方支付了应付账款,资产方的货币资金减少,负债方的应付账款减少,一 项资产和一项负债同时等额减少。
40. 单项选择题
企业用自有房产作抵押,从银行取得长期贷款,其引起的会计要素变动是()。
A. 一项资产和一项负债同时等额增加B. 一项资产和一项所有者权益同时等额增加C. 一项负债增加,另一项负债等额减少,资产和所有者权益要素不变D. 一项所有者权益增加,另一项所有者权益等额减少,资产和负债要素不变
答案 A 企业从银行取得长期贷款,资产方的货币资金增加,负债方的长期借款增加,一项 资产和一项负债同时等额增加。
41. 单项选择题
某企业用银行存款购买一批存货,不考虑税费,其引起的会计要素变动是()。
A. 一项资产和一项负债同时等额增加B. 一项资产和一项负债同时等额减少C. 一项资产增加,另一项资产等额减少,负债和所有者权益要素不变D. 一项所有者权益增加,另一项所有者权益等额减少,资产和负债要素不变
答案 C 银行存款减少、存货等额增加,均属资产内部变动;负债和所有者权益不变,选C。

校勘说明:为消除歧义或明确准则适用条件所作的校订后教学题设,不冒充原题原文。

42. 多项选择题
一项经济业务发生后会引起相关会计要素的变动。下列会计要素变动 情形中,正确的有( )。
A. 一项资产和一项负债同时等额增加B. 一项资产和一项所有者权益同时等额减少C. 一项负债和一项所有者权益同时等额增加D. 一项资产增加,一项负债同时等额减少E. 一项负债增加,另一项负债等额减少,资产和所有者权益不变
答案 ABE 此考点与会计等式考点应为同一内容范围,因判断经济业务发生能否引起会 计要素的变动,就看变化后原来的会计恒等式:资产=负债+所有者权益,是否还保持等式左 右相等。一项负债和一项所有者权益同时等额增加,会计恒等式左边资产未动,右边同时增 加,显然破坏了恒等式,选项C错误。一项资产增加,一项负债同时等额减少,等式左右不相 等,选项D错误。
43. 单项选择题
按照权利和义务是否发生来确定收益和费用的归属期的方法称为()。
A. 复式记账B. 权责发生制C. 收付实现制D. 会计分期
答案 B 企业用来确认一定会计期间的收入和费用,从而确定损益的标准有两种:权责发生 制和收付实现制。其中,权责发生制是指凡是当期已经实现的收入和已经发生或应当负担的 费用,无论款项是否收付,均应作为当期的收人和费用处理。凡是不属于当期的收人和费用, 即使款项已经在当期收付,都不应作为当期的收入和费用。
44. 单项选择题
某企业对一项短期设备租赁采用简化处理,租金按月均匀计入费用。2026年1月支付上半年租金18万元,按权责发生制,1月份应确认租赁费用()万元。
A. 2B. 3C. 6D. 18
答案 B 上半年6个月均匀受益,1月份确认18/6=3万元,选B;付款金额不等于当月费用。

校勘说明:为消除歧义或明确准则适用条件所作的校订后教学题设,不冒充原题原文。

45. 单项选择题
某公司12月份支付次年的房屋租金120000元,采用权责发生制时,该 项支出应计入的本月费用为()元。
A. 0B. 10000C. 30000D. 120000
答案 A 支付的是次年租金,按权责发生制不属于本年12月费用,应先作为预付款处理,本月费用为0,选A。
46. 单项选择题
仅为比较记账基础:某企业2月份支付上半年仓库租金12000元。假设按收付实现制计算,3月份该项费用为()元。
A. 0B. 2000C. 6000D. 12000
答案 A 在题设收付实现制的假设下,以实际付款时间确认,3月份未付款,金额为0,选A。企业真实会计核算应依企业会计准则采用权责发生制。

校勘说明:为消除歧义或明确准则适用条件所作的校订后教学题设,不冒充原题原文。

47. 单项选择题
企业在进行会计要素计量时,一般应当采用的计量属性是()。
A. 历史成本B. 公允价值C. 重置成本D. 现值
答案 A 企业在对会计要素进行计量时,一般应当采用历史成本。
48. 单项选择题
当期发生的不但与本期收益有关而且与以后会计期间收益也有关的,应 当在以后若干会计期间的收益中得到补偿的支出是()。
A. 费用B. 成本C. 收益性支出D. 资本性支出
答案 D 资本性支出是指为当期发生的不但与本期收益有关而且与以后会计期间收益也有 关的,应当在以后若干会计期间的收益中得到补偿的支出。
49. 单项选择题
下列财务支出项目中,属于资本性支出的是()。
A. 生产车间水电费B. 管理人员工资C. 购入新生产设备D. 流动资金借款利息
答案 C 本题考查划分收益性支出与资本性支出原则。凡支出的效益惠及几个会计年度 (或几个营业周期)的,应当作为资本性支出。
50. 多项选择题
下列属于会计要素确认和计量基本原则的有()。
A. 持续经营B. 权责发生制原则C. 配比原则D. 会计分期E. 历史成本原则
答案 BCE 本题考查会计要素确认和计量基本原则。会计要素确认和计量基本原则包括权 责发生制原则、配比原则、历史成本原则、划分收益性支出与资本性支出原则。
51. 多项选择题
某企业将一笔资本性支出按收益性支出处理,出现的结果有()。
A. 多计费用B. 少计资产价值C. 当期净收益降低D. 净收益虚增E. 资产价值虚增
答案 ABC 如果一笔资本性支出按收益性支出处理了,则会出现多计费用而少计资产价值 的现象,出现当期净收益降低甚至亏损,以及资产价值偏低的结果。
52. 单项选择题
会计核算中,区分权责发生制和收付实现制两种记账基础的会计基本前 提是()。
A. 会计主体B. 持续经营C. 货币计量D. 会计分期
答案 D 会计分期是将一个企业持续不断的生产经营活动期间,划分为若干会计期间。明 确了会计期间这个前提,才产生了本期与非本期的区别,才产生了收付实现制和权责发生制, 才能正确贯彻配比原则。
53. 单项选择题
下列关于会计分期的说法,错误的是()。
A. 会计分期建立在持续经营基础之上B. 会计期间一般分为年度和中期C. 会计分期后才能正确贯彻配比原则D. 会计分期是历史成本原则的前提
答案 D 有了持续经营,才能建立如历史成本原则、权责发生制等会计确认和计量的一般原 则,选项D符合题意。
54. 单项选择题
要正确贯彻配比原则,必须明确的会计基本前提是()。
A. 会计主体B. 持续经营C. 会计分期D. 货币计量
答案 C 明确会计分期这个前提,才能正确贯彻配比原则。
55. 单项选择题
在会计核算的基本前提中,只有在()的前提下,企业的资产和负债 才能区分为流动的和长期的。
A. 持续经营B. 会计期间C. 会计主体D. 货币计量
答案 A 本题考查会计基本前提中的持续经营。只有在持续经营的前提下,企业的资产和 负债才区分为流动的和长期的。
56. 单项选择题
企业在进行会计确认、计量和报告时采用的主要计量单位是()。
A. 货币B. 实物数量C. 重量D. 长度
答案 A 本题考查会计核算计量单位。为了连续、系统、全面、综合地反映企业的经济活动, 会计核算客观上需要一种统一的计量单位作为会计核算的计量尺度,货币作为一般等价物,是 衡量商品价值的共同尺度,因而被选择作为会计核算的计量单位。
57. 多项选择题
下列会计概念中,属于会计基本前提的有()。
A. 历史成本B. 以权责发生制为核算基础C. 货币计量D. 会计主体E. 持续经营
答案 CDE 会计的基本前提包括会计主体、持续经营、会计分期、货币计量。
58. 单项选择题
企业对经济业务的记录和核算、报告必须建立在可查证的基础上,以客 观事实为依据,并且项目完整、手续完备。这体现的会计信息质量要求是()。
A. 可靠性B. 清晰性C. 相关性D. 重要性
答案 A 可靠性包括真实性和客观性两方面含义,真实性要求会计核算所提供的会计信息, 应当真实反映企业实际的财务状况和经营成果;客观性要求对经济业务的记录和核算、报告必 须建立在可查证的基础上,以客观事实为依据,不能人为凭空编造,并且项目完整、手续完备。
59. 单项选择题
承租人虽未取得租赁资产所有权,但因控制租赁期内的使用权而按准则确认使用权资产,体现的会计信息质量要求是()。
A. 重要性B. 实质重于形式C. 谨慎性D. 客观性
答案 B 按照经济实质而非仅法律所有权进行确认,体现实质重于形式,选B。

校勘说明:为消除歧义或明确准则适用条件所作的校订后教学题设,不冒充原题原文。

60. 单项选择题
对影响资产、负债、损益较大的会计事项予以充分、准确地披露,而对次 要的会计事项,在不影响会计信息真实性和不至于误导报告使用者作出判断的前提下进行简 化或合并反映。这体现了会计信息质量的()要求。
A. 一贯性B. 客观性C. 谨慎性D. 重要性
答案 D 重要性要求企业提供的会计信息应当反映与企业财务状况、经营成果和现金流量 等有关的所有重要交易或者事项。
61. 单项选择题
企业在对某一经济业务进行会计核算过程中,应根据交易或事项的重要 程度采用不同的核算方式。判断交易或事项重要程度的主要标准是()。
A. 决策层次B. 决策者的喜好C. 变现速度D. 对决策者利益的关联度和金额占总业务量的比重
答案 D 重要性的应用需要依赖职业判断,从项目的性质和金额大小两方面来判断。一般 情况下,对决策者的利益关联度高的和金额占总业务量比重较大的项目应当作重要项目在 财务报表上进行反映。
62. 单项选择题
企业应当对应收账款计提坏账准备,这体现的会计信息质量要求是()
A. 重要性B. 谨慎性C. 清晰性D. 可靠性
答案 B 企业应当对应收账款计提坏账准备,这体现的是会计信息质量要求的“谨慎性”。 谨慎性,又称稳健性,要求企业对交易或者事项进行会计确认、计量和报告时应当保持应有的 谨慎,不应高估资产或者收益,低估负债或者费用。
63. 单项选择题
在符合固定资产经济利益预期实现方式的前提下,教材将采用加速折旧法作为哪项会计信息质量要求的例子()。
A. 可靠性B. 重要性C. 谨慎性D. 实质重于形式
答案 C 教材以合理采用加速折旧作为谨慎性的例子,选C;具体折旧方法须符合经济利益预期实现方式,不得单为降低利润而选择。

校勘说明:为消除歧义或明确准则适用条件所作的校订后教学题设,不冒充原题原文。

64. 多项选择题
根据我国《企业会计准则》,企业提供会计信息的质量要求有()。
A. 可靠性B. 可比性C. 实质重于形式D. 全面性E. 谨慎性
答案 ABCE 会计信息质量要求包括可靠性、相关性、清晰性、可比性、实质重于形式、重要 性、谨慎性、及时性。
65. 多项选择题
根据本章对会计信息质量要求的归纳,企业依据经济实质确认租赁取得的使用权资产,并在符合经济利益预期实现方式的前提下采用加速折旧法,所对应的会计信息质量要求有()。
A. 实质重于形式B. 重要性C. 谨慎性D. 及时性E. 可比性
答案 AC 租赁资产确认不只看法律所有权,体现实质重于形式;教材将合理加速折旧列为谨慎性的例子,选AC。采用加速折旧须有经济利益实现方式依据。

校勘说明:为消除歧义或明确准则适用条件所作的校订后教学题设,不冒充原题原文。

66. 单项选择题
()是制定会计核算制度和组织会计核算工作的基本规范。
A. 会计法B. 会计制度C. 会计准则D. 财务规则
答案 C 会计准则也称会计标准,是制定会计核算制度和组织会计核算工作的基本规范,包 括《企业会计准则》《事业单位会计准则》和《政府会计准则》。
67. 多项选择题
下列法规制度中,属于会计法规的有()。
A. 《中华人民共和国会计法》B. 《政府会计准则》C. 《中华人民共和国预算法》D. 《企业会计制度》E. 《中华人民共和国政府采购法》
答案 ABD 本题考查会计法规。我国现行的会计法规以《中华人民共和国会计法》为核心, 以会计准则、财务规则和会计制度为主要内容。
68. 多项选择题
下列会计法规中,属于会计标准的有()。
A. 《中华人民共和国会计法》B. 《企业会计准则》C. 《事业单位会计准则》D. 《政府会计制度》E. 《企业会计制度》
答案 BC 会计准则也称会计标准,是制定会计核算制度和组织会计核算工作的基本规范, 包括《企业会计准则》《事业单位会计准则》和《政府会计准则》。

7本章打卡

做完一项勾一项,当天页会自动更新整体进度。

学完这章就是往前走了一步。记不住的,明天再来看必背,不用今天全记住。

↑ 回到今日顶部