1重点一览
先花 2 分钟看清这章有几个考点、哪几个是必考,心里有数再读书。
2教材标色 + 三色笔记
左边是教材原文,彩色句子就是《考点速记》收了的内容,颜色是星级。右边是速记的考点表,和左边的小节对齐。读一节,看一眼右边的表,再往下走。
一、集中趋势的测度
在描述统计中,可以通过统计量描述数据的分布特征。对于数据分布特征的测度主要分为三个方面:一是分布的集中趋势,反映各数据向其中心值靠拢或聚集的程度;二是分布的离散程度,既能反映各数据之间的差异程度,也能反映中心值对数据的代表程度;三是分布的偏态,反映数据分布的不对称性。对于两个定量变量之间的相关分析,经常采用的描述方法是散点图和相关系数统计量。
集中趋势是指一组数据向某一中心值靠拢的程度,它反映了一组数据中心点的位置所在。集中趋势的测度也就是寻找数据水平的代表值或中心值。
1. 均值。均值也叫作平均数,就是数据组中所有数值的总和除以该组数值的个数。设一组数据为 X1,X2,…,Xn,平均数 X̄ 的计算公式为:
X̄ = (X1 + X2 + … + Xn) ÷ n = ΣXi ÷ n
例如,某售货小组有 5 名营业员,元旦全天的销售额分别为 520 元、600 元、480 元、750 元和 500 元,求该日平均销售额。
X̄ = (520 + 600 + 480 + 750 + 500) ÷ 5 = 570(元)
计算结果表明,元旦 5 名营业员的平均销售额为 570 元。
均值是集中趋势最主要的测度值,它是一组数据的重心所在,解释了一组数据的平均水平。它主要适用于数值型数据,但不适用于分类数据和顺序数据。此外,均值容易受到极端值的影响,极端值会使得均值向极大值或极小值方向倾斜,使得均值对数据组的代表性减弱。
2. 中位数。把一组数据按从小到大或从大到小的顺序进行排列,位置居中的数值叫作中位数,用 Me 表示。中位数将数据分成两部分,其中一半数据小于中位数,另一半数据大于中位数。设一组数据为 X1,X2,…,Xn,按从小到大顺序为 X(1),X(2),…,X(n),则中位数为:
当 n 为奇数时:Me = X((n+1)/2);当 n 为偶数时:Me = 1/2 × [X(n/2) + X(n/2+1)]
例如,某地级市下辖 9 个县,每个县的面积如下(单位:平方千米),计算该市下辖县面积的中位数:
1455 2019 912 1016 1352 1031 2128 1075 2000
首先,将上面的数据排序结果如下:
912 1016 1031 1075 1352 1455 2000 2019 2128
数据共有 9 个,即奇数个,中位数为 Me = X((9+1)/2) = X(5) = 1352(平方千米)。
在上例中,由于行政区划调整,邻市的一个面积为 1000 平方千米的县被划归该市。行政区划调整后,该市现在下辖 10 个县,该市下辖县的面积(单位:平方千米)从小到大依次为:
912 1000 1016 1031 1075 1352 1455 2000 2019 2128
计算行政区划调整后该市下辖县面积的中位数:
数据共有 10 个,即偶数个,中位数为 Me = 1/2 × [X(10/2) + X(10/2+1)] = 1/2 × (X(5) + X(6)) = 1/2 × (1075 + 1352) = 1213.5(平方千米)。
中位数是一个位置代表值,主要用于顺序数据和数值型数据,但不适用于分类数据。中位数的优点是不受极端值的影响,抗干扰性强,尤其适用于收入这类偏斜分布的数值型数据。
3. 众数。众数是指一组数据中出现次数(频数)最多的变量值。例如,某能源公司有 9 个分公司,每个分公司的主营产品分别是煤制品、有机化工原料、火电、煤制品、热力、电解铝、火电、煤制品、煤制品,则该能源公司分公司主营产品的众数为煤制品。
众数适用于描述分类数据和顺序数据的集中趋势。而在定量数据中,可能出现多众数和无众数的情况,因此众数不适用于描述定量数据的集中位置。
4. 均值、中位数和众数的比较及适用范围。三者的关系及各自的适用范围如下。①均值适用于定量变量。优点是能够充分利用数据的全部信息,均值大小受每个观测值的影响,比较稳定;缺点是易受极端值的影响,如果观测值中有明显的极端值,则均值的代表性较差。②中位数不适用于分类变量,适用于顺序变量和定量变量,特别是分布不对称的数据。优点是不受极端值的影响;缺点是没有充分利用数据的全部信息,稳定性差于均值,优于众数。③众数不适用于定量变量,主要适用于分类变量和顺序变量。优点是不受极端值的影响,尤其是分布明显呈偏态时,众数的代表性更好;缺点是没有充分利用数据的全部信息,缺乏稳定性,而且可能不唯一。
二、离散程度的测度
离散程度反映的是数据之间的差异程度。集中趋势的测度值是对数据水平的一个概括性的度量,它对一组数据的代表程度,取决于该组数据的离散水平。数据的离散程度越大,集中趋势的测度值对该组数据的代表性就越差,离散程度越小,其代表性就越好。
1. 方差。方差是数据组中各数值与其均值离差平方的平均数,它能较好地反映出数据的离散程度,是实际中应用最广泛的离散程度测度值。方差越小,说明数据值与均值的平均距离越小,均值的代表性越好。
对于总体数据,常用的方差计算公式有两种:
σ² = Σ(Xi − X̄)² ÷ N
S² = Σ(Xi − X̄)² ÷ (N − 1)
前者的分母是总体规模 N,后者的分母是总体规模 N 减去 1。
对于样本数据,常用的方差计算公式为:
s² = Σ(Xi − X̄)² ÷ (n − 1)
样本方差 s² 的分母是样本规模减去 1。在有放回的简单随机抽样中,样本方差 s² 是总体方差 σ² 的无偏估计量;而在不放回的简单随机抽样中,样本方差 s² 是总体方差 S² 的无偏估计量。
根据本章前例中 5 名营业员元旦当天的销售额样本数据,计算日销售额的样本方差。
s² = Σ(Xi − X̄)² ÷ (n − 1) = [(520 − 570)² + (600 − 570)² + (480 − 570)² + (750 − 570)² + (500 − 570)²] ÷ (5 − 1) = 12200
2. 标准差。方差是反映数据离散程度的重要测度指标,但是其单位是原数据单位的平方,没有解释意义。因此,我们经常使用标准差来测度数据的离散程度,标准差即方差的平方根。对于样本数据,常用的标准差计算公式为:
s = √[Σ(Xi − X̄)² ÷ (n − 1)]
标准差不仅能度量数值与均值的平均距离,还与原始数值具有相同的计量单位。
同样地,利用 5 名营业员元旦当天的销售额样本数据,计算日销售额的标准差。
s = √[Σ(Xi − X̄)² ÷ (n − 1)] = √12200 ≈ 110.45(元)
标准差与方差计算比较简便,又具有比较好的数学性质,是应用最广泛的统计离散程度的测度方法。但是标准差与方差只适用于数值型数据。此外,与均值一样,它们对极端值也很敏感。
3. 离散系数。离散系数也称变异系数或标准差系数,即标准差与均值的比值,主要用于不同类别数据离散程度的比较,记为 CV。离散系数计算公式为:
CV = s ÷ X̄
根据 5 名营业员元旦当天的销售额案例数据,计算日销售额的离散系数。
CV = 110.45 ÷ 570 ≈ 0.19
标准差的大小不仅与数据的测度单位有关,也与观测值的均值大小有关,不能直接用标准差比较不同变量的离散程度。离散系数消除了测度单位和观测值水平不同的影响,因而可以直接用来比较变量的离散程度。
三、分布形态的测度
1. 偏态系数。偏度是指数据分布的偏斜方向和程度,描述的是数据分布对称程度。测度数据分布偏度的统计量称为偏态系数,其计算公式为:
SK = n ÷ [(n − 1)(n − 2)] × Σ[(Xi − X̄) ÷ s]³
偏态系数取决于离差三次方的平均数与标准差三次方的比值。如果偏态系数等于 0,说
明数据的分布是对称的;如果偏态系数为正值,说明分布为右偏的,取值在 0 和 0.5 之间说明轻度右偏,取值在 0.5 和 1 之间说明中度右偏,取值大于 1 说明严重右偏;如果偏态系数为负值,说明分布为左偏,取值在 0 和 −0.5 之间说明轻度左偏,取值在 −0.5 和 −1 之间说明中度左偏,取值小于 −1 说明严重左偏。偏态系数的绝对值越大,说明数据分布的偏斜程度越大。
2. 标准分数。在统计上,均值和标准差不同时,不同变量的数值是不能比较的。比如,在考核 A 中员工得分的均值为 80 分,标准差为 20 分,在考核 B 中员工得分的均值为 60 分,标准差为 5 分。同样是 80 的得分,在考核 A 中属于中等水平,在考核 B 中可能名列前茅。来自不同分布的变量值不可比,但是每个数值在变量分布中相对于均值的相对位置是可比的,因此可以通过计算标准分数来比较不同变量的取值。标准分数可以给出数值距离均值的相对位置,计算方法是用数值减去均值所得的差除以标准差,计算公式为:
Zi = (Xi − X̄) ÷ s
在上面所说的两次考核得分分布假定下,在考核 A 中 80 分转化后的标准分数为 0,在考核 B 中 70 分转化后的标准分数为 2,说明 70 分在考核 B 中的相对排名高于 80 分在考核 A 中的相对排名。
标准分数也称为 Z 分数,是统计上常用的一种标准化方法,转变后的标准分数并没有改变数值在原分布中的位置,也没有改变数据原分布的偏度,但是标准分数的平均数为 0,标准差为 1。
在实际应用中,当数据服从对称的钟形分布时,可以运用经验法则来判断与均值的距离在特定倍数标准差之内的数据项所占比例。经验法则表明:约有 68% 的数据与平均数的距离在 1 个标准差之内,约有 95% 的数据与平均数的距离在 2 个标准差之内,约有 99% 的数据与平均数的距离在 3 个标准差之内。也就是说,对于服从对称的钟形分布的标准分数来说,约有 68% 的标准分数在 [−1, +1] 范围内,约有 95% 的标准分数在 [−2, +2] 范围之内,约有 99% 的标准分数在 [−3, +3] 范围之内。因此,根据经验法则,如果上面的考核 B 中的得分服从对称钟形分布,则 95% 的得分都在 50 分和 70 分之间。
四、变量间的相关分析
现实中很多变量之间存在着相关关系。比如,一般来说,身高越高的人体重也越重,收入较高的家庭消费水平也较高,诸如此类的例子不胜枚举。有的变量间相关关系较强,有的变量间相关关系较弱,并且变量间相关的模式也是不尽相同的。因此,我们需要度量变量间相关关系的强弱,并对不同的相关关系进行分类。
(一)变量间的相关关系
客观现象的相关关系可以按不同的标准进行分类。
1. 按相关的程度可分为完全相关、不完全相关和不相关。当一个变量的取值变化完全由另一个变量的取值变化所确定时,称这两个变量间的关系为完全相关。例如,在价格不变的条件下,某种商品的销售总额由其销售量决定。当两个变量的取值变化彼此互不影响时,称为不相关现象。例如,通常认为股票价格的高低与气温的高低是不相关的。当两个变量之间的关系介于完全相关和不相关之间,称为不完全相关,一般相关现象都是指这种不完全相关。
2. 按相关的方向可分为正相关和负相关。当一个变量的取值由小变大,另一个变量的取
值也相应由小变大,这种相关称为正相关。例如,工人的工资随着劳动生产率的提高而增加。当一个变量的取值由小变大,而另一个变量的取值相反地由大变小,这种相关称为负相关。例如,商品的销售量随着单价的升高而降低。
3. 按相关的形式可分为线性相关和非线性相关。当两个相关变量之间的关系大致呈现为线性关系时,称之为线性相关。如果两个相关变量之间,并不表现为直线的关系,而是近似于某种曲线方程的关系,则这种相关关系称为非线性相关。
需要注意的是,相关关系并不等同于因果关系。例如,夏季我们也许能得到雪糕的销售量与遮阳伞的销售量之间呈正相关,但常识告诉我们它们之间并不存在因果关系。
(二)散点图
两个变量间的关系可以用散点图来展示。在散点图中,每个点代表一个观测值,横纵坐标值分别代表两个变量相应的观测值。
图 24-1 是一些数据的散点图。横坐标值表示变量 X 的观测值,纵坐标值表示变量 Y 的观测值。图 a 的点几乎无规律而言,表示这两个变量不相关。图 b 和图 c 中,观测点密集在一条直线周围,表现为较强的线性相关,但相关的方向不同。图 b 中的两个变量为正相关关系,图 c 中的两个变量为负相关关系。图 d 中的观测点呈现出曲线模式,这表示两个变量为非线性相关。
(图 24-1 不同形态的散点图:a)点无规律散开,不相关;b)点沿右上方向直线密集,正相关;c)点沿右下方向直线密集,负相关;d)点呈 U 形曲线,非线性相关。图形见教材扫描件)
(三)相关系数
相关系数是度量两个变量间相关关系的统计量。最常用的相关系数是 Pearson 相关系数,它度量的是两个变量间的线性相关关系。
假设分别可得到两个变量 X 和 Y 的 n 组观测值,即 (xi, yi),i = 1, 2, …, n,其中两组观测值之间是一一对应的,那么 Pearson 相关系数 r 的计算公式为:
r = Σ(xi − x̄)(yi − ȳ) ÷ √[Σ(xi − x̄)² × Σ(yi − ȳ)²]
表 24-1 是 2012 至 2023 年我国城镇居民人均可支配收入和人均消费支出数据。图 24-2 所示为相应的散点图。从图中可以看出,这两个变量呈正线性相关。
表 24-1 2012 至 2023 年我国城镇居民人均可支配收入和人均消费支出(单位:元)
| 年份 | 城镇居民人均可支配收入 | 城镇居民人均消费支出 |
|---|---|---|
| 2012 | 24127 | 17107 |
| 2013 | 26467 | 18488 |
| 2014 | 28844 | 19968 |
| 2015 | 31195 | 21392 |
| 2016 | 33616 | 23079 |
| 2017 | 36396 | 24445 |
| 2018 | 39251 | 26112 |
| 2019 | 42359 | 28063 |
| 2020 | 43834 | 27007 |
| 2021 | 47412 | 30307 |
| 2022 | 49283 | 30391 |
| 2023 | 51821 | 32994 |
资料来源:《中国统计年鉴》。(编者注:表中数据为统计软件导出,存在统计误差。)
(图 24-2 2012 至 2023 年我国城镇居民人均可支配收入和人均消费支出的散点图:横轴为人均可支配收入,纵轴为人均消费支出,各点近似排成一条向右上方的直线。图形见教材扫描件)
用公式进行计算,可得两变量观测值的 Pearson 相关系数 r:
r = Σ(xi − x̄)(yi − ȳ) ÷ √[Σ(xi − x̄)² × Σ(yi − ȳ)²] ≈ 0.9941
可以证明,Pearson 相关系数的取值范围在 +1 和 −1 之间,即 −1 ≤ r ≤ 1。若 0 < r ≤ 1,表明变量 X 和 Y 之间存在正线性相关关系;若 −1 ≤ r < 0,表明变量 X 和 Y 之间存在负线性
相关关系。若 r = 1,表明变量 X 和 Y 之间为完全正线性相关;若 r = −1,表明变量 X 和 Y 之间为完全负线性相关。可见,当 |r| = 1 时,变量 Y 的取值完全依赖于 X;当 r = 0 时,说明 Y 和 X 之间不存在线性相关关系。需要注意的是,Pearson 相关系数只适用于线性相关关系的判断。因此,r = 0 只表示两个变量之间不存在线性相关关系,并不说明变量之间没有任何关系,比如它们之间可能存在非线性相关关系。变量之间的非线性相关程度较大时,就可能会导致 r = 0。因此,当 r = 0 或很小时,不能轻易得出两个变量之间不存在相关关系的结论,而应结合散点图作出合理的解释。
根据实际数据计算出的 r,其取值范围一般为 −1 < r < 1。在说明两个变量之间的线性关系的强弱时,根据经验可将相关程度分为以下几种情况:当 |r| ≥ 0.8 时,可视为高度相关;当 0.5 ≤ |r| < 0.8 时,可视为中度相关;当 0.3 ≤ |r| < 0.5 时,可视为低度相关;当 |r| < 0.3 时,说明两个变量之间的相关程度极弱,可视为无线性相关关系。
3必背
这些是必须背下来的。先遮住右边一列,看左边考点名,自己说出内容,说不出来的做记号。
经济基础 第24章 描述统计 必背
红 ★★★ 必考
| 考点 | 必背内容 |
|---|---|
| 数据分布特征三方面 | 集中趋势(向中心靠拢)、离散程度(差异 + 中心值代表性)、偏态(不对称性) |
| 均值 | 总和 ÷ 个数:X̄ = ΣXi ÷ n;集中趋势最主要的测度值,是一组数据的重心 |
| 均值适用 | 只用于数值型数据,不适用于分类数据和顺序数据;易受极端值影响,代表性减弱 |
| 中位数 | 排序后居中的数,记 Me;n 为奇数取第 (n+1)/2 个,n 为偶数取中间两个的平均 |
| 中位数适用 | 位置代表值,用于顺序数据和数值型数据,不适用于分类数据;不受极端值影响,抗干扰强,收入类偏斜数据最适合 |
| 众数 | 出现次数(频数)最多的变量值;适用于分类数据和顺序数据,不适用于定量数据(可能多众数或无众数) |
| 三者比较:均值 | 定量变量。优点:充分利用全部信息,比较稳定;缺点:易受极端值影响 |
| 三者比较:中位数 | 顺序变量和定量变量(尤其分布不对称),不用于分类变量。优点:不受极端值影响;缺点:没用全部信息,稳定性差于均值、优于众数 |
| 三者比较:众数 | 分类变量和顺序变量,不用于定量变量。优点:不受极端值影响,明显偏态时代表性更好;缺点:没用全部信息,缺乏稳定性,可能不唯一 |
| 方差 | 各数值与均值离差平方的平均数,应用最广泛的离散程度测度值;样本方差 s² = Σ(Xi − X̄)² ÷ (n − 1);方差越小,均值代表性越好 |
| 标准差 | 方差的平方根:s = √[Σ(Xi − X̄)² ÷ (n − 1)];与原始数据同单位,能度量数值与均值的平均距离 |
| 方差与标准差的局限 | 只适用于数值型数据;对极端值敏感 |
| 离散系数 | 又叫变异系数、标准差系数:CV = s ÷ X̄;消除单位和均值水平的影响,用于不同类别数据离散程度的比较 |
| 教材例题数字 | 5 名营业员销售额 520、600、480、750、500:均值 570,样本方差 12200,标准差 110.45,离散系数 0.19 |
黄 ★★ 重点
| 考点 | 必背内容 |
|---|---|
| 按相关程度分 | 完全相关(一个变量完全由另一个决定)、不相关(彼此互不影响)、不完全相关(介于两者之间,一般相关都是这种) |
| 按相关方向分 | 正相关(一个变大另一个也变大)、负相关(一个变大另一个变小) |
| 按相关形式分 | 线性相关(大致呈直线)、非线性相关(近似某种曲线) |
| 相关与因果 | 相关关系不等于因果关系(雪糕销量与遮阳伞销量) |
| 散点图四图 | a 无规律 = 不相关;b 沿直线右上 = 正相关;c 沿直线右下 = 负相关;d 曲线 = 非线性相关 |
| Pearson 相关系数 | r = Σ(xi − x̄)(yi − ȳ) ÷ √[Σ(xi − x̄)² × Σ(yi − ȳ)²];只适用于线性相关关系的判断 |
| r 的取值 | −1 ≤ r ≤ 1;0 < r ≤ 1 正线性相关,−1 ≤ r < 0 负线性相关;r = 1 完全正线性相关,r = −1 完全负线性相关(r 的绝对值 = 1 时 Y 完全依赖于 X);r = 0 无线性相关(不等于没关系,可能非线性) |
| 相关强弱经验标准 | 绝对值 ≥ 0.8 高度相关;0.5 到 0.8 中度相关;0.3 到 0.5 低度相关;小于 0.3 极弱,视为无线性相关 |
绿 ★ 会考数字的点
| 考点 | 必背内容 |
|---|---|
| 偏态系数 SK | 离差三次方的平均数 ÷ 标准差三次方;SK = 0 对称,正值右偏,负值左偏;绝对值越大偏得越厉害 |
| 偏态轻中重 | 右偏:0 到 0.5 轻度,0.5 到 1 中度,大于 1 严重;左偏对称取负:0 到 −0.5 轻度,−0.5 到 −1 中度,小于 −1 严重 |
| 标准分数(Z 分数) | Zi = (Xi − X̄) ÷ s,数值离均值几个标准差;不改变数值在原分布中的位置,不改变偏度;转化后平均数为 0、标准差为 1 |
| 经验法则 | 对称钟形分布:68% 在 1 个标准差内 [−1, +1],95% 在 2 个标准差内 [−2, +2],99% 在 3 个标准差内 [−3, +3] |
数字与公式清单
- 均值 X̄ = ΣXi ÷ n;例题 570 元
- 中位数:奇数取第 (n+1)/2 个,偶数取第 n/2 和 n/2+1 个的平均;例题 9 个县 1352,10 个县 1213.5
- 样本方差 s² = Σ(Xi − X̄)² ÷ (n − 1),分母 n − 1;例题 12200
- 标准差 s = √方差;例题 110.45 元
- 离散系数 CV = s ÷ X̄;例题 0.19
- 偏态系数 SK = n ÷ [(n − 1)(n − 2)] × Σ[(Xi − X̄) ÷ s]³,分界线 0.5 和 1
- 标准分数 Z = (X − X̄) ÷ s;例题考核 B 里 70 分 Z = (70 − 60) ÷ 5 = 2
- 经验法则 68%、95%、99% 对应 1、2、3 个标准差
- Pearson r 范围 −1 到 1;强弱分界 0.8、0.5、0.3;例题城镇居民收入与消费 r ≈ 0.9941
- 稳定性排序:均值 > 中位数 > 众数;抗极端值:中位数、众数强,均值弱
- 数据类型配对:分类数据只能用众数;顺序数据用众数、中位数;数值型数据三个都行
4总结
一页纸看完整章。二轮快刷和考前只看这里和必背。
经济基础 第24章 描述统计 一页纸总结
本章一句话
拿到一堆数,先找「中间在哪」(均值、中位数、众数),再看「散得多开」(方差、标准差、离散系数),再看「歪不歪」(偏态系数、标准分数),最后看两个变量「有没有一起动」(散点图、Pearson 相关系数 r)。四件事对应四个考点,公式就那几个,例题数字 570、12200、110.45、0.19 串起前两个考点。
章末总览表
| 考点 | 星级 | 一句话要点 | 考法 |
|---|---|---|---|
| 考点一 集中趋势的测度 | ★★★ | 均值 = 总和 ÷ 个数,数值型专用,怕极端值;中位数 = 排序取中间,顺序和数值型可用,不怕极端值,收入用它;众数 = 出现最多的值,分类和顺序数据用;稳定性均值 > 中位数 > 众数 | 单选(适用数据类型、优缺点)、多选(三者比较)、计算(求均值、求中位数) |
| 考点二 离散程度的测度 | ★★★ | 方差 = 离差平方的平均(分母 n − 1),标准差 = 开根号回到原单位,离散系数 = 标准差 ÷ 均值用于跨组比较;方差和标准差只用于数值型数据且对极端值敏感 | 单选(概念和适用)、计算(给一组数求方差、标准差、离散系数)、多选(离散系数三个名字、作用) |
| 考点三 分布形态的测度 | ★ | 偏态系数正右偏负左偏 0 对称,0.5 和 1 分轻中重;标准分数 Z = (X − 均值) ÷ 标准差,均值变 0 标准差变 1;经验法则 68%、95%、99% 对应 1、2、3 个标准差 | 单选(偏态方向和程度判断、经验法则比例)、计算(求 Z 分数) |
| 考点四 变量间的相关分析 | ★★ | 相关分三类:程度(完全、不完全、不相关)、方向(正、负)、形式(线性、非线性);散点图四种形态;Pearson r 在 −1 到 1,只判线性,0.8、0.5、0.3 分高中低 | 单选(给 r 值判断相关程度和方向)、多选(相关关系分类)、判断(r = 0 是否无关系) |
易错坑
- 均值「比较稳定」和「易受极端值影响」是同时成立的两句话,别以为矛盾就选错;中位数「稳定性差于均值、优于众数」这个排序常考。
- 样本方差、标准差的分母是 n − 1 不是 n;方差的单位是原单位的平方,所以才要标准差。
- 比较两组单位不同或均值差很大的数据谁更离散,只能用离散系数,不能直接比标准差;离散系数 = 变异系数 = 标准差系数,三个名字一回事。
- r = 0 只说明没有线性相关,不代表没关系(可能非线性);Pearson 相关系数只判线性;相关不等于因果。
- r 看强弱看绝对值:r = −0.9 是高度相关;偏态系数 1.2 是严重右偏,0.3 是轻度右偏,分界线是 0.5 和 1。
和前后章的关系
第 23 章讲统计与数据科学是总纲(数据类型:分类、顺序、数值型),本章所有「适用于什么数据」的判断都建立在第 23 章数据分类上。本章算出来的均值、方差是「描述」,第 25 章抽样调查讲怎么从样本推断总体,本章样本方差分母 n − 1 的无偏估计在那里接着用;第 26 章回归分析是本章相关系数的延伸,从「有没有关系」走到「关系是什么方程」。
5解读(读透版讲义)
哪里没看懂,来这里看大白话讲解。生活例子、考法、坑都在这。可以先读这个再回去读教材。
描述统计(教材原文·OCR)
文字为主,公式/图表以教材扫描为准。配套精华看复习网页。
第二十四章 描述统计
在描述统计中,可以通过统计量描述数据的分布特征。对于数据分布特征的测度主要分
为三个方面:一是分布的集中趋势,反映各数据向其中心值靠拢或聚集的程度; 二是分布的离
散程度 ,既能反映各数据之间的差异程度,也能反映中 心值对数据的代表程度; 三 =是分布的偏
态,反映数据分布的不对称性。对于两个定量变量之间的相关分析,经 常采用的描述方法是散
点图和相关系数统计量。
一\集中趋势的测度
集中趋势是指一组数据向某一中心值靠拢的程度,它反映了一组数据中心点的位置所在。
集中趋势的测度也就是寻找数据水平的代表值或中心值。
1均值。均值也叫作平均数,就是数据组中所有数值的总和除以该组数值的个数。设一
组数据为书,刺,…,闷,平均数筷的计算公式为:
了 丰二 7 辫志
4
例如,某售货小组有 5 名营业员 ,元旦全天的销售额分别为 520 元 .600 元.480 元.750元
和 500 元,求该日平均销售额。
喜 _320 +600 二 +750 +500 -570(元)
计算结果表明,元旦5 名营业员的平均销售额为 570 元。
均值是集中趋势最主要的测度值,它是一组数据的重心所在,解释了一组数据的平均水
平。它主要适用于数值型数据,但不适用于分类数据和顺序数据。此外,均值容易受到极端值
的影响,极端值会使得均值向极大值或极小值方向倾斜,使得均值对数据组的代表性减弱。
- 中位数。把一组数据按从小到大或从大到小的顺序进行排列,位置居中的数值叫作中
位数,用凡 表示。中位数将数据分成两部分,其中一半数据小于中位数,另一半数据大于中位
数。设一组数据为 吕, 于,… ,总,按从小到大顺序为Xih, Ko,…,开oh则中位数为:
工(呈0) 当 为奇数时
于[xG)+xG D)] 当,为偶数时
例如,某地级市下钳9个县,每个县的面积如下(单位: 平方千米),计算该市下钳县面积
的中位数:
1455 2019 912 1016 1352 1031 2128 1075 2000
首先,将上面的数据排序结果如下
912 1016 1031 1075 1352 1455 2000 2019 2128
数据共有 9 个,即奇数个,中位数为 W=X (sjD) =1352( 平方千米)。
1 =
第二让四章…,描*述*统*计 “2715,
在上例中,由于行政区划调整 ,邻市的一个面积为 1000 平方千米的县被划归该市。行政
区划调整后,该市现在下辖 10 个县,该市下辖县的面积(单位:平方千米 )从小到大依次为:
912 1000 1016 1031 1075 1352 1455 2000 2019 2128
计算行政区划调整后该市下辖县面积的中位数:
数据共有 10 个,即偶数个,中位数为W= [Kom)+X(Ce |] = 2=(1075+1352) = 2=12135
(平方下米)
中位数是一个位置代表值,主要用于顺序数据和数值型数据,但不适用于分类数据。中位
数的优点是不受极端值的影响,抗干扰性强,尤其适用于收入这类偏斜分布的数值型数据。
- 众数。众数是指一组数据中出现次数( 频数)最多的变量值。例如,某能源公司有 9 个
分公司,每个分公司的主营产品分别是煤制品`有机化工原料火电、煤制品 ,热力,电解铝、火
电、煤制品 .煤制品,则该能源公司分公司主营产品的众数为煤制品。
众数适用于描述分类数据和顺序数据的集中趋势。而在定量数据中,可能出现多众数和
无众数的情况,因此众数不适用于描述定量数据的集中位置。
- 均值.中位数和众数的比较及适用范围。三者的关系及各自的适用范围如下。@D均值适
用于定量变量。优点是能够充分利用数据的全部信息,均值大小受每个观测值的影响,比较稳
定; 缺点是易受极端值的影响,如果观测值中有明显的极端值,则均值的代表性较差。@中位数
不适用于分类变量,适用于顺序变量和定量变量,特别是分布不对称的数据。优点是不受极端
值的影响; 缺点是没有充分利用数据的全部信息,稳定性差于均值,优于众数。@)众数不适用于
定量变量, 主要适用于分类变量和顺序变量。优点是不受极端值的影响,尤其是分布明显呈偏
态时,众数的代表性更好; 缺点是没有充分利用数据的全部信息,缺乏稳定性,而且可能不唯一。
二\离散程度的测度
离散程度反映的是数据之间的差异程度。集中趋势的测度值是对数据水平的一个概括性
的度量,它对一组数据的代表程度,取决于该组数据的离散水平。数据的离散程度越大,集中
趋势的测度值对该组数据的代表性就越差,离散程度越小,其代表性就越好。
1.方差。方差是数据组中各数值与其均值离差平方的平均数,它能较好地反映出数据的
离散程度,是实际中应用最广泛的离散程度测度值。方差越小,说明数据值与均值的平均距离
越小,均值的代表性越好。
对于总体数据,常用的方差计算公式有两种:
守 (和-7
-气- 一
2
OF
之 (互 一 ) “
NV-1l
前者的分母是总体规模 NW,后者的分母是总体规模 N 减去 1。
对于样本数据,常用的方差计算公式为:
三
3 =
灵一1
“216 经济基础知识 (中级)
样本方差* 的分母是样本规模减去 1。在有放回的简单随机抽样中,样本方差立是总
体方差 r ”的无偏估计量; 而在不放回的简单随机抽样中,样本方差叶是总体方差 8? 的无偏
估计量。
根据本章前例中 5 名营业员元旦当天的销售额样本数据,计算日销售额的样本方差。
守(世-2旭)?
玉= msE
九一1
_ (520 - 570)” + (600 - 570)” + (480 - 570)? + (750 - 570) + (500 - 570)
本 SS -1
= 12200
- 标准差。方差是反映数据离散程度的重要测度指标,但是其单位是原数据单位的平方,
没有解释意义。因此,我们经常使用标准差来测度数据的离散程度,标准差即方差的平方根。
对于样本数据,常用的标准差计算公式为:
| 立 (厂=- |
|---|
=
“一 九一1
标准差不仅能度量数值与均值的平均距离 ,还与原始数值具有相同的计量单位。
同样地,利用 5 名营业员元旦当天的销售额样本数据,计算日销售额的标准差。
(天 一)
一 一= 12200 ~ 110.45 (元)
元二
标准差与方差计算比较简便,又具有比较好的数学性质,是应用最广泛的统计离散程度的
测度方法。但是标准差与方差只适用于数值型数据。此外,与均值一样,它们对极端值也很敏
- 离散系数。离散系数也称变异系数或标准差系数,即标准差与均值的比值,主要用于不
同类别数据离散程度的比较,记为 CY。离散系数计算公式为,
CY=二
元
根据 5 名营业员元旦当天的销售额案例数据,计算日销售额的离散系数。
CY =了人 ~0.19
标准差的大小不仅与数据的测度单位有关,也与观测值的均值大小有关,不能直接用标准
差比较不同变量的离散程度。离散系数消除了测度单位和观测值水平不同的影响,因而可以
直接用来比较变量的离散程度。
三分布形态的测度
- 偏态系数。偏度是指数据分布的偏笠方向和程度,描述的是数据分布对称程度测度
数据分布偏度的统计量称为偏态系数,其计算公式为;
加 用 系一X下
你 Ce这 > 】
偏态系数取决于离差三次方的平均数与标准差三次方的比值。如果偏态系数等于0 说
第二让四章”,描*述统计 2177,
明数据的分布是对称的; 如果偏态系数为正值,说明分布为右偏的,取值在 0 和 0.5 之间说明
轻度右偏,取值在 0.5 和 1 之间说明中度右偏,取值大于 1 说明严重右偏; 如果偏态系数为负
值,说明分布为左偏,取值在 0 和 -0.5 之间说明轻度左偏,取值在 -0.5 和 -1 之间说明中度左
偏,取值小于 -1 说明严重左偏。偏态系数的绝对值越大,说明数据分布的偏斜程度越大。
- 标准分数。在统计上 ,均值和标准差不同时,不同变量的数值是不能比较的。比如,在
考核 A 中员工得分的均值为 80 分,标准差为 20 分,在考核 B 中员工得分的均值为 60 分,标
准差为5 分。同样是 80 的得分,在考核 A 中属于中等水平,在考核 B 中可能名列前匾。来自
不同分布的变量值不可比,但是每个数值在变量分布中相对于均值的相对位置是可比的,因此
可以通过计算标准分数来比较不同变量的取值。标准分数可以给出数值距离均值的相对位
置,计算方法是用数值减去均值所得的差除以标准差 ,计算公式为:
成-碟
2 =
在上面所说的两次考核得分分布假定下 ,在考核 A 中 80 分转化后的标准分数为 0,在考
核B 中70 分转化后的标准分数为2,说明 70 分在考核 B 中的相对排名高于 80 分在考核 A
中的相对排名。
标准分数也称为Z 分数,是统计上常用的一种标准化方法 ,转变后的标准分数并没有改变
数值在原分布中的位置,也没有改变数据原分布的偏度,但是标准分数的平均数为0,标准差
为 1。
在实际应用中, 当数据服从对称的钟形分布时,可以运用经验法则来判断与均值的距离
在特定倍数标准差之内的数据项所占比例。经验法则表明: 约有 68% 的数据与平均数的距离
在 1 个标准差之内,约有 95% 的数据与平均数的距离在 2 个标准差之内,约有 99%5 的数据与
平均数的距离在 3 个标准差之内。也就是说,对于服从对称的钟形分布的标准分数来说,约有
6896 的标准分数在[ -1, +1]范围内,约有 95% 的标准分数在[ -2, +2 ] 范围之内,约有 99% 的
标准分数在[ -3, +3 ] 范围之内。因此,根据经验法则,如果上面的考核 B 中的得分服从对称
钟形分布,则 95% 的得分都在 50 分和 70 分之间。
四、变量间的相关分析
现实中很多变量之间存在着相关关系。比如,一般来说,身高越高的人体重也越重,收入
较高的家庭消费水平也较高,诸如此类的例子不胜枚举。有的变量间相关关系较强,有的变量
间相关关系较弱,并且变量间相关的模式也是不尽相同的。因此,我们需要度量变量问相关关
系的强弱,并对不同的相关关系进行分类。
( 一 )变量间的相关关系
客观现象的相关关系可以按不同的标准进行分类。
- 按相关的程度可分为完全相关、不完全相关和不相关。当一个变量的取值变化完全由
另一个变量的取值变化所确定时,称这两个变量间的关系为完全相关。例如,在价格不变的条
件下 ,某种商品的销售总额由其销售量决定。当两个变量的取值变化彼此互不影响时 ,称为不
相关现象。例如,通常认为股票价格的高低与气温的高低是不相关的。当两个变量之间的关
系介于完全相关和不相关之间 ,称为不完全相关,一般相关现象都是指这种不完全相关。
- 按相关的方向可分为正相关和负相关。当一个变量的取值由小变大,另一个变量的取
218 经济基础知识(中级)
值也相应由小变大,这种相关称为正相关。例如,工人的工资随着劳动生产率的提高而增加。
当一个变量的取值由小变大,而另一个变量的取值相反地由大变小,这种相关称为负相关。例
如,商品的销售量随着单价的升高而降低。
- 按相关的形式可分为线性相关和非线性相关。当两个相关变量之间的关系大致呈现为
线性关系时,称之为线性相关。如果两个相关变量之间,并不表现为直线的关系,而是近似于
某种曲线方程的关系,则这种相关关系称为非线性相关。
需要注意的是,相关关系并不等同于因果关系。例如,夏季我们也许能得到雪糕的销售量
与遮阳们的销售量之间呈正相关,但常识告诉我们它们之间并不存在因果关系。
( 二)散点图
两个变量间的关系可以用散点图来展示。在散点图中,每个点代表一个观测值,横纵坐标
值分别代表两个变量相应的观测值。
图 24-1 是一些数据的散点图。横坐标值表示变量了的观测值,纵坐标值表示变量了的
观测值。图 a 的点几乎无规律而言 ,表示这两个变量不相关。图 b 和图 e 中,观测点密集在一
条直线周围,表现为较强的线性相关,但相关的方向不同。图 b 中的两个变量为正相关关系,
图e 中的两个变量为负相关关系。图 d 中的观测点呈现出曲线模式,这表示两个变量为非线
性相关。
员 十? 6 5
尽了| o
SS了] 。 了 o” 8
ooo oo o 局 四
己 二 站 oo ae 。 一 8
_ o 。 & 吕 四 相
了了 多 06 ?
S o 8 o。 S 了 o
1 oo 隐
D 己 O
T T T T T 全 T T T T
=-10 -5 0 5 10 =-20 =10 0 10 20
大 大
a) b)
加
[5 吉 5
10 20
1
了
1
了
4e+05
L _ 1
o
己二 中
宁
二 |
己
?] 和 “| 。
9 哆
二 oo 忆 站| Romemm ap
T T T T T 包 T T T T T
-20 -10 0 10 20 -20 -10 0 10 20
互 下
c) d)
24-1 不同形态的散点图
( 三 )相关系数
相关系数是度量两个变量间相关关系的统计量。最常用的相关系数是 Pearson 相关系
数,它度量的是两个变量间的线性相关关系。
第二让四章…横*述-统-计 .279 .
假设分别可得到两个变量X和了的m组观测值,即 ,yx,i=1,2,…,m,其中两组观测值
之间是一一对应的,那么 Pearson 相关系数 的计算公式为:
人-
辫 (和一无) 区 (和一7)
表 24-1 是 2012一2023 年我国城镇居民人均可支配收入和人均消费支出数据。图 24-2
所示为相应的散点图。从图中可以看出,这两个变量呈正线性相关。
表 24-1 2012一2023 年我国城镇居民人均可支配收入和人均消费支出
年份 2012 | 2013 | 2014 | 2015 | 2016 | 2017 | 2018 | 2019 | 2020 | 2021 | 2022 | 2023
城镇居民
人均可支
配收入和
(元)
城镇居民
人均消
费支出六
(元)
资料来源:中国统计年鉴》
24127 | 26467 | 28844 | 31195 | 33616 | 36396 | 39251 | 42359 | 43834 | 47412 | 49283 | 51821
17107 | 18488 | 19968 | 21392 | 23079 | 24445 | 26112 | 28063 | 27007 | 30307 | 30391 | 32994
35000
30000 全多
25000 3 4 多
20000 ee
15000
10000
5000
城镇居民人均消费支出〈元)
0 10000 20000 30000 40000 50000 60000
城镇居民人均可支配收入(元)
图 24-2 ”2012一2023 年我国城镇居民人均可支配收入和人均消费支出的散点图
用公式进行计算,可得两变量观测值的 Pearson 相关系数 r:
严
2 0)
全 (过 (入一了)
可以证明, Pearson 相关系数的取值范围在+1和-1之间,即-1和7<1。 若0一r友1,
表明变量革和了之间存在正线性相关关系;若 -1 和r < 0,表明变量X和了之间存在负线性
一 0.9941
人四”表中数据为统计软件导出 ,存在统计误差。一一编者注
' 220 ”经济基础知误(中级)
相关关系。若 =1,表明变量碟和了之间为完全正线性相关; 若 王-1,表明变量蒜和了之间为
完全负线性相关。可见,当|r|=1l 时,变量了的取值完全依赖于X; 当r=0 时,说明了和成之间
不存在线性相关关系。需要注意的是, Pearson 相关系数只适用于线性相关关系的判断。
此,r=0 只表示两个变量之间不存在线性相关关系,并不说明变量之间没有任何关系,比如它
们之间可能存在非线性相关关系。变量之间的非线性相关程度较大时,就可能会导致 王0。
因此,当z=0 或很小时,不能轻易得出两个变量之间不存在相关关系的结论,而应结合散点图
作出合理的解释。
根据实际数据计算出的,其取值范围一般为 -1 < > < 1。在说明两个变量之间的线性
关系的强弱时,根据经验可将相关程度分为以下几种情况: 当|r| > 0.8 时,可视为高度相关;
当0.5 < |r| < 0.8 时,可视为中度相关; 当0.3 < |r| < 0.5 时,可视为低度相关; 当|>| < 0.3
时 ,说明两个变量之间的相关程度极弱,可视为无线性相关关系。
零基础复习卡(两版教材核验)
来源核验:主教材《2026经济基础知识中级原书有色差(371)》PDF 第225-231页;《经济基础知识(中级)-292》PDF 第180-185页(书内第172-177页)。公式已对照主教材第225页原图复核。
一句话先懂
描述统计用“中心在哪里、数据散不散、分布歪不歪、两个变量一起怎么变”四个问题概括一组数据。
零基础解释
- 集中趋势:均值利用全部数据,但怕极端值;中位数只看排序后的中间位置,抗极端值;众数是出现最多的值,分类数据也能用。
- 离散程度:方差是离均差平方的平均,标准差是方差开平方;离散系数是标准差与均值之比,可比较量纲或均值不同的数据。
- 分布形态:偏态系数等于0为对称,大于0为右偏(长尾向右),小于0为左偏。标准分数把不同均值、标准差的数据拉到同一尺度。
- 相关分析:散点图先看形状,相关系数再量化线性方向和程度。相关系数只刻画线性关系,不证明因果。
必背清单
- 均值:`x̄=Σx/n`;中位数:排序后取中间位置;众数:频数最多。
- 方差越大越分散;标准差与原数据同单位。
- 离散系数:`CV=s/x̄`,通常写成百分数。
- 标准分数:`z=(x-x̄)/s`;`z>0`表示高于均值。
- 相关系数 `r` 的范围是 `[-1,1]`;符号表方向,绝对值表线性相关强弱。
- 教材经验判断:`|r|>0.8`高度相关;0.5-0.8中度;0.3-0.5低度;小于0.3线性相关极弱。
易混点
- 均值适用于数值型数据;中位数适用于顺序和数值型;众数适用于分类、顺序和数值型。
- 方差有平方单位,不便直接解释;标准差有原单位。
- 两组数据均值或计量单位差别大时,不宜只比较标准差,应比较离散系数。
- `r=0`只说明无线性相关,不等于完全没有任何关系。
- 正相关不是“数值都为正”,而是一个增大时另一个总体上也增大。
记忆口诀
- “均值用全体,极端会牵引;中位看位置,众数看次数”。
- “方差平方,标准同量纲;跨组比较看变异系数”。
自测题
- 单选:收入数据中有少数亿元级极端值,描述典型收入最稳健的是( )。A均值 B中位数 C方差 D相关系数
答案:B。 中位数对极端值不敏感。
- 判断:标准差的单位是原数据单位的平方。
答案:错。 方差是平方单位,标准差与原数据同单位。
- 计算:某人得分80分,班级均值70分、标准差5分,其标准分数是多少?
答案:2。 `(80-70)/5=2`,即高于均值2个标准差。
- 单选:比较“月工资”和“销售额”哪组波动相对更大,优先用( )。A极差 B方差 C标准差 D离散系数
答案:D。 两组量纲或均值不同,应看相对离散程度。
- 判断:相关系数为0,就能断定两个变量毫无关系。
答案:错。 只能说明没有线性相关,仍可能存在非线性关系。
- 单选:相关系数 `r=-0.92` 表示( )。A高度正相关 B高度负相关 C低度负相关 D因果关系
答案:B。 负号表方向,绝对值0.92表高度线性相关。
6刷题(章节配套练习,含校订与教学改编)
先做后看答案。单选点一下就判,多选选完点「核对答案」。错题自动进错题本,二轮会回来重做。
校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。
校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。
校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。
校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。
校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。
校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。
校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。
校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。
校勘说明:为明确统计定义、经验标准或教学条件所作的校订后教学题设,不冒充原题原文。
校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。
校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。
校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。
校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。
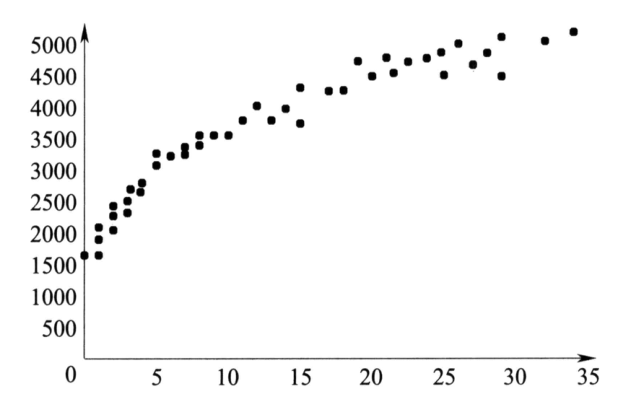
校勘说明:按《经济基础知识(中级)章节同步习题集-304.pdf》原PDF第191页题面、第194页答案复核修正;保留原题答案。图像为原PDF散点图裁剪,仅移除周边题文,未重画数据点。
校勘说明:为明确统计定义、经验标准或教学条件所作的校订后教学题设,不冒充原题原文。
校勘说明:为明确统计定义或适用条件所作的校订后教学题设,不冒充原题原文。
7本章打卡
做完一项勾一项,当天页会自动更新整体进度。
学完这章就是往前走了一步。记不住的,明天再来看必背,不用今天全记住。